今年2月,OpenAI干了件挺轰动的事:
把GPT-5接进Ginkgo Bioworks的云实验室。AI设计实验,机器人执行,结果回传,AI再设计下一轮。
六轮迭代,3.6万组反应配方,一种标准蛋白的生产成本直降40%。人类只需配试剂、装卸板子、在旁边看着。
但论文里藏着一个细节:真正驱动机器人干活的代码,不是GPT-5写的,是Ginkgo的工程师写的。他们明确说,不让GPT-5碰执行代码。
也就是说,AI会「想」实验,还不会「做」实验。它只能在人类划好的框里活动。
Anthropic也下场了,他们建了湿实验室,10月底还买下一家只有一个员工的biotech——创始人靠Claude编排11家外部实验室做药。
几乎同一周,OpenAI买了做药物研发编排的Orchestra Bio;Google把AI智能体直接接上了实验台的机器人。
一夜之间,科技巨头们达成了同一个共识:光有聪明的大脑不够,得给AI配一个能动手、能反馈的真实世界。
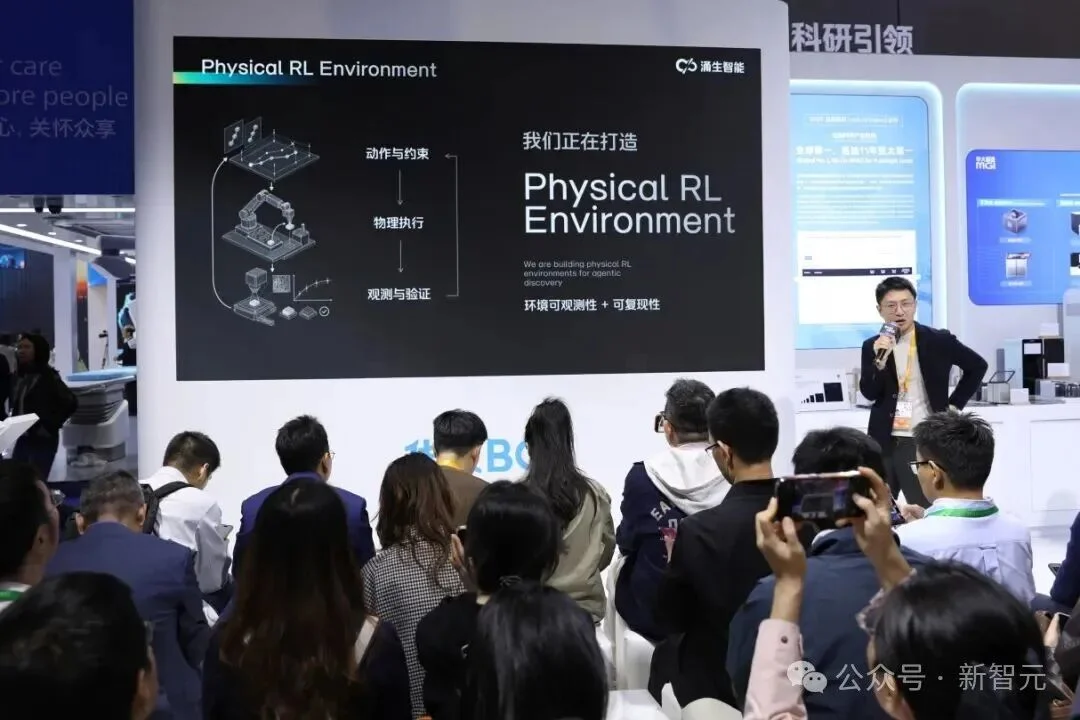
11月6日,上海进博会,涌生智能出牌了。
在「智能基座,世界共生」主题活动上,华大智造上午先官宣了测序仪AI Ready,下午由子公司涌生智能发布云端自主实验室SE-Fab-SynBio。
这个实验室干的事,说起来很简单:
AI说「我想验证这个」,实验室就真的做一遍,然后把结果交还给AI——不光是结果,还带着实验条件、过程记录和质量信息。AI拿着这些,接着设计下一轮。
一句话概括:别人还在给AI配实验室,这边已经把实验室变成了AI的训练场。
而且不是PPT,平台已经上线开放预约,还先拿自家测序仪里要用的酶,跑出了结果。
AI一天能想100个点子
实验室可做不完
一名研究工业酶的科学家,想找到一种更耐高温的酶。
过去怎么办?泡几周文献,凭经验挑几个方向,一轮一轮做实验。
现在有了AI,几分钟就给你甩出上百个候选方案。
然而你一转头,实验室设备在排队,试剂还没备齐,做实验的同事已经三个课题并行。AI这边假设产得飞快,实验那边压根接不住。
更要命的是,AI给的候选大部分注定被淘汰。
一组真实的结合实验数据:AI设计了1,320个候选蛋白,最后只有354个表现出目标结合活性。剩下73%,同样耗光了表达和纯化的资源。
这就是AI for Bio眼下撞上的现实。
生物学不是数学,证明对了不算完;一种酶耐不耐高温、一种蛋白能不能跟靶点结合,只有真实实验能给答案。
模型说「我觉得行」不算数,现实世界回答「它确实行」才算。
卡在这里的,不只是高校课题组:做模型的AI团队手里有设计、没实验室;Mithril那样的精简biotech,整条研发线都架在外部CRO网络上。
科研的瓶颈,正在从「想不出来」变成「验不过来」。
全球云实验室的兴起,就是冲着这个新瓶颈来的。
不是实验外包
是给AI造一个「真实世界」
一听「云实验室」,很多人第一反应是:在电脑里模拟实验?
恰恰相反。它借的是云计算的思路——
云计算让你不用自己建机房,云实验室让你不用自己建实验室。真正的培养、反应、检测,依然发生在实体实验室里。
但涌生智能给SE-Fab-SynBio的定位,比「共享实验室」野心大得多:训练科学大模型的物理强化学习环境。
搞AI的都懂:强化学习就是模型做个动作,环境给个反馈,模型据此调整,再来。下棋的环境是棋盘,自动驾驶的环境是道路,生命科学AI的环境,就是实验室。
用他们自己的话说,核心价值就是给AI当verifier:让AI跟真实实验世界交互,拿回可信的数据反馈。
就在11月6日,OpenAI又发布了一个值得关注的研究:BioBasicsBench。
这次不是考AI懂多少生物知识,而是直接拿100项真实湿实验数据,考它能不能看懂实验结果、识别错误、做出正确判断。
结果GPT-6 Astra在最高档推理设置下,平均只拿到66.7%的可得评分;GPT-5.6 Sol更是只有43.8%。即便是GPT-6,仍会忽略关键实验对照、选错菌落,甚至把菌落数量高估约12%。
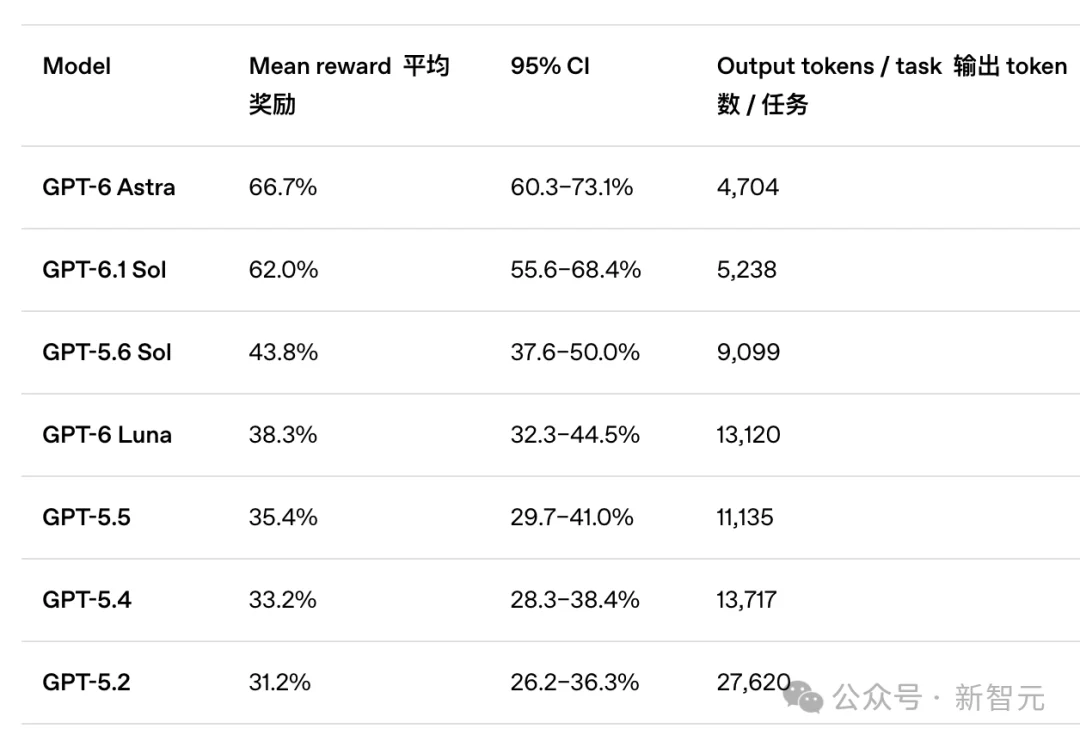
最前沿的基础大模型,距离可靠理解真实生命科学实验,仍有明显差距。
问题来了,怎么让AI真正跨过这道坎?
光靠继续学习文献、扩大模型参数还不够。它需要真实的实验数据,需要知道自己哪里判断错了,更需要一个能不断试错、验证、获得反馈的物理环境。
这恰恰是涌生智能的核心定位:不是再造一个更大的生物模型,而是为科学大模型提供突破智能上限所需要的真实数据和物理强化学习环境。
而且,这套基础设施不只服务于基础科学研究,也能为AIDD(AI驱动药物研发)中的分子优化、虚拟细胞预测与校准提供真实的实验执行和验证环境。
AI负责提出假设,真实实验负责检验假设,再把成功与失败的数据交还给AI,让下一轮设计更有依据。
模型负责变聪明,云实验室负责让它接受真实世界的检验。
到这你可能会问:这不就是实验外包换了个说法?
Mithril那个案子,恰好把答案说得很清楚。
一个人、一个模型、十一家CRO。Claude不摸试管、不养细胞,干的是编排:读文献、拆计划、清洗各家CRO回传的数据、起草邮件。
Anthropic技术报告里有个细节:一份341页的CRO数据包,113个抗体构建体的结果,Claude花8分钟整合完,创始人据此砍到89个,Claude再花4分钟重排物料清单和实验计划。
湿实验一点没被替代,全在外部实验室做。AI吃掉的是跨组织的协调成本:邮件往来、数据格式对齐、跨CRO进度追踪。
但反过来想:为什么会有341页的数据包要整?为什么11家实验室要靠邮件对齐?
因为传统外包的交付物就是一份报告,格式各异,条件和过程信息散落在附件里,AI读得费劲,人核得也累。
涌生智能提供的,正是这种「一人+AI+外部实验室网络」架构缺的那一层:CRDMO基建。
实验能力像云服务一样网上下单;已有的研发工具和AI智能体直接走程序接口接进来;平台按研究问题组合标准化实验模块;返回的不是一摞PDF,而是结果加上理解结果所需的条件、过程和质量信息。AI能直接读,下一轮能直接用。
一份报告是终点,一轮反馈是起点。Mithril们需要的,不是再多一家CRO,而是一个能直接接AI的实验底座。
从一句「我想验证什么」,到AI自己跑闭环
还是那位找酶的科学家。
AI帮他筛出20个候选方案,接下来他只需做一件事:告诉云实验室「我想验证什么」。
实验团队跟他确认目标、材料、方案,再按任务调度对应的设备和流程。跑完之后,结果连同条件、过程、质控信息一起打包返回。
为什么要打包这么多?
因为同一个数字,在不同条件下可能是完全不同的意思。两个候选有差异,是分子本身的差异,还是温度、测量方法造成的?哪些要复测,异常从哪一步来?没有过程信息,AI学不到东西,人也不敢信。
还有一点容易被忽略:失败也是有价值的交付物。只要记录完整,一次失败也能帮你排除错误方向。
科研里,搞清楚一条路为什么走不通,有时比盲目往前冲更值钱。
这条路,涌生智能自己先跑了好几轮——而且挑的不是练手题,是华大智造自家产品里真要用的酶。
测序用的DNA聚合酶,28天完成3轮迭代,测序错误率降低37%;RNA合成用的PUP聚合酶,25天3轮迭代,热稳定性指标Tm提高3.4℃。自发光测序用的GLuc荧光素酶、基因编辑用的脱氨酶,也都跑过多轮。
那AI这一侧呢?回到开头那道坎:为什么连OpenAI都不敢让GPT-5写执行代码?
因为从「想」到「做」,中间隔着一整条转换链:科学意图→实验方案→标准操作流程→设备代码→物理执行,任何一层出错,实验就可能报废。
而大多数实验室对AI来说是个黑箱:全靠人手操作,流程写在纸上和脑子里,数据散在各处。AI在这里,既没有手,也没有眼睛。
所以涌生智能做的第一件事,是把实验室改造成「AI能用的身体」——
设备能被代码驱动,AI才有手;流程数字化,AI才听得懂实验语言;湿实验结果能回流成数据,AI才睁得开眼。
身体有了,大脑也得配上。
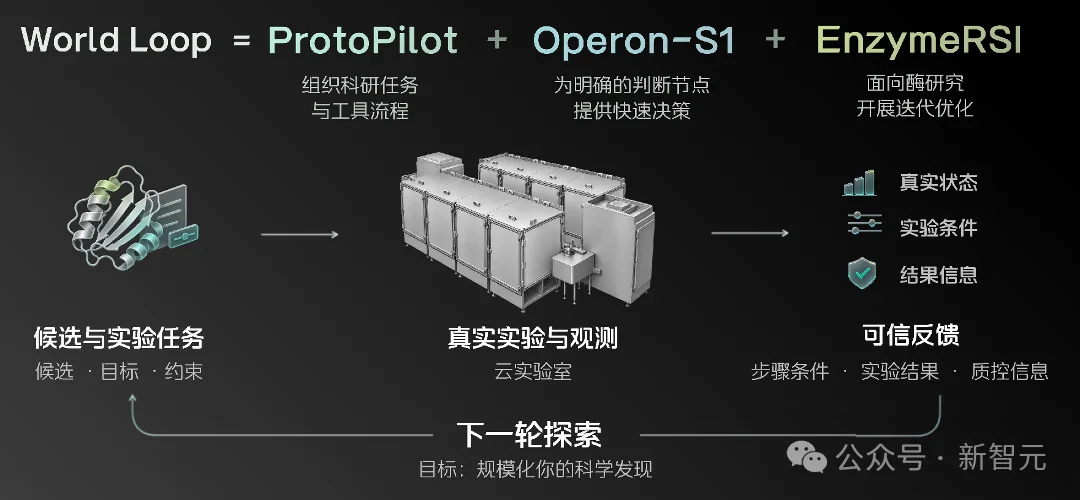
这次一起亮相的,还有涌生智能面向科学智能体的循环进化系统World Loop,由三个部分组成——
ProtoPilot负责「精细执行」。你用自然语言告诉它「帮我构建8个GLuc突变体」,它就能把这句话拆成实验方案,转成可执行代码,下发到物理设备,再根据湿实验反馈自动修正。
它真的会从失败里学:论文里有个案例,DNA组装实验在转化环节出了异常,ProtoPilot自己诊断出是抗性筛选失效,改完方案再跑一轮。跑分也够猛:ProtocolQA拿到76.85%,逼近人类专家的79%;「方案变代码」通过率88.2%,是设备厂商自家AI工具的近三倍。
Operon-S1负责「快速决策」。流程里选项明确、标准清楚的节点,不用大模型慢慢想,它直接拍板。
EnzymeRSI负责「进化」。它专攻酶工程,拿着实验反馈,用优化算法迭代下一轮要测哪些候选、方案怎么调。
配套的还有一套考官BioLab Bench:不考知识问答答对多少,考的是你设计的流程,机器人到底跑不跑得通。
把这几样拼起来,闭环就转起来了:
World Loop提出候选酶和要验证的性能;研究者确认方案;云端自主实验室执行,把每个候选的结果连同条件、过程、质控信息返回;World Loop据此判断哪些要复测、哪些值得继续优化,再提交下一轮任务。
这正是GPT-5在Ginkgo没能做到的那一步:不是人替AI写代码、递结果,而是AI自己出方案、自己转成设备能执行的代码、自己拿反馈、自己改。人只负责确认方向。
模型可以买,踩过的坑买不到
涌生智能,凭什么做AI的强化学习环境?
是从实验台上的真问题开始的。
前面那些酶,都是自家测序仪里要用的,闭环是在解决自己产品问题的过程中跑通的,不是为发布会搭的样板间。
真问题也最挑人。从模型提出候选,到选对验证指标,再到让设备按方案把实验跑完,每一步都得有东西垫底——AI研发上的积累、对生命科学的理解、实验室自动化上的经验,少一样闭环就转不起来。
这三样,涌生智能都不是临时凑的:测序和实验室自动化的工程化积累来自母公司华大智造,AI和生命科学两头的理解,是一篇一篇 AI4S 文章积累下来的,也是在自家酶的问题上一轮一轮磨出来的。
顶级大模型人人都能调用,模型这一侧正在被迅速拉平。
但「物理那一半」——真实设备、真实失败、真实约束,不能下载,没法复制,只能一次次在实验台上试错积累。
当模型人人都有,差距就落在谁手里攥着「真实世界这一侧」。
华大智造首席AI官、涌生智能CEO杨梦博士在发布现场说:「每一轮实验积累的数据与知识,都可以为下一轮判断与设计提供依据。我们将从合成生物学出发,逐步拓展到更多生命科学场景,推动AI科学发现走向规模化。」