


近日,面壁智能自研的 AI 算子生成系统 ForgeKernel 在国内外算力生态的官方评测中,同时登顶华为 CANNBench 950DT、950PR、A3 三大硬件榜单以及英伟达 SOL-ExecBench(FlashInfer-Bench 合集),让同一套通用算子优化系统,同时打通两条硬件路线。
在 950DT 榜单上,ForgeKernel 以总分 3903.96 排名第一,领先第二名(2846.61)37.1%;基准加速比 1.523×,约为第二名(0.305×)的 5 倍;平均分 70.98,提交算子 55/60。
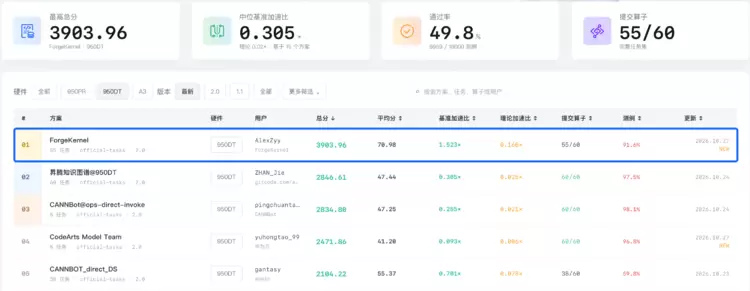
Forgekernel 登顶 CANN Bench-950DT 榜单,2026.10.27
在 950PR 榜单上,ForgeKernel 以总分 3736.44 排名第一,领先第二名(3552.34)5.2%;基准加速比1.886×,约为第二名(1.181×)的 1.6 倍,这意味着在同等硬件投入下,可用算力接近翻倍,企业的算力采购与部署成本可相应降低约一半;平均分 74.73,提交算子 50/60。
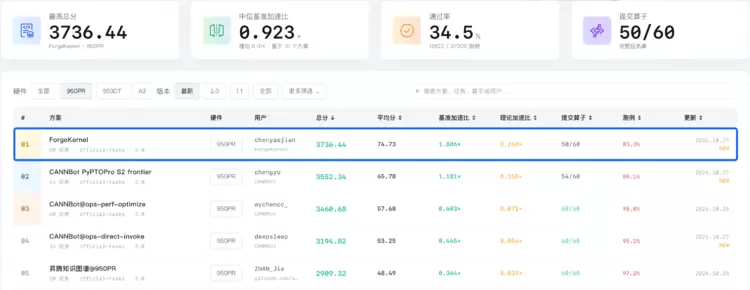
Forgekernel 登顶 CANN Bench-950PR 榜单,2026.10.27
在 A3 榜单上,ForgeKernel 以总分 4338.67 排名第一,领先第二名(4049.50)7.1%;基准加速比1.894×,约为第二名(1.463x)的 1.3 倍;平均分 74.80,提交算子 58/60。
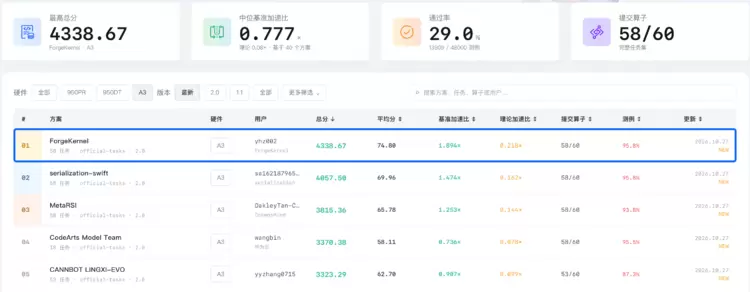
Forgekernel 登顶 CANN Bench-A3-2.0 榜单,2026.10.27
在英伟达 SOL-ExecBench 上,ForgeKernel 以 SOL 分数 0.814101 排名第一,同榜参赛者还包括 SF Tensor、Databricks、Qwen、Cursor 等海内外团队
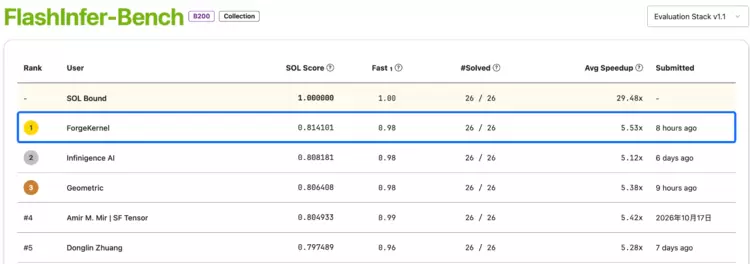
Forgekernel 登顶 英伟达 SOL-ExecBench(FlashInfer-Bench 合集)榜单,2026.10.27
算子是连接大模型与芯片的最后一公里。长期以来,高性能算子依赖资深工程师逐一手写调优,周期长、门槛高,是芯片性能释放的关键瓶颈。尤其是新一代国产芯片 950DT:硬件新、配套算子库尚在建设初期,人工适配周期长,而 ForgeKernel 率先完成适配并登顶。这验证了另一条路:新硬件上市之初,AI 就能快速产出高质量算子,让国产算力第一时间跑出真实性能。国产芯片从上市到做好适配之间的空窗期,正在被 AI 大幅压缩,硬件投入得以更快转化为真实可用的智能算力。
成绩背后,是面壁智能在 RSI 方向上的长期投入。ForgeKernel 不设置固定流程,而是让模型自己根据经典实现与专业知识完成架构设计;通过持续迭代实现自进化,不断改进架构设计,以期进一步突破;并长期沉淀每次迭代过程中的算子经验与硬件知识,持续提高算子智能体的优化能力。
此次登顶四大榜单,是面壁智能长期研究与工程投入的阶段性结果。从高效基座大模型到 RSI 工程体系,面壁智能走的是同一条路线:让 AI 制造 AI,打造大模型的“光刻机”,用一套完整的工程体系,把模型能力持续雕刻出来。未来,ForgeKernel 将拓展至更多芯片平台与算子场景,面壁智能 RSI 也将在更多环节释放价值。