


继向企业客户开放第三方模型后,豆包工作进一步扩大了用户的模型选择范围。
就在刚刚,豆包工作正式宣布,平台接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并同步推出限时优惠活动。
用户可以根据不同任务的需求,自主选择相应模型完成工作。
随着越来越多的大模型进入实际办公场景,用户在处理编程、文档写作、数据分析等任务时,对模型能力、响应速度和使用成本的要求也有所不同。
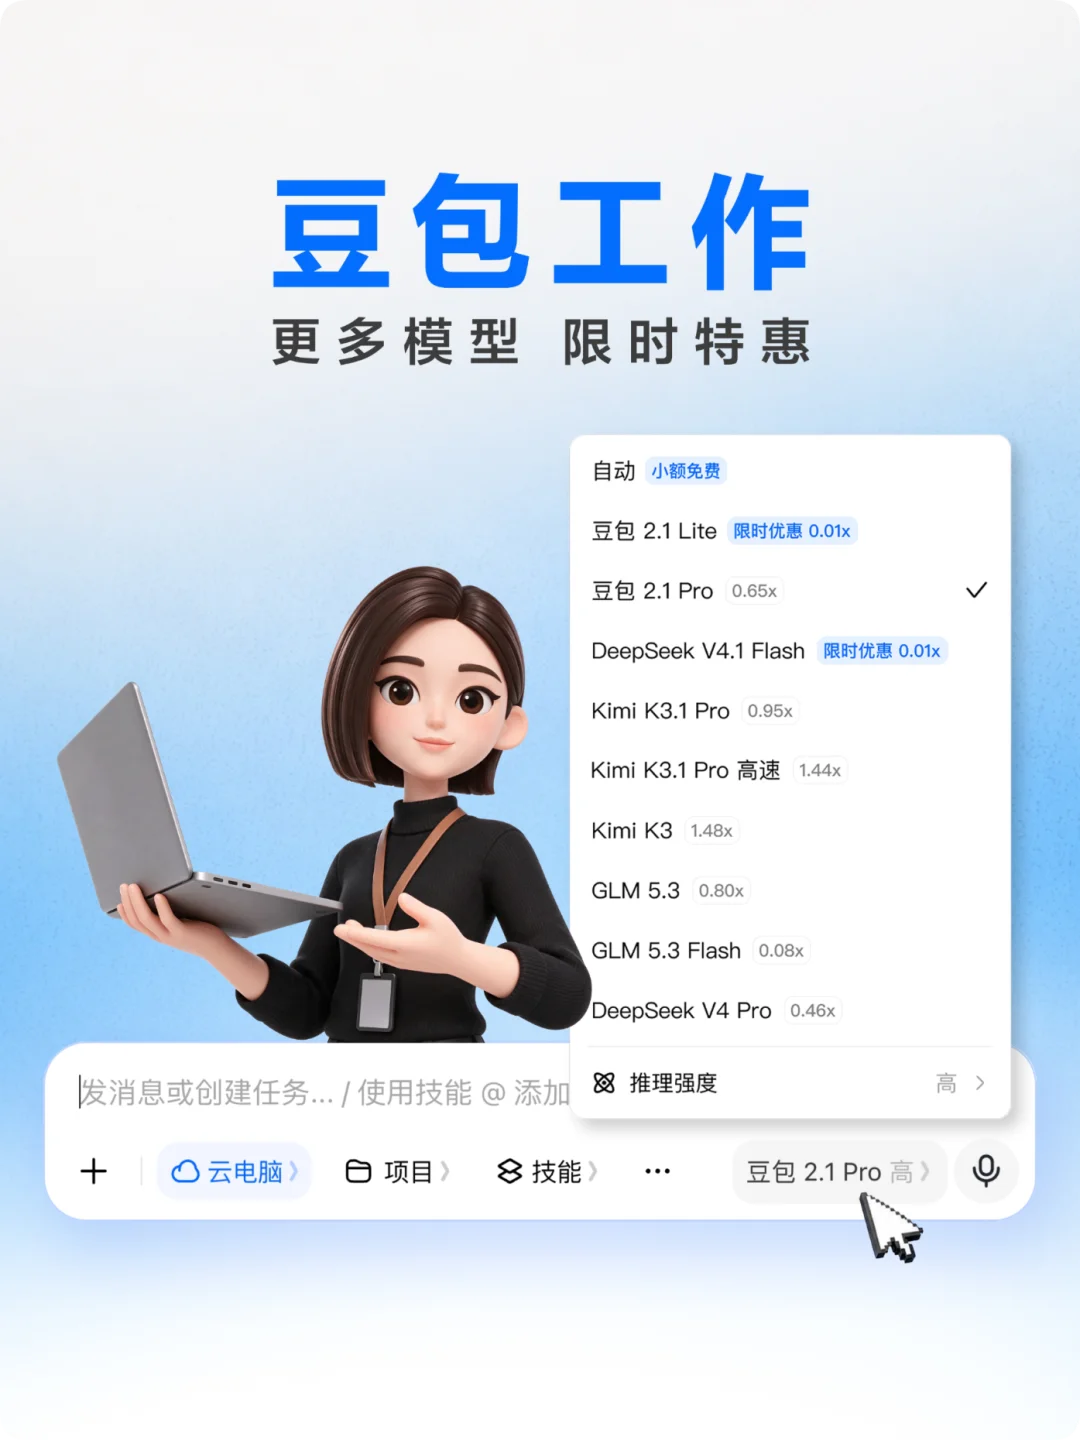
此次更新意味着,豆包工作进一步丰富了平台内的模型选择,让用户能够在同一个工作平台上使用不同厂商提供的 AI 模型,减少频繁切换工具的麻烦。
值得注意的是,除了增加模型数量,豆包工作还调整了模型额度消耗的展示方式。
此前,豆包工作已经面向企业客户开放第三方模型。此次更新后,平台在模型选择页面进一步标注了各款模型的额度消耗倍率,方便用户直观了解不同模型的使用成本。
按照官方说明,模型的额度消耗倍率越低,通常意味着相应的模型调用成本越低。用户可以结合任务复杂程度、模型能力及额度消耗情况,选择适合自己的模型。
在价格方面,豆包工作还宣布推出全新的限时优惠计划。用户在工作日及节假日的指定优惠时段内,使用参与活动的模型,还可以享受额外的额度消耗优惠。
与此同时,豆包工作已经针对豆包 2.1 Lite 和 DeepSeek V4.1 Flash 下调了额度消耗倍率。在处理相同任务时,两款模型所需消耗的额度将进一步减少,让用户能够使用现有额度完成更多任务。
从开放第三方模型,到展示各模型的额度消耗倍率,再到通过限时优惠降低使用成本,豆包工作正在尝试让模型选择成为办公产品中的一项常规功能。
当越来越多的 AI 模型都能在同一款产品中调用,单一模型的能力优势之外,平台能够提供多少模型选择,以及能否让用户以合理的成本使用这些能力,也将成为影响用户体验的重要因素。
文章来自于"APPSO",作者 "APPSO"。