


RSI这么火,它真的能让AI的进步速度快到无限吗?
Jeff Dean的判断是:不太现实。
他举了个例子:一个人启动实验,凌晨2点实验结束,他要等到早上8点回到工位,才会查看结果。
自动化系统可以省掉这段等待,及时决定下一轮做什么。但训练、计算、保存数据、评估结果,这些步骤仍然需要时间。
要构建基座模型并提升它,仍然需要大量训练和实验,这些过程不可能以无限快的速度完成。
近期,在斯坦福HAI(以人为本人工智能研究院)与李飞飞的对谈中,Jeff Dean谈到了RSI的限制,也披露了自己的新公司正在做的事情。
全程还是非常谷歌姐夫的极简PPT风……
据他介绍,新公司Discovery Loop已有约20个自动改进循环在运行,也搭建了支持人和Agent共同工作的协作框架。
他们想让少量专家带着大量Agent做研究,目标是把领域专家的生产力提高20到50倍。
为了搭起这支团队,前三周,他们就在咖啡馆等地方进行了400场面试。
他还透露,一位Kimi K3论文的合著者、同时也是Attention Residuals工作的作者,最近加入了公司。
这位新同事,应当就是17岁的陈广宇。
聊到支撑这些变化的技术,Jeff Dean也承认自己有些事情看走眼了。
其中一件,就是编程。
在Gemini项目里,编程原本就是团队关注的方向之一。但他没有充分预见,这项能力会如此深刻地影响模型解决各种问题的能力。
他还曾期待,神经网络会长出更多奇特、不规则的结构,这条演进路线也没有完全按他的预想展开。
谈到AI做数学,他认可机器生成证明的价值,但他更看重人类能否从这些结果中理解并提炼出可以继续使用的方法。
以下为这场演讲与对谈的中文整理,经润色。
Enjoy~
Jeff Dean主题演讲:AI自己跑实验,目标是让专家生产力提高20-50倍
把实验循环自动化
很高兴今天能和大家在一起。我要介绍Discovery Loop。
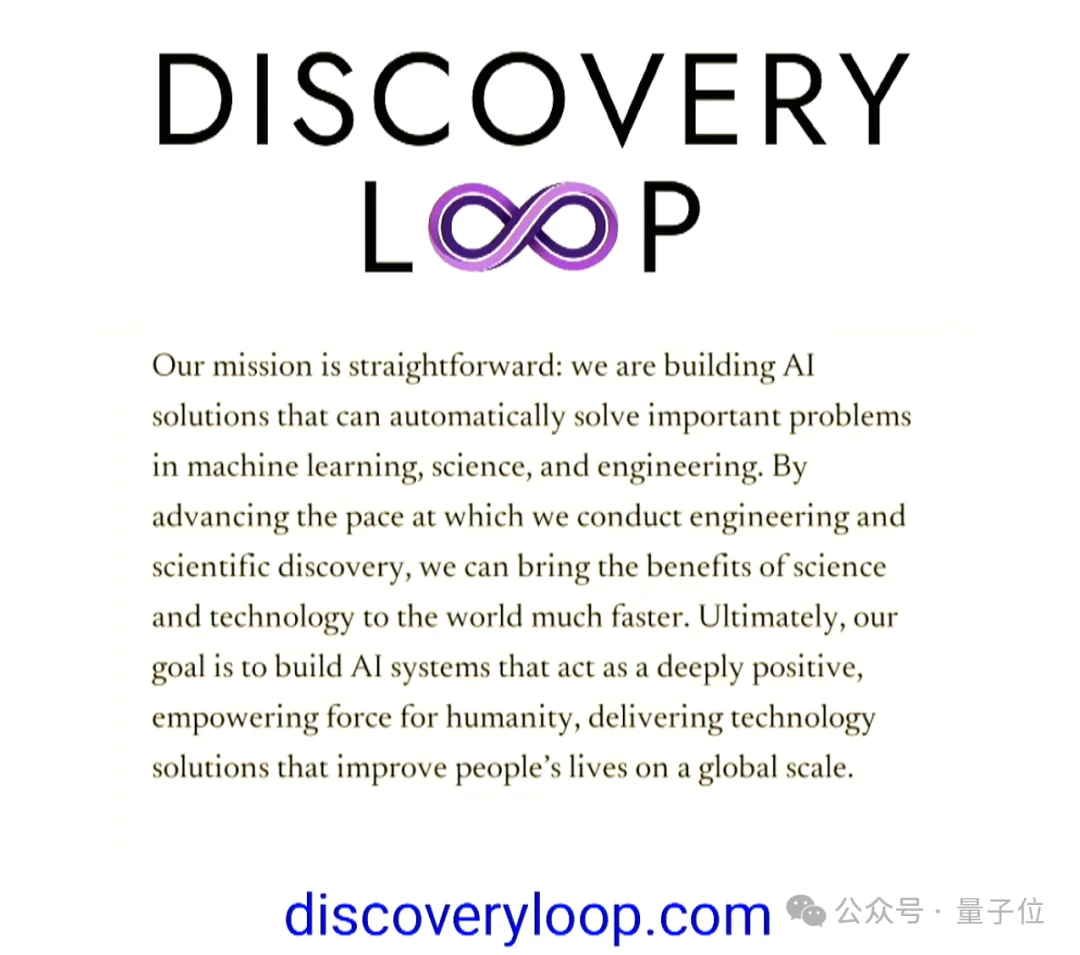
我们的使命是构建AI系统,让它们自动解决机器学习、科学与工程领域的重要问题。
我们相信,这最终会带来更多发现,也是我们感到兴奋的地方。
很多学科都有一个共同的过程,可以称为科学与工程的通用循环:提出实验方案,实施并运行实验,观察结果,检查各项测量数据,然后决定下一步做什么。下一步往往就是再做一次实验。
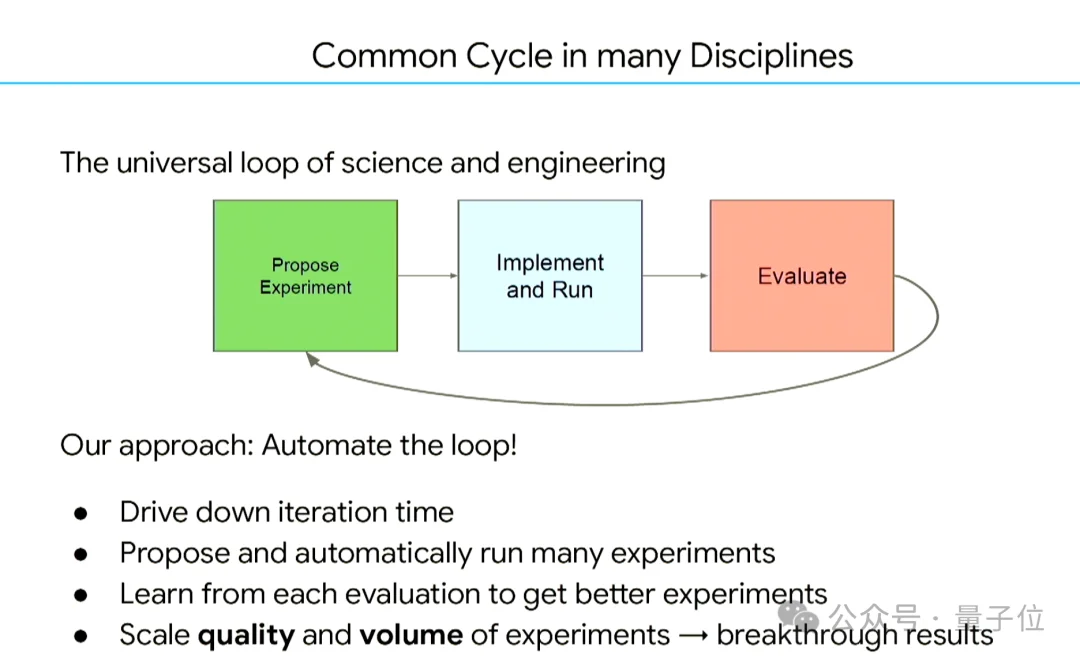
我们的思路是把这些实验循环自动化。我们相信,如果能缩短每轮迭代的时间,自动提出并运行大量实验,再从每次评估中学习,让后续实验借鉴此前的结果,同时提高实验的质量和数量,就会获得突破性的成果。
这就是我们想做的事。
看看这份美国国家工程院的重大挑战清单。这些都是21世纪需要解决的重要问题,而这个世纪已经过去了大约四分之一。
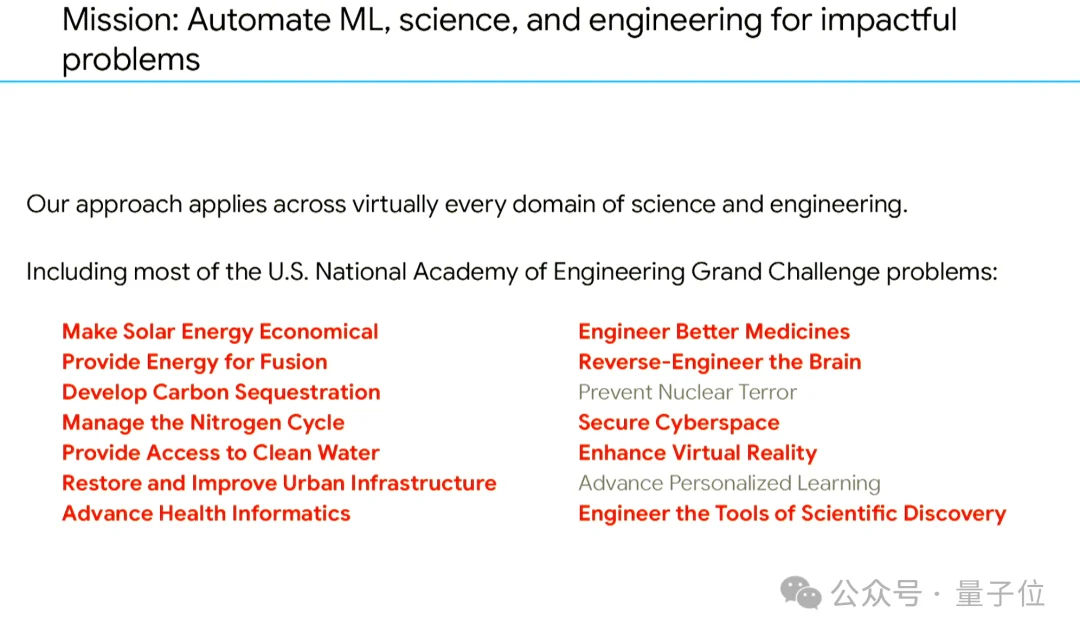
想想解决它们需要攻克哪些子问题,尤其是图中标红的那些领域,我们认为自动化发现循环能够提供帮助。
为什么成立公益公司
有一点对我们很重要,也是我们成立独立公司的部分原因:如果方法得当,技术能够给世界带来很大的积极影响,但需要大家共同努力,才能确保这种影响发生。
所以,我们将公司设立为公益公司,也就是Public Benefit Corporation。
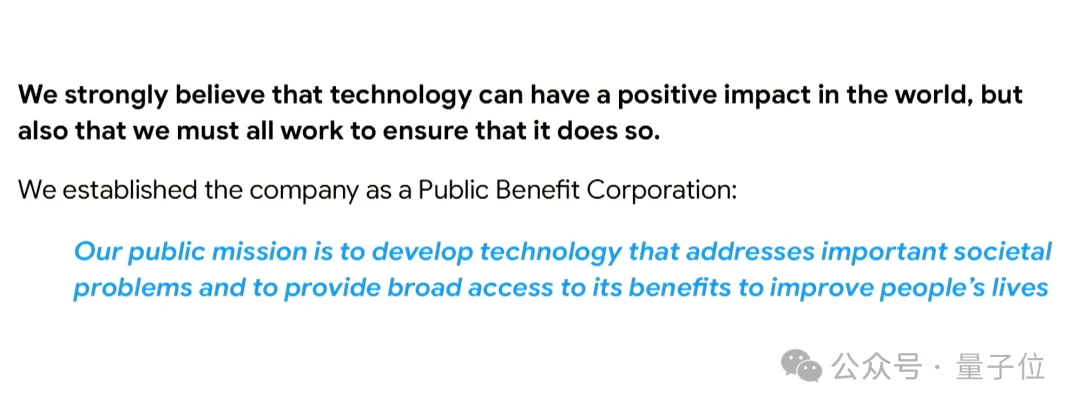
我们的公共使命是开发应对重要社会问题的技术,让更多人获得这些技术带来的益处,改善人们的生活。
四位创始人的经历
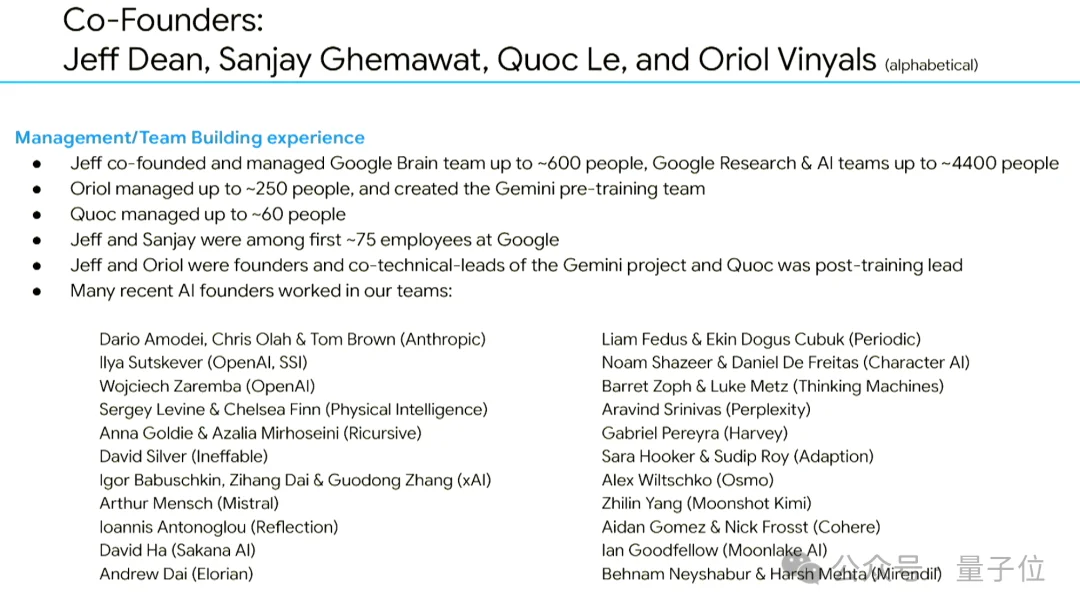
简单介绍一下我们四个人。我的三位联合创始人是Sanjay Ghemawat、Quoc Le和Oriol Vinyals。
按两两合作的关系来算,我们共事了14到30年。我们很享受一起攻克难题,也积累了不同方面的经验。
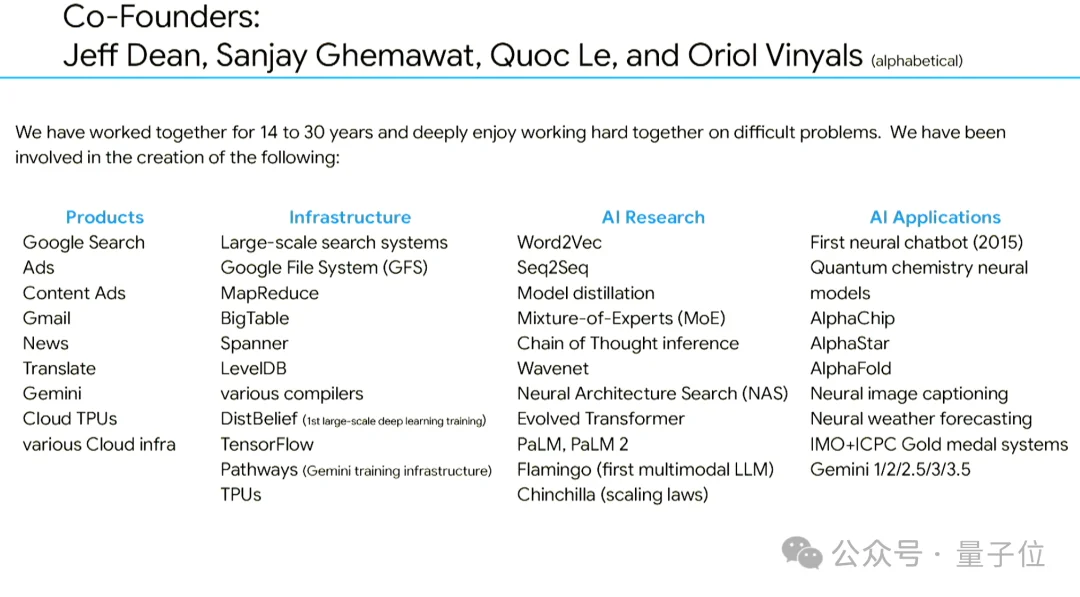
我们都来自Google,所以这里展示的工作都与Google有关。我们参与过多代搜索产品、早期广告系统、内容广告,以及Gmail、News和Translate等产品。
第二列是基础设施。上半部分的系统帮助人们组织和管理海量数据,运行大规模计算,从中获得有价值的信息。
下方四项则是多代大规模机器学习基础设施,用来训练能力越来越强的模型。我们也参与过TPU这种面向机器学习的专用硬件。
在AI研究方面,我们参与过今天许多高能力模型的重要技术,包括模型蒸馏、混合专家模型,也就是MoE,以及神经架构搜索。
神经架构搜索可以看成自动化实验循环的早期形式:寻找适合解决某类问题的神经网络架构。
我们还做过AI在不同领域的应用,其中也包括科学研究。我和Quoc参与过AlphaChip,用强化学习进行芯片设计,包括布局布线。
Oriol参与过AlphaFold和神经网络天气预测。我们在经验上有不错的互补。
我们也管理过很大的团队。我管理的Google Brain团队最多有600人,Google Research和AI团队最多有大约4400人。
后来我发现,自己在讨论第二季度运营费用的会议上花了太多时间。我按下一封邮件的发送键,把自己从管理4400人变成了只有4个汇报对象。
接下来一周,Geoff Hinton退休了,于是我只剩3个汇报对象。
再后来,Oriol和我共同担任Gemini项目的技术负责人,Quoc负责后训练。
我们也很为那些曾在团队里工作、后来做出出色成绩的人感到骄傲,其中包括Anthropic、OpenAI、Physical Intelligence等公司的创始人。Physical Intelligence在斯坦福应该挺有名。
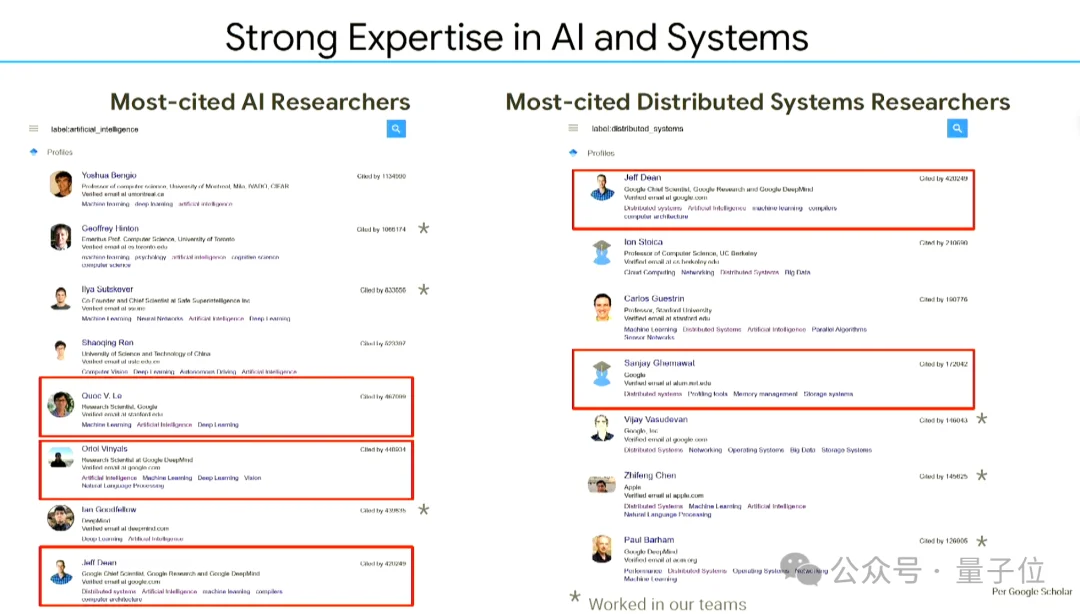
我们的经验结合了AI研究和分布式系统。
这张图依据Google Scholar引用量列出了AI和分布式系统领域的一些高被引研究者,红框里是我们,带星号的人也都曾在我们的团队工作。
团队建设与招聘
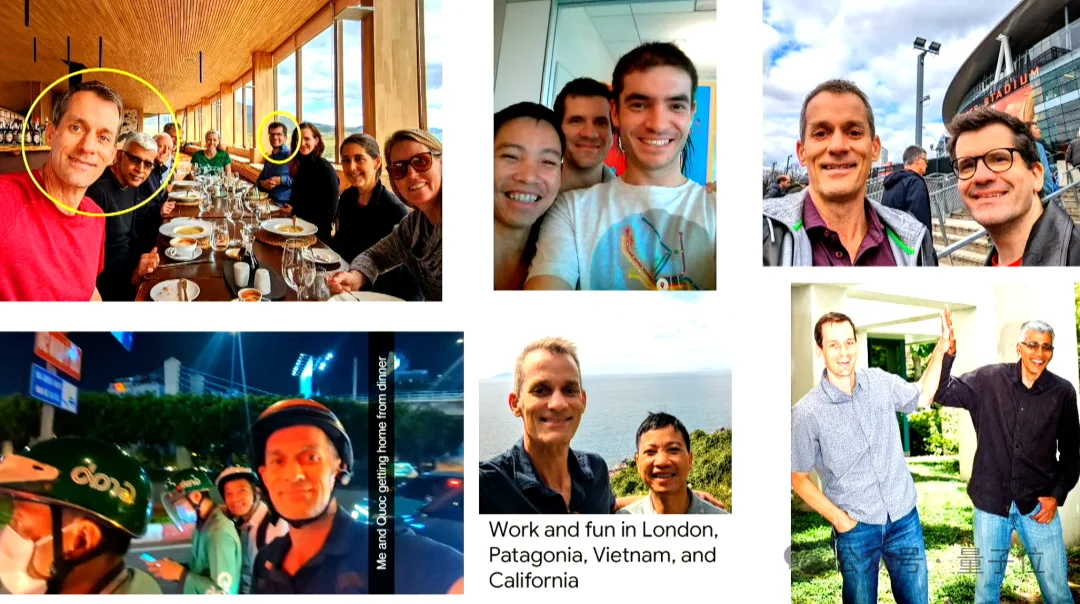
我们在一起也很开心,一起去过很多地方。照片里有伦敦、巴塔哥尼亚、越南,还有加州。
Quoc和我有一次吃完晚饭,乘坐类似Uber的摩托车服务回住处。
公司成立后的第一个阶段,我们花了很多精力组建创始团队。大家来自不同地方,你们可以看到图上的标志。许多人有创办公司或主导重要项目的经验。
团队里有领导Go语言项目的经验,也有Gemini、DeepSeek、Kimi K3等项目的重要贡献者。Kimi K3论文的一位合著者,同时也是Attention Residuals工作的作者,最近加入了我们。
〔注:此处应指陈广宇,17岁前Kimi研究员。〕
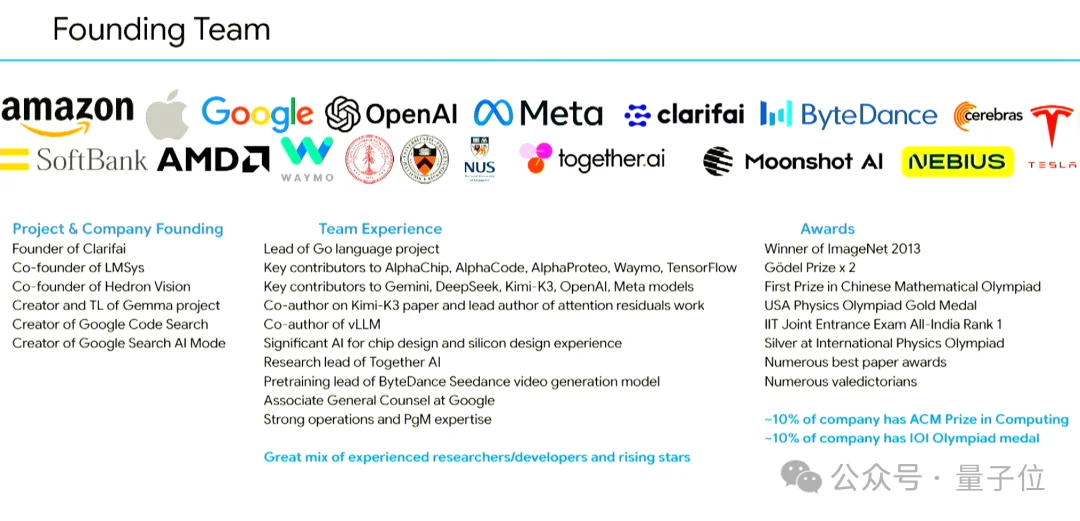
我们的团队既有经验丰富的人,也有职业生涯早期正在崛起的新星。公司大约10%的人获得过ACM计算奖,10%的人获得过IOI,也就是国际信息学奥林匹克竞赛的奖牌。
我们很期待与这些人共事,也很看重大家一起工作的能力。
为什么现在可以做这件事
为什么是现在?因为前沿模型已经有了很强的能力。这来自过去10到15年AI领域多个层面的创新。
硬件性能有了很大提升,包括TPU、GPU和其他更专用的硬件。软件抽象也改进了,人们更容易实现自己想做的事,并把计算更高效地映射到硬件上。
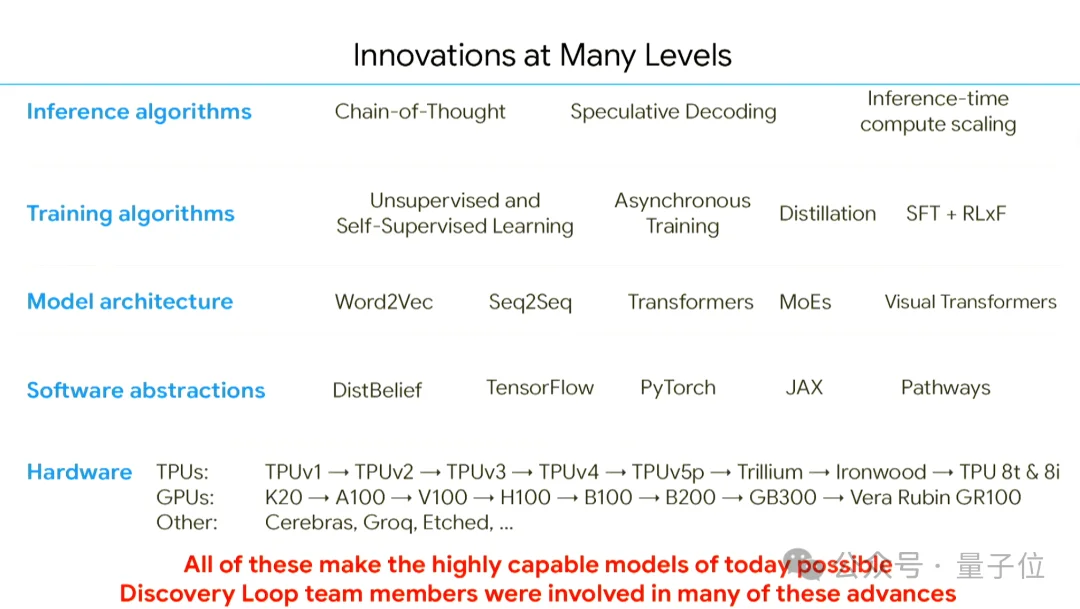
模型架构也在演进,例如word2vec、序列到序列模型、Transformer和MoE。训练算法有了很多进步,蒸馏等技术让较小的模型也能取得很好的效果。
推理算法同样进步很大。我们可以在推理阶段投入更多计算来获得更好的结果,例如使用思维链,或者尝试多种解题方法,再检查结果。
模型需要工具、创造力与经验积累
仅有强大的基座模型,还不足以解决我们想处理的那些问题。我们需要从优秀的基座模型出发,结合智能体,使系统能够有效使用工具,完成复杂任务。
我们尤其希望智能体和模型具备创造力。科学或工程上的突破,往往需要把不同洞察组合起来,提出新的东西,再检验效果。
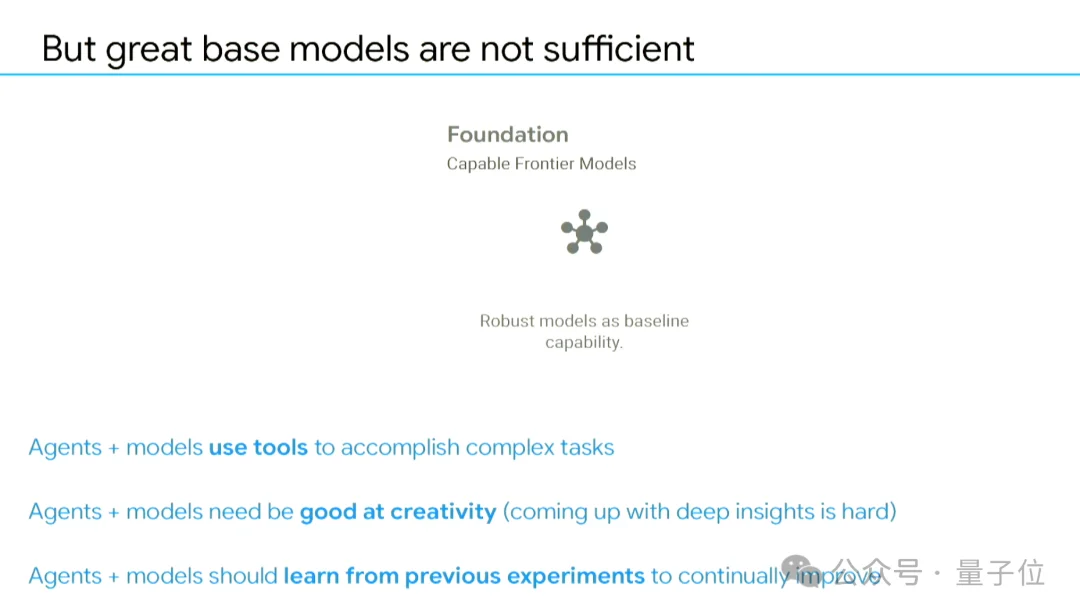
这些系统还应该从过去的实验和经验中学习。这既包括解决当前问题时的学习,也包括长期积累。
假设一个系统已经解决过5000个问题,那么面对第5001个问题时,它就可以借鉴与新问题最相关的那些经验。
大项目的难点还在于分工与协调
传统实验循环的每个阶段都需要大量人工。
面对更大的问题时,事情会更复杂,因为你通常要把它拆成很多子问题或子模块,拆解本身就是一道难题。
每个子领域里又有许多人运行实验,判断哪些方法有效、哪些无效。
这会带来协调开销、资源冲突,以及大规模系统层面的问题。拆解问题很难,整合各个子问题的结果也很难。
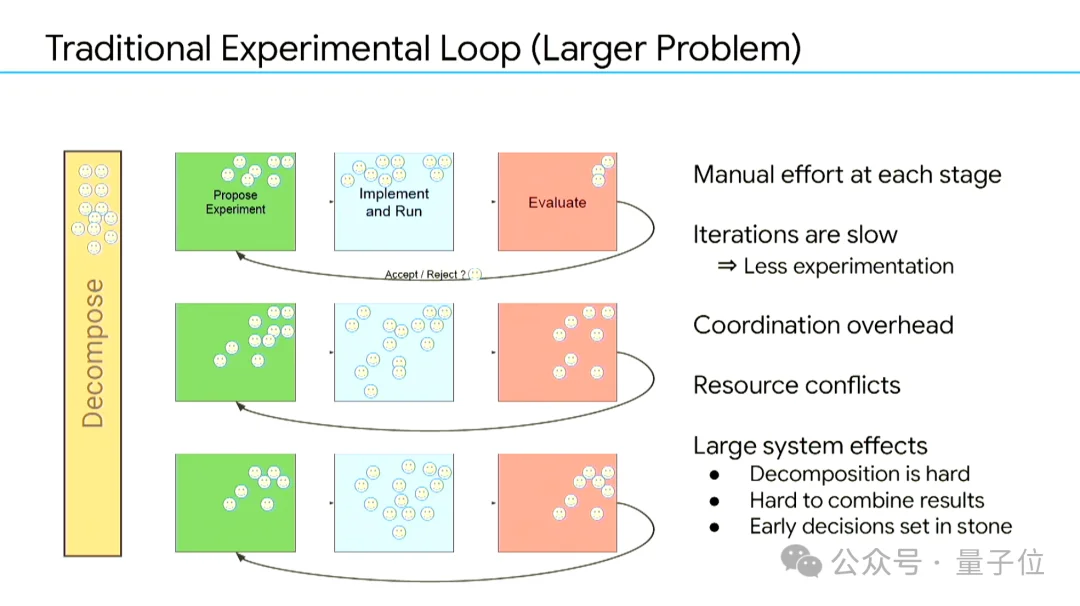
更麻烦的是,大型项目一旦运转起来,当初的拆解方式就很难改变了。无论是制造飞机,还是训练前沿模型,都很难再灵活调整早期的决定。
我们认为,可以让少量领域专家配合自动化系统来工作。理想情况下,系统能自动拆解出值得研究的子问题,并自动求解。
当然,也可能需要人来引导拆解,判断哪些子问题最重要。
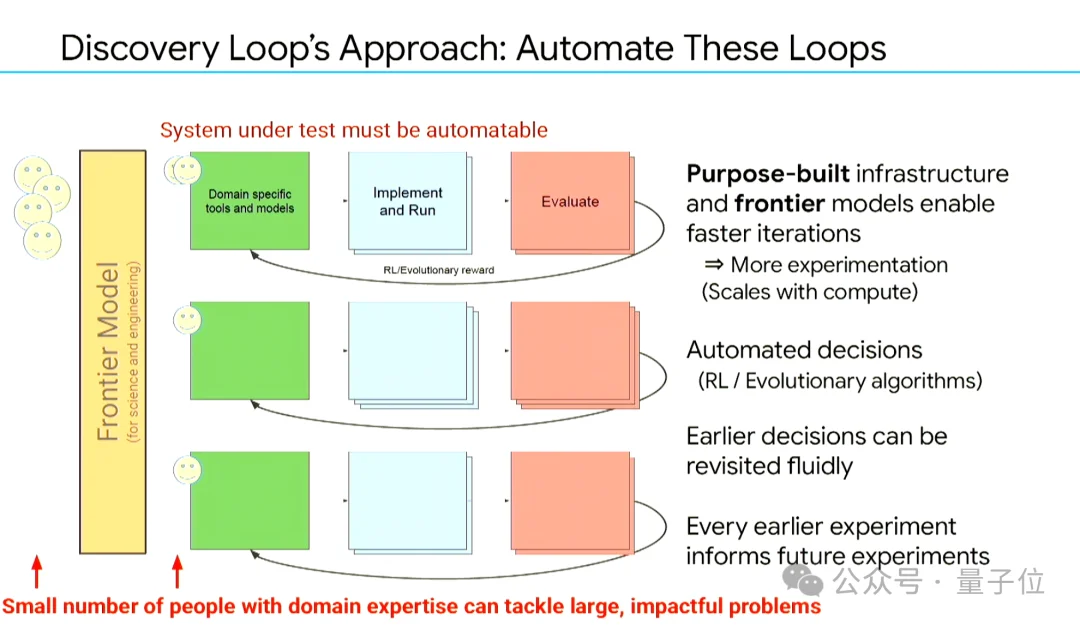
这样,少数有领域专长的人就能处理大型、有影响力的问题。我们相信,合适的基础设施可以支持这种工作方式。
你需要运行数万个自动实验,也需要系统理解不同实验的价值,决定下一步做什么。
强化学习或演化算法可以用于自动决策,让此前的决定更容易重新评估。每一个早期实验,都应该为后续实验提供信息。
已有约20个自动改进循环在运行
我们目前做了什么?
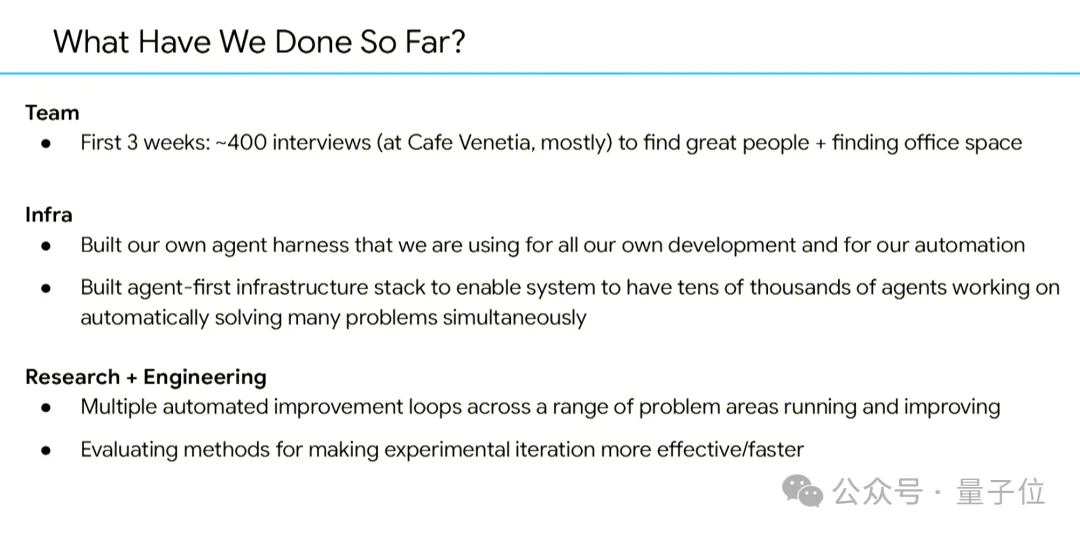
前三周,我们进行了400场面试,大多在University Avenue的Cafe Venetia,寻找前面提到的那些人才。
我们也在找办公场地,现在搬进了原来Zibibbo餐厅的旧址,空间挺有特色。
我们搭建了自己的智能体运行框架,也就是agent harness,用于内部开发和自动化。
它有一些很好的协作功能:你可以和模型对话,请它解决问题,也可以邀请同事加入,让两个人一起与模型和智能体交流。
其他人可以对正在开展的工作发表评论,在方案交给智能体之前提出设计意见。
我们的基础设施从一开始就面向智能体来构建,目的是能够扩展到数万乃至数十万个智能体执行任务,而不只是支持数百人工作。我们认为这一点很重要。
现在大约有20个自动改进循环在运行,我们能看到它们在运行、在改进。
我们也在评估怎样让这些实验迭代更有效、更快,怎样利用此前的实验结果和测量数据,让系统学习得更快。
目标是让领域专家生产力提高20到50倍
这就是我们现在的状态:搭建软件循环,自动化机器学习任务,因为我们认为这能够推动更多自主科学研究。
最初,我们聚焦于构建能够解决机器学习研究和机器学习工程问题的自动化系统。
我们的目标是让领域专家的生产力提高20到50倍。
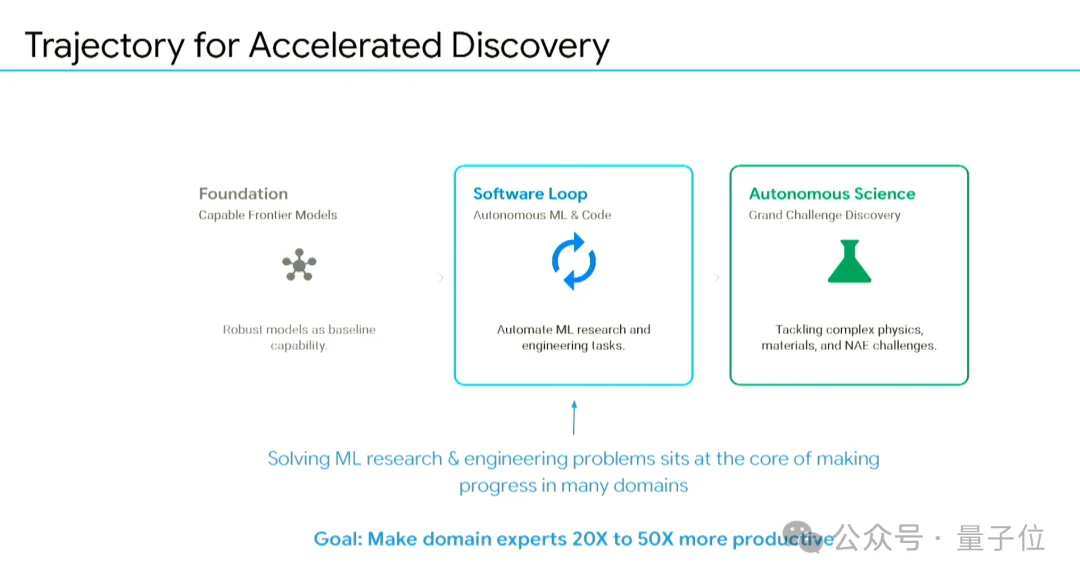
我们希望这些领域专家,以及真正想解决某类问题的人,能够用更少的精力把问题解决。人在其中仍然有自己的作用。
过去15年的机器学习突破带来了强大的模型,也为自动化机器学习、科学与工程,进而加快发现速度创造了条件。谢谢大家。
对了,我们在招聘,可以到discoveryloop.com申请。
Jeff Dean对谈李飞飞:RSI也有物理极限,蒸馏论文当年被嫌没影响力
为什么离开Google创业
李飞飞:谢谢Jeff,这是一场很棒的演讲。我想这应该是最后一场,我们正好夹在观众和茶点之间。
Jeff Dean:这从来都不是个好位置。
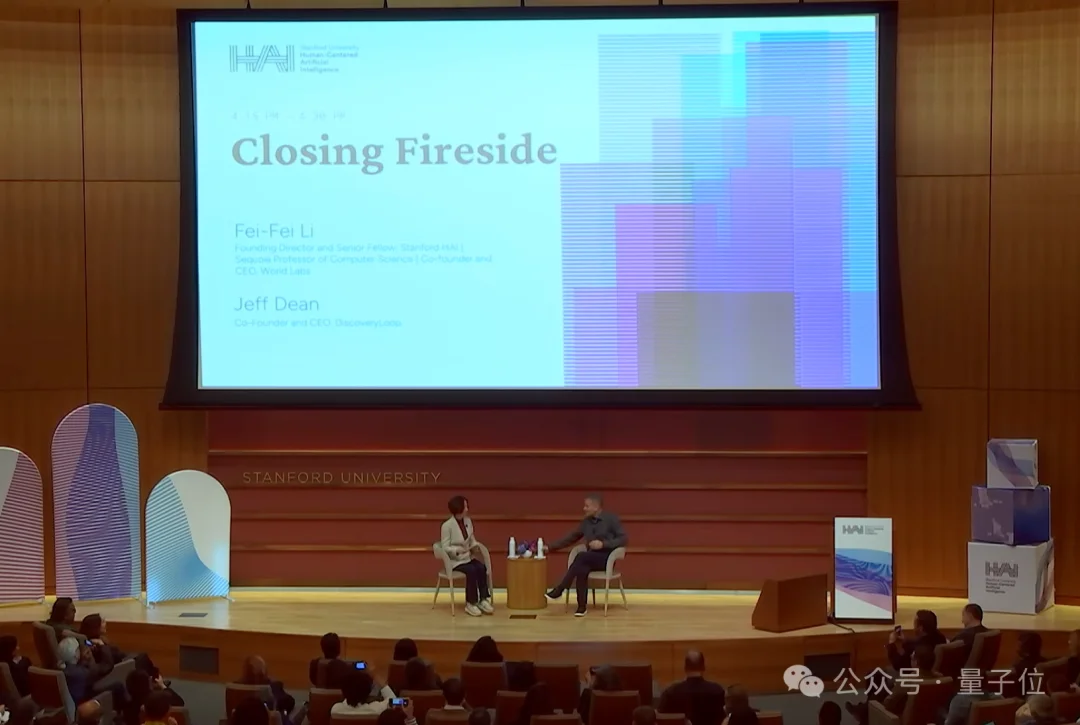
李飞飞:我本来希望这场讨论能更技术一些。不过既然是一场对谈,我会同时承担提问和参与讨论的角色。
谢谢你的演讲,我的第一个问题本来就是:为什么创办Discovery Loop?恭喜你。
Jeff Dean:谢谢。
李飞飞:你们四个人基本都在Google工作了很长时间,尤其你在1999年就加入了Google。
过去几年的技术进步大家有目共睹,但我还是好奇,有没有某个时刻,可能是在过去一两年里,让你、Quoc、Sanjay和Oriol觉得,必须做点不一样的事,而且需要离开Google来做?