


前段时间,我们做了一个开源项目 Vector Graph RAG,尝试只用 Milvus 向量数据库实现知识图谱的多跳检索,省去额外部署图数据库的麻烦。
最终,项目的召回效果不错,但还有一个小问题是:检索过程中需要调用LLM筛选知识图谱中的关系,导致查询速度被严重拖慢。
于是,9 月 Jev 发布后,我们开始尝试用这种擅长快速判断相关性的决策模型,接替原本由 LLM 完成的rerank工作。没想到,第一次直接替换虽然加快了检索,召回质量却有所下降。
在此基础上,我们又设计了新的方案——两阶段 Jev 检索:先筛选图谱中的关系,再对找回的原文重新排序。结果超出了最初只想加速检索的预期。
最终,在 MuSiQue 和 2Wiki 两个多跳问答数据集、共 2,000 道问题上,新方案的平均 Recall@5 达到 86.61%,取得了本次所有对比方案中的最高召回率(SOTA)。同时,两阶段 Jev 方案还站上了质量与延迟的帕累托前沿(Pareto Frontier):不仅召回效果超过了所测试的 LLM 重排方案,额外模型调用耗时也更短。
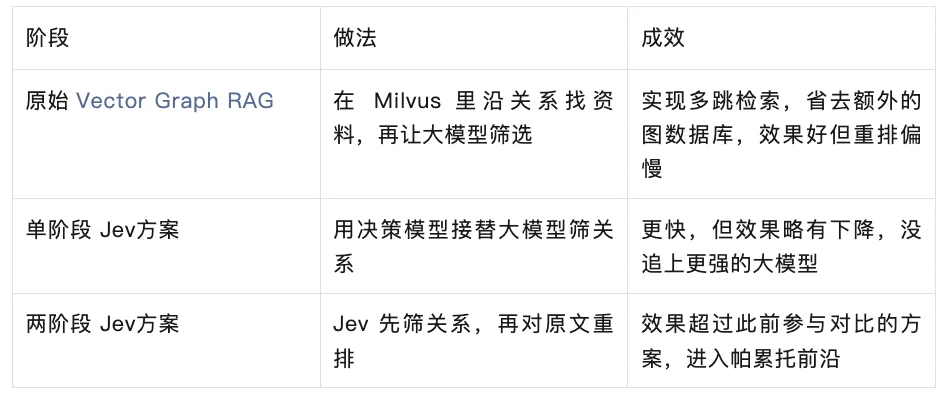
那么如何通过检索流程的调整,实现召回率6%的提升?增加一轮Jev判断,又是如何做到比LLM的最终结果更优的?
下面就从原版 Vector Graph RAG 开始,介绍这次优化的完整过程。
01
原版 Vector Graph RAG:省掉了图数据库,但 LLM 重排成了瓶颈
一开始,我们做 Vector Graph RAG,想解决复杂多跳问题中的推理与证据召回问题。
普通 RAG 通常只能依靠向量相似度,从知识库中找出与用户问题语义接近的文档,再交给大模型生成答案。这种方式在简单问答中很好用,但如果答案需要跨越多段资料、经过几步关联才能找到,单次向量检索就容易漏掉关键证据。
举个例子。假设用户问:
「2 型糖尿病的一线用药,有哪些需要注意的副作用?」
知识库里恰好有两段资料:一段介绍二甲双胍是 2 型糖尿病的一线用药,另一段介绍二甲双胍的不良反应。
但用户的问题里没有直接出现「二甲双胍」,那段只围绕药名介绍副作用的资料,未必能在直接检索中获得足够高的相似度。
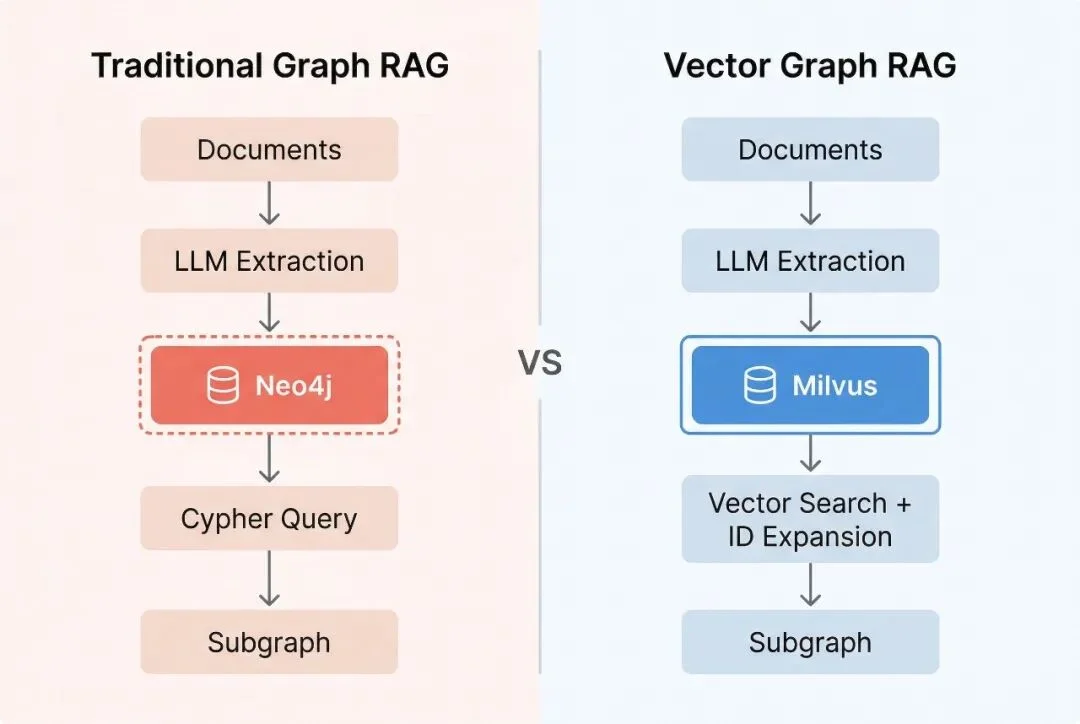
Graph RAG 就是解决这类问题的一种思路。它可以把文档中的实体和关系组织成知识图谱,然后同时结合实体关系与语义相似度,完成最终的检索。
这也导致传统 Graph RAG 在向量数据库的基础上,还需要额外部署图数据库来管理这些实体和关系。
我们希望简化这一套架构,因此在 Vector Graph RAG 中,将实体、关系和原始文档都存储在 Milvus 中,通过向量检索找到图谱中的起点,再利用 ID 关联完成子图扩展。这样,就能在不额外引入图数据库的情况下,完成基于知识图谱的多跳检索。
项目地址在:https://github.com/zilliztech/vector-graph-rag
想了解项目背景的朋友,可以参考之前的文章:https://mp.weixin.qq.com/s/O_3MS-pHts15Quqwev4MEg
具体来说,在数据准备阶段,系统会先从原始文档中抽取实体和关系,形成知识图谱。图中的节点代表实体,边代表实体之间的关系,每条关系还会记录自己来自哪段原文。
有了这些数据,查询时就可以沿着关系寻找证据。
整个过程分为四步。
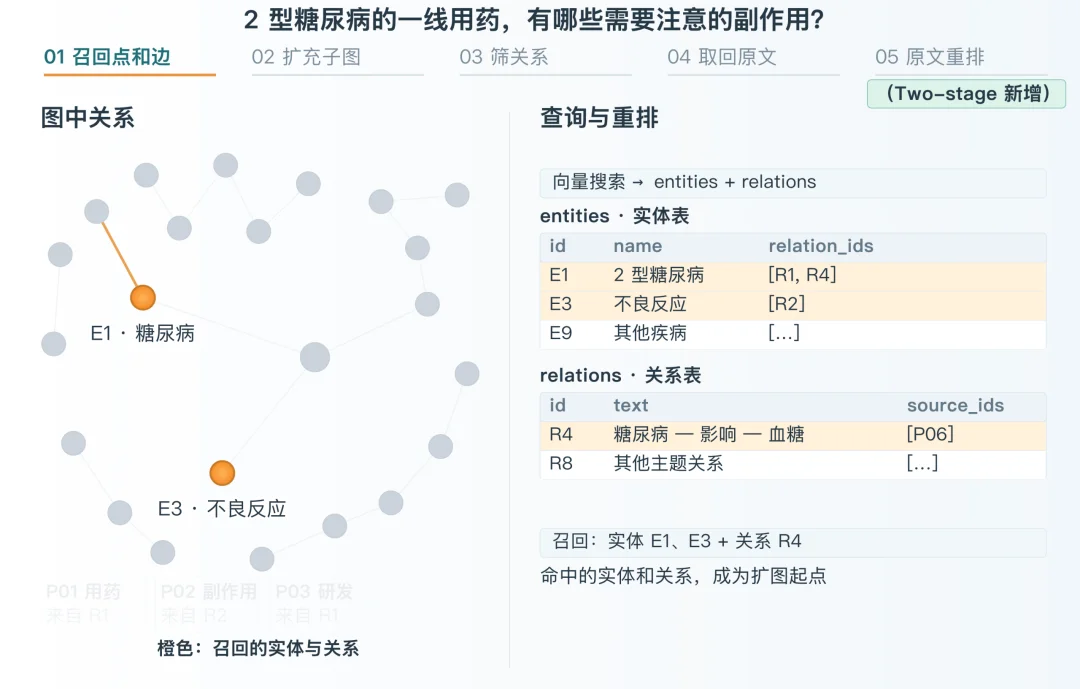
第一步,召回起始的实体(点)和关系(边)。
收到用户问题后,系统会同时进行两路向量检索:一路从问题中抽取实体,搜索图谱中语义相近的节点;另一路使用完整问题,搜索相关的关系。
对于刚才的糖尿病问题,假设我们找到了「2 型糖尿病」「不良反应」等实体,以及「糖尿病—影响—血糖」这样的关系。这些节点和关系,就是后续扩展图谱的起点。
第二步,沿着这些起点扩展子图。
接着,系统会通过 Milvus 中记录的 ID,继续查找与起始节点和关系相连的其他实体与关系。
比如,从「2 型糖尿病」可以找到一线用药「二甲双胍」,再进一步找到它与「不良反应」之间的关联。
到这里,原本没有出现在用户问题中的药名,就被带进了检索范围。
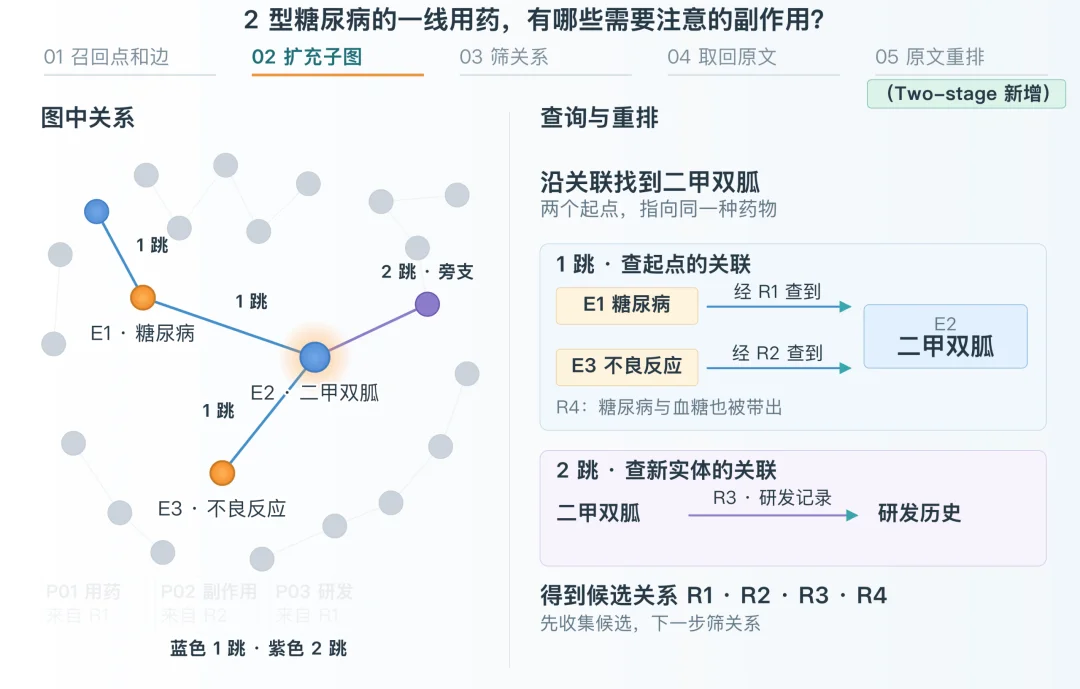
但沿关系扩展也有副作用:它会把很多旁支信息一起带出来。
除了需要的一线用药和副作用资料,图谱里可能还有药物研发历史、其他疾病关联等噪声信息。随着扩展范围增大,这些候选关系的数量可能达到几百条甚至上千条,不仅增加上下文负担,还可能影响回答质量。
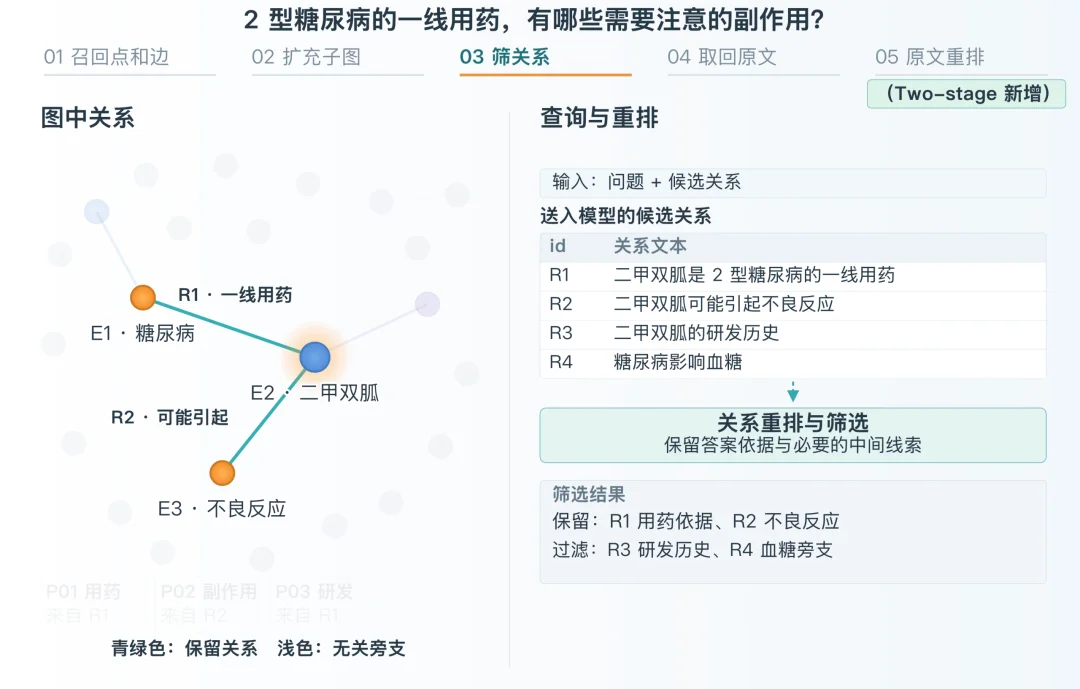
第三步,调用 LLM 筛选关系。
为了从扩展子图中排除无关信息,原版 Vector Graph RAG 会把用户问题和候选关系交给 LLM,让模型判断哪些关系值得被保留。
在这个例子里,二甲双胍与糖尿病治疗的关系,以及二甲双胍与不良反应的关系,都是有用的线索;药物研发历史等无关分支,则可以被过滤。
第四步,根据留下的关系取回原文。
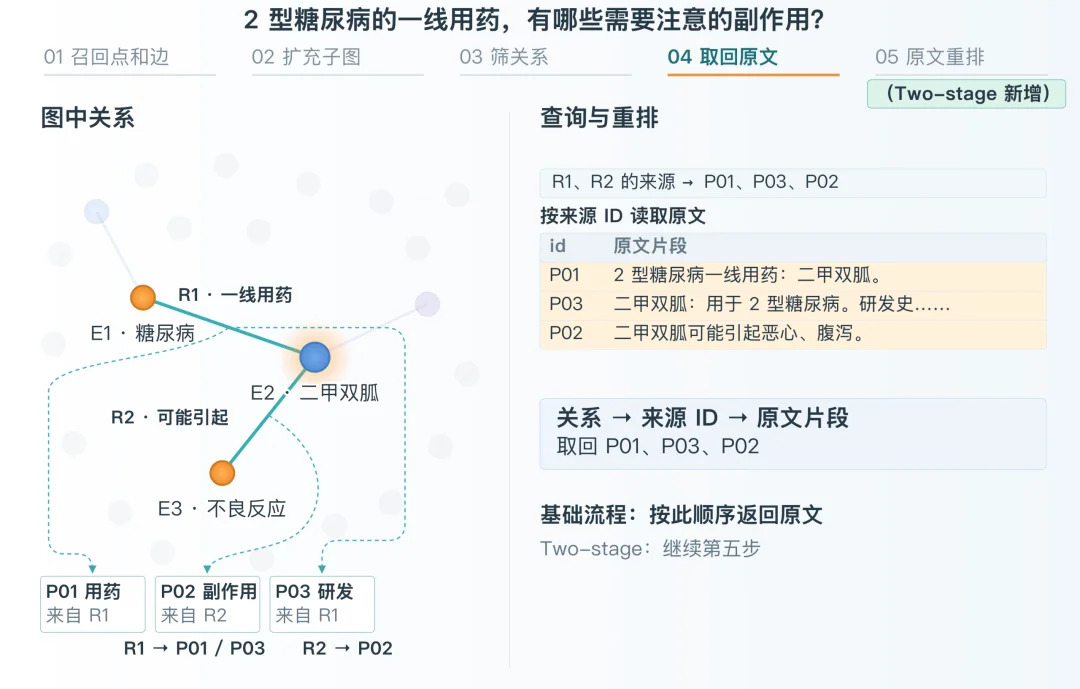
我们最终需要的还是原始资料,而不是图谱中的三元组。因此,关系筛选结束后,系统会根据保留关系记录的来源 ID,回到 Milvus 取出对应的文档片段。
例如,假设关系 R1 对应原文 P01、P03,关系 R2 对应 P02,那么系统就会把这三段资料取回来,供后续回答使用。
经过这四步,原版的Vector Graph RAG 就完成了从实体发现、关系扩展到原文召回的过程,在省去了额外部署图数据库麻烦的同时,也能取得不错的多跳检索效果。
但在实际使用中,我们发现检索速度还有明显的优化空间。
问题主要出在第三步,用 LLM 对关系做重排时。尤其在扩图产生大量候选关系时,大模型需要读取这些关系,再输出筛选结果,等待时间就会变得尤为明显。
所以,我们开始寻找一种更快的方式来完成这项工作。
02
单阶段 Jev:直接替换重排的得与失
9 月,Jev 发布后,我们第一时间想到了用它来替换原版 Vector Graph RAG 中的 LLM 重排。详见这篇文章:
Jev 是一类面向判断任务的决策模型。对于检索场景,它可以根据用户问题,快速评估候选内容是否相关,没有生成式 LLM 那样的大段文字解释,成本更低、效率也更高。
但是用Jev替换掉大模型重排之后,我们很快发现:Jev 直接重排关系的召回效果虽然超过了 GPT-4o-mini,却没有追上 GPT-5-mini。尤其遇到 MuSiQue 数据集中较复杂的多跳问题时,差距更加明显。
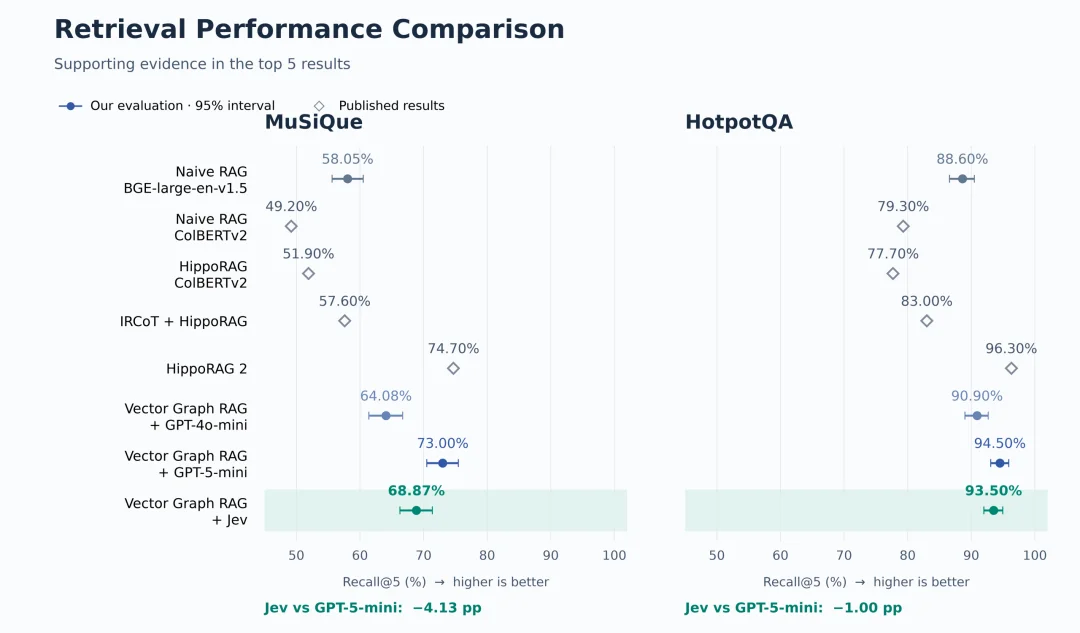
我们当时考虑过一个原因:Jev 这类决策模型擅长快速判断,但复杂的知识图谱关系有时需要结合多条线索进行推理。相比之下,具备推理能力的 LLM 在处理复杂关系时可能更有优势。
不过,Jev直接替换大模型重排的效果没有达到预期,也让我们开始重新审视整个检索流程。
仔细看原版方案会发现,前期我们一直在筛选关系,但用户最终需要的其实是原文。关系相关,并不代表它对应的每一段原文都同样有用。
一条「二甲双胍是 2 型糖尿病的一线用药」的关系,可能来自一段治疗指南,也可能来自一篇药物研发历史文章。两段资料都能支持这条关系,但如果用户关心的是副作用,它们的价值显然不同。
而原版流程没有再区分这些原文。关系一旦被保留,对应的来源资料就会被取回来,至于哪些段落真正包含回答问题需要的细节,并没有再做一次专门判断。
当最终检索结果只有五个位置时,这种差异就可能影响召回指标。系统也许已经找到了关键关系,但真正有用的原文未必排得足够靠前。
这给了我们一个新的优化思路。
既然 Jev 能快速判断内容的相关性,除了让它筛选关系,能不能再让它直接判断一次原文?
于是,我们开始尝试两阶段 Jev。
03
两阶段 Jev:先筛关系,再挑选真正有用的原文
这次改造保留了 Vector Graph RAG 原有的实体召回和子图扩展方式,主要调整检索后半段。
新的流程中,Jev 会被调用两次:第一轮筛选知识图谱中的关系,第二轮重排原始文档片段。
其中,在第一轮做关系筛选时,会刻意给一些中间关系留位置。比如前面例子里的药名关联,虽然单独回答不了副作用问题,但后面还得靠它找到资料。筛完之后,再把把这些关系对应的来源原文取回来。同时,补进一路直接向量检索找到的原文,两路合并去重,组成一个小的候选集合。
第二轮 Jev 就看这些完整片段,判断哪些真正有助于回答,再排出最终结果。
仍然以糖尿病问题为例。
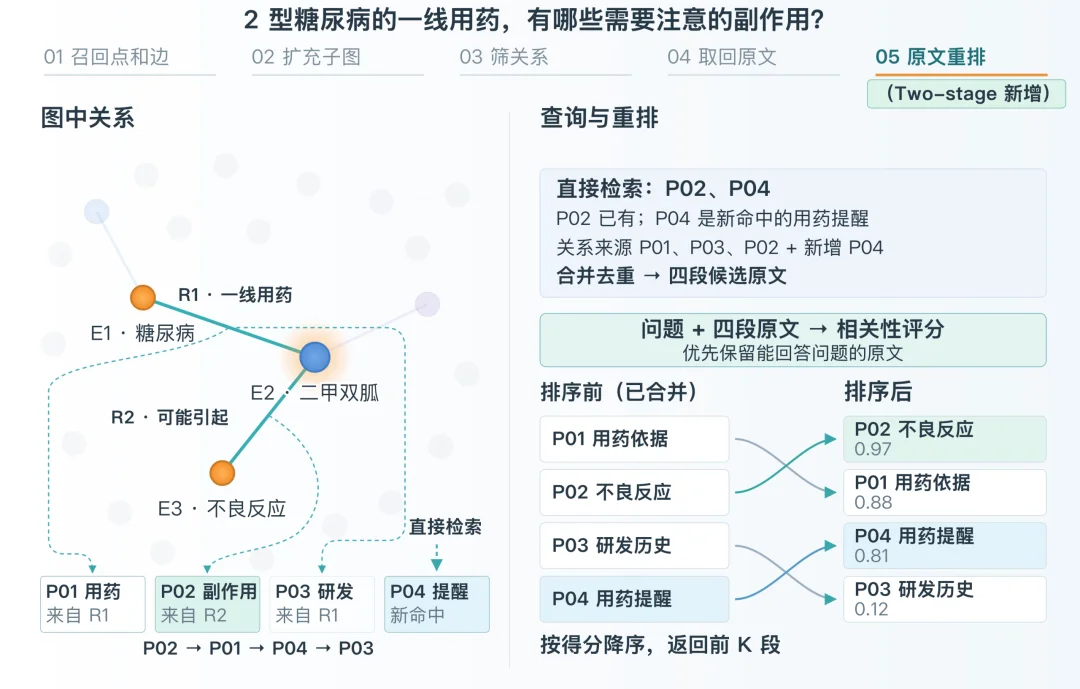
假设第一阶段筛选关系后,取回了三段原文:P01 介绍二甲双胍是一线用药,P02 介绍二甲双胍的不良反应,P03 则主要讲二甲双胍的研发历史。
与此同时,新增加的向量检索又找到了 P02 和 P04,其中 P04 是一段相关用药注意事项。
两路结果合并之后,重复的 P02 只保留一次,候选集合里就有了 P01、P02、P03、P04 四段资料。
这时再让 Jev 判断,任务就清晰得多了:用户想知道的是一线用药的副作用,P02 显然应该排在前面;P01 可以确认药物身份,P04 提供补充的用药信息,也可以保留。P03 虽然来自一条相关关系,但主要讲研发历史,对回答当前问题帮助不大,可以往后排。
可以看到,两阶段方案并不是简单地多调用了一次 Jev。
第一次判断发生在关系层面,目的是沿着知识图谱找到值得追踪的证据线索;第二次判断发生在原文层面,直接决定哪些资料应该进入最终检索结果。
同时,新增的直接向量检索也为候选集合补充了另一条证据来源。
原版方案在筛完关系之后,就直接依靠关系关联返回原文。现在,关系筛选不再决定最终排序,后面还有机会根据原文内容重新调整结果。
当然,这也带来了新的开销。原来只需要调用一次 Jev,现在需要两次。
但第二轮面对的是合并后的、规模相对较小的原文候选集合,而且 Jev 本身的判断速度较快,整体的成本增加相对可控。以下是我们的实测结果。
04
实验测评:两阶段 Jev 的召回超过了此前所有对比方案
为了验证两阶段方案,我们在 MuSiQue 和 2Wiki 两个多跳问答数据集上进行了测试,每个数据集各取 1,000 道题,总共 2,000 道,最终的关注指标是Recall@5。
实验对比的方案有:
- 最普通的向量检索(Naive RAG)
- HippoRAG 2(一种利用知识关联增强多跳检索的 RAG 方案,在召回阶段也会用到大模型)
- 原版的 Vector Graph RAG方案(分别使用 GPT-6 Luna, DeepSeek V4.1 Flash进行关系重排,这里没有使用到这些大模型的对应的更高级版本,因为在测试当中,他们耗时会很久,有时甚至会思考超时,而且测试表明,并没有带来效果提升)
- Jev 直接关系重排
- Jev 两阶段重排
最终的实验结果如下:
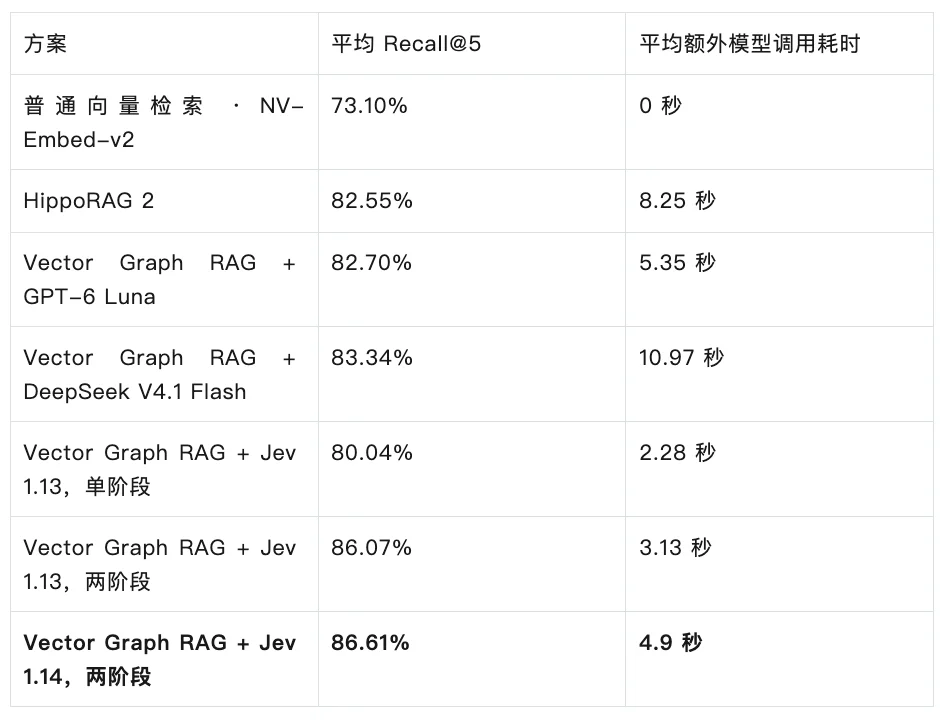
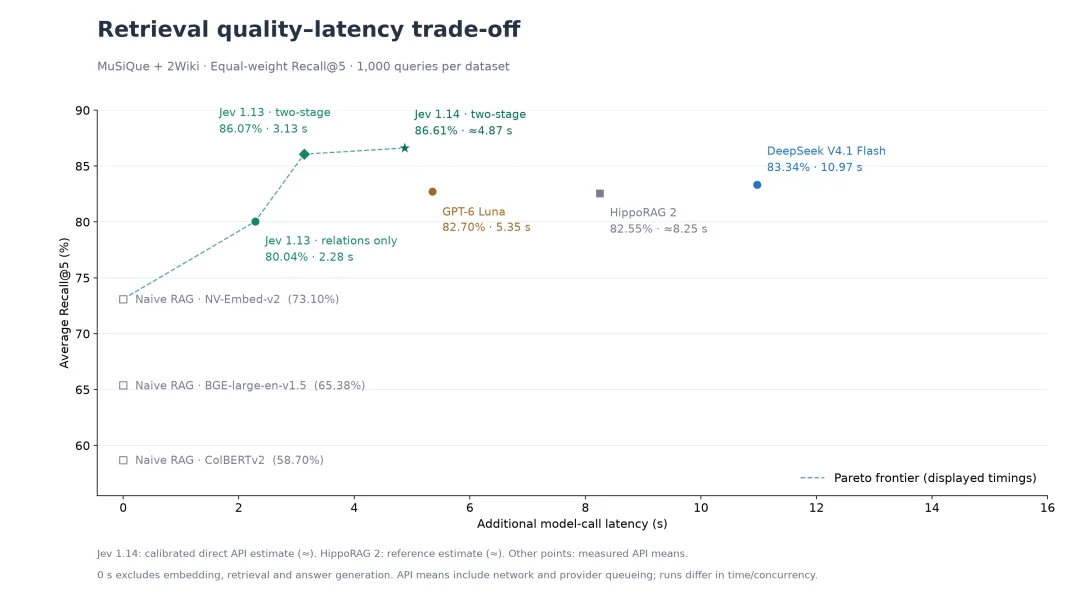
先看单阶段与两阶段的对比,从图表里可以看到,Jev 1.13 从单阶段的 80.04%,到了两阶段的 86.07%,提高了约6 个百分点。对应的额外模型调用耗时,从 2.28 秒增加到 3.13 秒,只多了 0.85 秒。最新的 Jev 1.14,平均召回则直接提高到86.61%,是所有方案里的 SOTA。
再看与 LLM 重排的对比:原版 Vector Graph RAG 使用 GPT-6 Luna 时,平均 Recall@5 为 82.70%,额外模型调用耗时 5.35 秒;使用 DeepSeek V4.1 Flash 时,召回率达到 83.34%,但平均耗时增加到 10.97 秒。
相比之下,两阶段 Jev 1.13 不仅将召回率提高到了 86.07%,额外模型调用耗时也只有 3.13 秒。两阶段 Jev 1.14 的平均 Recall@5 进一步达到 86.61%的同时额外模型调用耗时也增加到了约 4.9 秒,但依然低于大模型重排的耗时,且结果更优。
当然,本次实验测试,和整个项目优化的方向,目前主要针对在线检索这个流程。三元组的抽取,离线导入,依然还需要依赖 LLM,决策模型目前还不能完全取代,但长期来看,决策模型的潜力,值得我们持续关注。
相关项目与延伸阅读
Vector Graph RAG:https://github.com/zilliztech/vector-graph-rag
完整评测与复现:https://github.com/zilliztech/vector-graph-rag/tree/main/evaluation/jev/two-stage
Jev 判断接口:https://docs.typesafe.ai/introduction
前文《Vector Graph RAG:无需图数据库的多跳 RAG》:https://mp.weixin.qq.com/s/O_3MS-pHts15Quqwev4MEg
前文《Jev 深度测评:它能改变 Agent 搜索吗?》:https://mp.weixin.qq.com/s/A4kriC5guo0iMOMMDVl89g
论文资料HippoRAG 2:https://arxiv.org/abs/2502.14802
张晨
Algorithm Engineer at Zilliz
文章来自于"Zilliz",作者 "张晨"。