


憋了整整两年多,百度终于亮出了自己的重磅杀手锏!
今天,百度Apollo正式发布了「ApolloWorld」——首个面向物理AI的Agent驱动全模态世界模型。
它直接把整座城市的路网、多模态传感器和车流博弈搬上云端,支持毫秒级实时交互与连续几十分钟的完整接单推演,一举打破了以往世界模型只能模拟「几十秒孤立片段」和「单向放录像」的瓶颈。

有了这个虚拟「大考场」,无人车在云端平均可做到「日行十万公里」。
1天跑完的虚拟里程,顶得上1辆配安全员的真车连续测试约3年,把自动驾驶测试效率提升了数百倍!
靠着ApolloWorld在云端24小时陪练,萝卜快跑L4级全无人端到端大模型如今已正式上车。
上百辆无安全员真车,每天靠端到端大模型上街跑单——全球能做到这一步的,只有它和特斯拉两家。
最关键的是,云端特训出来的成绩,真上了路确实能打。
这次我们在深圳街头实测打车,就被这位没有安全员的「AI司机」秀了一把什么叫老练——
大晚上视线不好的路段,左边快车道突然冒出黑衣路人占道、右侧又挤满单车与电瓶车,或是路口左转时外卖骑手从车头前1秒闪过……
换作是新手司机早就慌了,但无人车总能提前预判、平顺减速让行;遇到夜间多车流掉头或窄道连续避障时,绕行与会车更是丝滑得像十年驾龄的「老司机」。


世界模型赛道火热
光会「拍电影」可救不了无人车
能让无人车在街头把复杂路况处理得如此老练,很大程度上正是得益于世界模型在幕后的高强度特训。
最近一个多月,全球世界模型赛道热闹非凡。从李飞飞团队World Labs的三维空间模型,到谷歌DeepMind的Genie系列,再到Waymo基于Genie 3推出的自动驾驶世界模型——甚至把龙卷风、洪水和大象都放进了虚拟测试场。
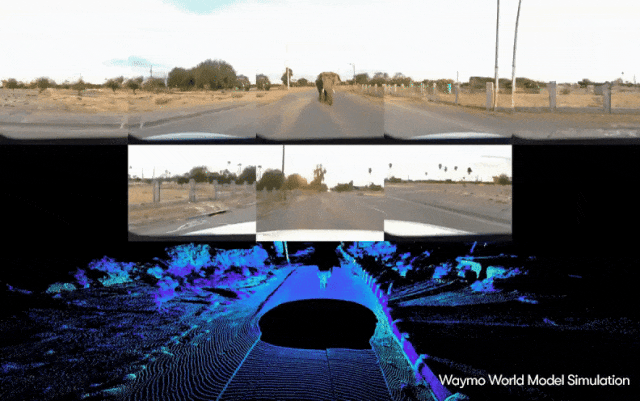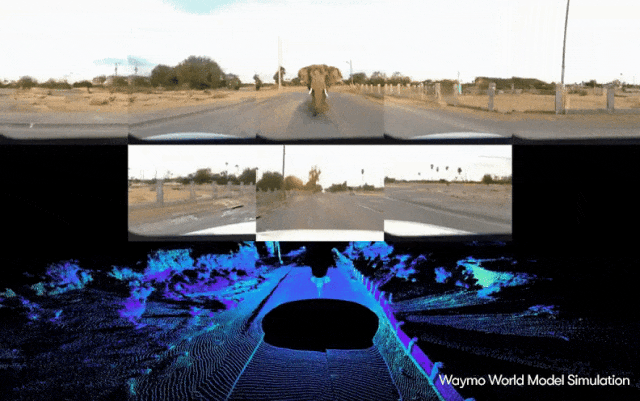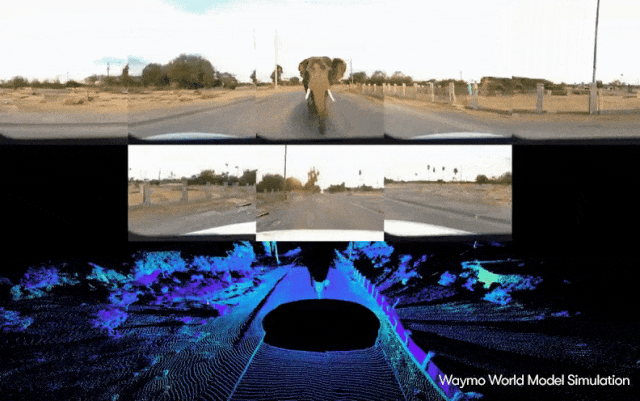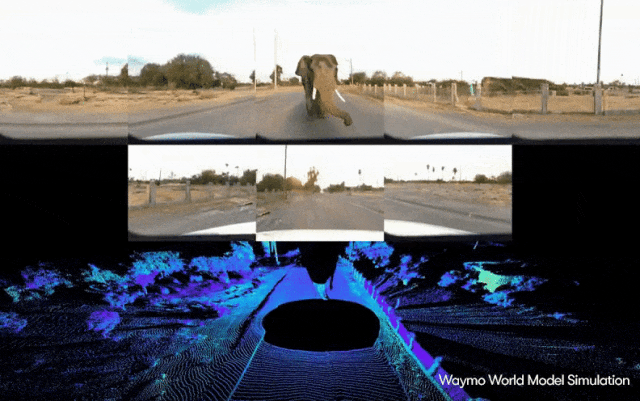
如果只是生成一段酷炫的街头视频,看着确实过瘾;可要是拿来给L4无人车当训练场,就不够用了。
原因在于,目前市面上大多数吸引眼球的演示,其实还停留在「视频渲染器」阶段,虽然镜头在变、风景在动,但外面的世界并不会因为你的动作发生改变。
大会现场,百度智能驾驶事业群组首席架构师、技术委员会主席王亮博士称,世界模型不能只做「生成炫酷视频的画师」,更要成为验证无人驾驶安全性的「考官」。
因此,百度这次没有去拼单纯的画面特效,Apollo World从一开始就瞄准了能互动、能推演路况变化的「世界模拟器」,专门给无人车造云端训练场。
之所以必须跨过这道坎,是因为无人车开上街头,面对的是容错率极低的真实物理世界。
家务机器人在屋里叠衣服、做饭,就算失手把碗摔了,大家最多一笑而过;可一台近两吨重、时速几十公里的汽车开在马路上,一旦遇到行人突然横穿或旁车加塞,根本没有试错的余地。
因此,用来训练无人车的世界模型,不能只是单向放录像的「电影院」,而必须像一场随时接戏的「舞台剧」——你稍微减速,旁边的车立马插进来;你往前探出半个车头,对方可能就踩刹车让开了。

想在真车上路前把罕见险情全部练熟,百度的解题思路正是「用AI训练AI,让AI教AI开车」:
- 车端的「学生」:装在无人车上的萝卜快跑新一代L4端到端AIDriver基础模型(ADFM),直接输入多模态传感器信号并输出驾驶轨迹;
- 云端的「AI教练」:具身世界模型ApolloWorld,专门负责在云端构建闭环仿真环境,给学生出题、陪练和打分。
训练时,「教练」会生成逼真的街景与雷达点云,并根据「学生」每一次打方向或踩刹车的动作,实时推演周围车流的下一步反应,一秒接一秒地闭环过招。
一旦「学生」在某个罕见险情里反应慢了或发生擦碰,「教练」马上就能抓出短板,变着花样生成上千道同类长尾难题反复特训,直到彻底练成「老司机」再装上真车。
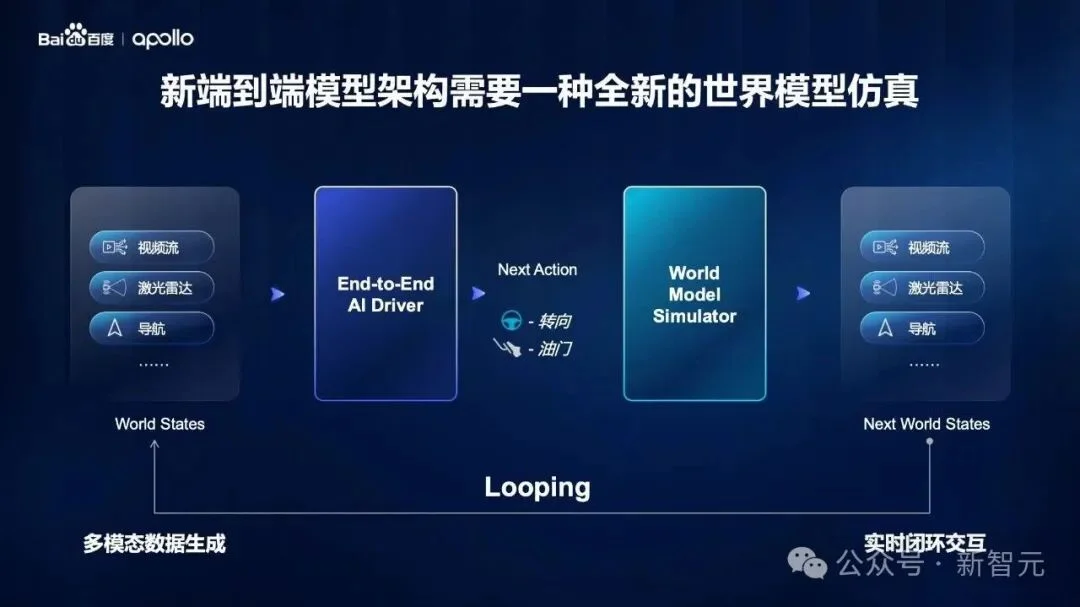
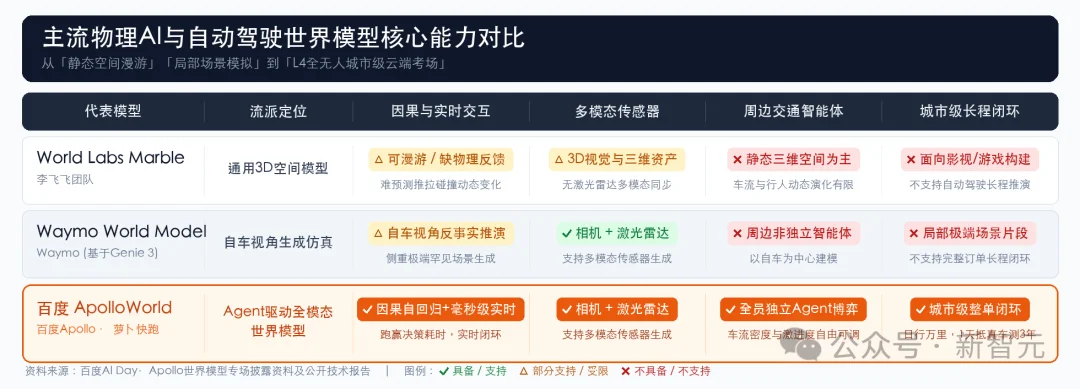
相比之下,目前主流的世界模型大多聚焦于静态3D空间漫游、局部场景模拟或单一视觉推演。
而Apollo World则成为了业内首个同时打通「全员独立Agent交互博弈、相机与点云全模态同步生成、城市级完整订单闭环」的L4实战训练场。
三关实测现场验货
暴雨天点云减半、连鬼探头都能实时过招
在这座云端虚拟城市里,旁车随时可能变道加塞,路口会突然冲出外卖电瓶车,现实街头最让人头疼的复杂路况,24小时不间断地换着花样给无人车出题。
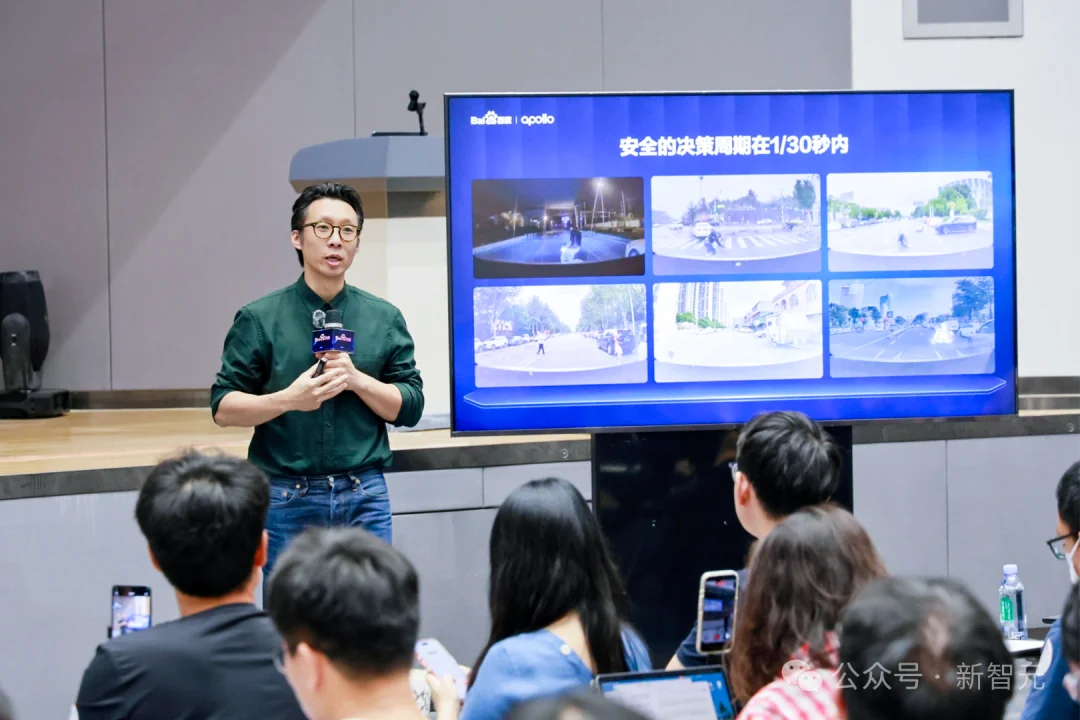
王亮博士表示,「开放世界容错空间几乎为零,安全决策周期要严格限定在1/30秒内」。
如今「世界模型」这个词被用得越来越泛,却始终没有统一的定义。
为了衡量这个训练场到底好不好用,也为了把这个新概念真正「做对」,百度坚持想清楚再动手的正向设计思路,先提出了一套世界模型「2+3」标准。
其中,前两项「2」是区分「视频生成器」和「真世界模型」的基石门槛:
- 因果性:基于因果自回归机制,严格遵循时间单向性,只能根据过去和当前状态推演下一秒,不能提前预知结局再倒推画面;
- 交互性:支持动作条件生成(Action-Conditioned),无人车每次打方向或踩刹车,周围车流都得跟着实时改变。

跨过这道门槛后,后三项「3」则是检验L4训练场的实战指标:
- 物理准确性:严格符合真实的光学成像与车辆力学规律;
- 持久性:能连贯跑完几十分钟的完整行程,长时不断片;
- 实时性:实现毫秒级响应,推演速度跑赢驾驶系统的决策时间。


这套「2+3」标准放进实际路测里,对应的正是物理规律、车流博弈和长途连贯性三道关卡。不妨结合实测画面,逐一看看ApolloWorld的表现。

不搞「表面滤镜」,雨天打滑和水柱冲锥桶都得算准
第一关先测物理常识,看它只是给画面加了层滤镜,还是真的懂现实世界的物理规律。
把同一段城市道路依次切换成晴天、暴雨、雪天和夜晚,最明显的变化就在激光雷达点云图里。
一旦切到暴雨模式,不光摄像头画面有了积水和反光,激光雷达点云也因雨水散射一下子少了一大半,连左前车后轮溅起的水花和前车后方的激光无回波区都清晰可见。
切到雪天时,路边的落叶树会自动掉光绿叶;到了夜晚,车辆连续驶过路灯时,车身下的阴影还会随着光源位置周期性拉长与缩短。
工程师并没有在代码里写任何光学或自然公式,全是模型学习超10亿帧真实数据后,自己摸清了这套物理规律。

雨天路滑还会直接影响刹车距离。两辆无人车以同样的速度同时踩下刹车,晴天干地上的车稳稳停在前方货车后,雨天湿滑路面上的车则会继续往前滑出一段距离才停下。

在真实路测中还曾遇到过这样一幕:洒水车喷出的高压水柱把路边的锥桶冲到了马路中间,正好挡在无人车正前方。
传统模拟器里的锥桶固定不动,根本算不出这种意外;而懂物理规律的ApolloWorld却能把「水柱冲走锥桶」的全过程推演出来,专门训练无人车遇到突发障碍时及时避让。

告别「重放录像」,让整条街的车活过来陪练
过了物理细节这一关,第二关要面对的,则是路上随时变主意的其他车辆和行人。
传统的仿真测试大多采用「实车日志回放」,也就是把真车录下的历史数据重放一遍。一旦无人车临时决定提前变道,录像里的旁车根本不会配合,还是照着原来的死路线往前开,测试结果自然就失真了。
为了让周围环境真正响应无人车的动作,ApolloWorld构建了「智能体驱动(Agent-Driven)」的推演架构,把场景里的每一辆车、骑手和行人都建模为具备独立感知与决策能力的AI智能体。
测试人员还能在系统里直接调高车流密度或旁车抢道的激进程度,实时生成不同风格的交通博弈分布,主动给无人车增加考试难度。
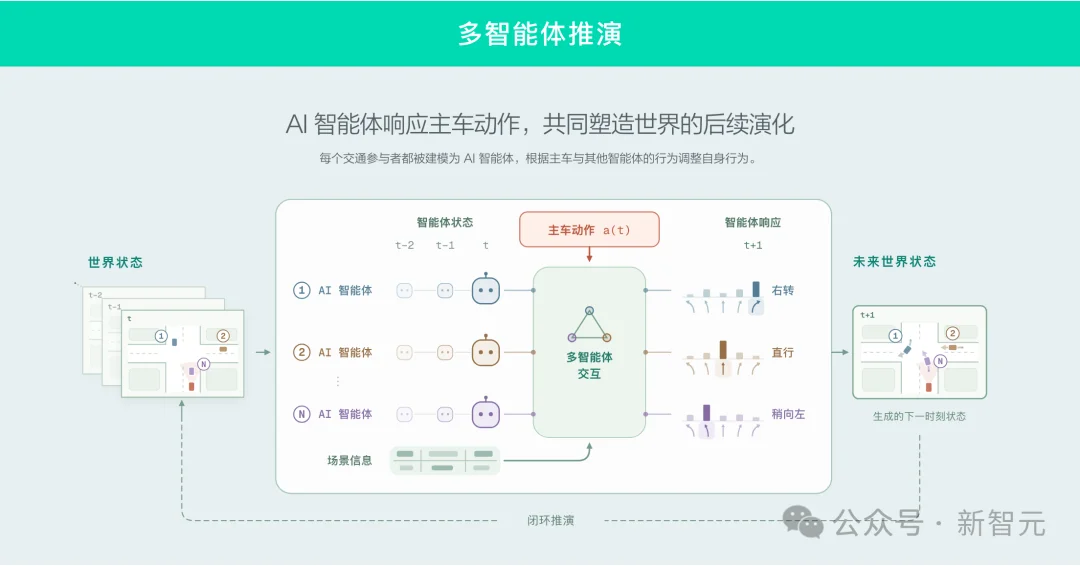
比如在高架匝道口,如果无人车选择驶上高架、给右侧留出足够空间,支路上的白车就会顺势汇入主路。
而如果无人车改走地面辅路,右侧白车看到会车空间不够,就会主动停在支路等待。

在一场路口骑行者「鬼探头」的高压测试中,一名骑车人突然从路侧视线遮挡处猛冲出来,无人车第一时间急刹停住。
更有意思的是,这名骑车人看到车头近在咫尺,竟然像真人一样往后退了一小步,主动让出安全距离,随后无人车才重新起步。
而在另一组测试里,骑车人只是顺着路边平行骑行,无人车便不再猛踩刹车,而是稍微减速后平顺通过。

告别「几十秒短片段」,在香港虚拟城一口气跑完一整单
光能躲过单次险情还不够,真实打车往往要连续跑上几十分钟,前一个路口的变道选择,会直接改变后面整趟行程遇到的路况。
这就引出了第三道关卡——长时间连续推演的稳定性和实时性。
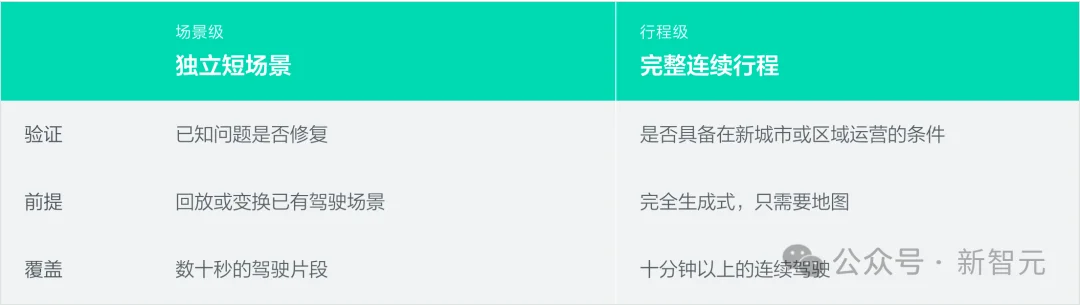
以往行业里的世界模型大多只能模拟几十秒的单一独立场景,一旦拉长到跨路段的连续行驶,画面细节和道路结构就容易发生漂移甚至崩塌。
而Apollo World则支持无人车在虚拟城市任意起终点之间连续行驶十分钟以上,一口气跑完从接单、载客到送达的完整行程。
在实测中,4辆虚拟无人车从香港机场附近的万豪酒店同一个起点出发,分别开往航站楼、购物中心、机场行政大楼和停车场4个不同目的地。
前半程路线相近,过了岔路口后则拐进不同道路,各自面对不同的红绿灯和车流,最终全都平稳跑完了整趟行程,画面从头到尾没有崩塌。

在同一条路线上,系统还能同时设置低、中、高三种不同密度的车流进行倍速并行测试。
车流稀疏时无人车快速通行,车流密集时则耐心跟周围车辆博弈汇入,充分检验早晚高峰等不同路况下的连续通行能力。
<