


过去两年,AI for Science 正在经历一场肉眼可见的转向。自 AlphaFold 拿下诺贝尔奖、AlphaFold 3 和 ESM3 等模型相继问世后,AI 在生命科学里的角色,已经不再局限于预测一个蛋白结构或生成一段序列,而是开始直接接管“提出科学假设”这一核心环节。
2025 年,斯坦福大学加里·佩尔茨(Gary Peltz)团队曾做过一次对比测试:他们请谷歌研发的科研智能体 AI co-scientist 为肝纤维化筛选可以“老药新用”的候选药物。AI 推荐了三种,佩尔茨凭经验另选了两种。这五种药物在实验室培养的肝脏类器官中一同接受测试,结果 AI 推荐的两种表现出显著的抗纤维化活性,而佩尔茨选的两种均未见效。
当 AI 能够在几分钟内给出超越人类直觉的假设,科研的瓶颈便迅速转移到了物理世界。计算机里的推演可以无限加速,但现实中的验证依然受制于细胞培养和动物实验的客观周期,跑完一轮少则数周,多则数月。
在我们与张载熙对话中,他所聊起的一项合作,正是卡在了这里。一家研究急性髓系白血病十余年的国家重点实验室,早年曾尝试寻找新靶点,但后来放弃了。原因很现实:人工整理出一个候选靶点后,还要走完细胞培养、基因编辑和敲除实验等一长串流程,验证单个靶点往往需要一个月以上,探索十个靶点通常要耗费一名学生一年多的时间。
在部署了张载熙参与开发的科研智能体 STELLA 后,这家实验室在极短时间内拿到了 40 个此前从未见诸文献的候选靶点。面对这份名单,实验团队起初将信将疑,加上每次验证耗时近两个月,他们只挑了排名第一的靶点,在四个细胞系中做基因敲除。结果实验效果非常明显且高度一致,目前团队已在围绕该靶点开展抗体药物设计。至于剩下的 39 个候选靶点,至今大多还躺在名单上。张载熙认为,从分析链路来看,它们同样各有依据,只是实验的速度跟不上。
这也是整场对话中张载熙反复谈到的核心矛盾:AI 提出候选的速度已经远超实验验证的速度;与此同时,计算结果与真实的实验结果之间,依然横亘着一道相当大的鸿沟。
谈及技术落地时,张载熙给出的数字相当克制。在他看来,团队此前做的核酸设计模型已是领域内最好的水平,但设计出的一百条序列中,真正能在湿实验里产生预期活性的只有一成左右;另一项代表作 PocketGen 虽然将实验端的抗体设计成功率从 10% 左右提高到了 20%,但若要继续往上走,他认为已经不是靠改进单一的工具模型能够解决的了。
如何跨过计算与实验之间的这道鸿沟,正成为全球 AI4S 领域争夺的下一个焦点。在美国,资本开始大举流向实验一端,Lila Sciences、Periodic Labs 等初创公司各自拿下数亿美元融资,试图建设由 AI 调度的自动化实验室,用机器通量去追赶算法通量。
而在大洋彼岸,完整经历了 AI4S 从冷门到爆发全周期的张载熙,也在尝试给出自己的解法。
张载熙生于 1998 年,本科就读于中国科学技术大学少年班学院理论与应用力学专业。2019 年开始读博时,他选择了 AI for Science。按他的说法,当时这个方向相当冷门,“基本上没有人会主动把它作为自己的研究方向”,标志性的 AlphaFold2 要到第二年年底才问世。
此后数年间,他先后做出过蛋白质口袋、核酸等领域的设计模型,随后赴普林斯顿大学王梦迪课题组从事博士后研究,并与斯坦福大学团队合作开发了 STELLA、LabOS 等科研智能体。今年 7 月,他加入香港科技大学,由化学与生物工程系、计算机科学与工程系和医学院联合聘任为助理教授,同时创立科理新序(Scinetics),并于 9 月完成首轮近 5,000 万元融资。
科理新序试图从“模型”和“实验”两端同时入手,去缩小计算与现实之间的差距。
在模型端,针对单点模型“只见树木不见森林”的局限,公司正在训练一个多模态科学基座模型。他们通过自己定义的 scientific token,将蛋白质结构、组学矩阵、基因序列、分子动力学等截然不同的科学模态统一起来,让模型能够直接在科学空间中进行推理,张载熙认为这是目前的通用大模型原生做不到的。团队在近期发布的技术报告中为下一阶段设定了名为“SSI(科学超级智能)”的标准:模型不仅要在垂直任务上超过所有最好的专用模型,还要在跨模态科学推理上超过同等体量下最好的通用模型。
在实验端,团队选择先在虚拟仿真沙盒中训练驱动机械臂的模型,计划明年开始建设自己的自动化实验室,跑通“干湿闭环”。值得一提的是,他和联合创始人早在 2025 年身处美国时就已开始筹划创业,但最终决定回国落地,理由同样与实验验证直接相关:在美国完成同样的实验验证,整体效率“比国内要慢好多倍”。
10 月 29 日,张载熙在 2026 腾讯全球数字生态大会智慧教育专场做了主题分享《以科学 token 为载体,走向科学超级智能》。腾讯云联合各科研实验室共建大衍 AI4S 社区,科研人员可以在社区发布真实的科学问题、寻找合作者,社区通过 Demo Day、大衍 Talk、联合案例发布等活动展示科研成果,并提供科研 Skills 和工具索引,以及腾讯云 TI-ONE 平台、TEFS 科学计算平台和算力等。大会期间,我们与张载熙进行了这场对话。
(来源:受访者)
以下是对话全文。
“当时基本上没有人会主动做这个方向”
DeepTech:先从你的经历聊起。你本科在少年班学的是力学,后来转到计算机,再到普林斯顿做博士后。当时为什么会把 AI for Science 选成研究方向?那个时候这个方向大概是什么状态?
张载熙:我本科学的是理论与应用力学,偏物理方向,具体做的是流体力学。那时候我就很喜欢自然科学里的问题,但也看到传统的计算方法有很多局限。比如用传统的物理仿真方法,很难高效地去做流场这类计算。
2018 年我有机会去美国杜克大学交流,跟一位年长的美国工程院院士做研究。当时我们就尝试用神经网络等 AI 方法来做流体力学预测。虽然那时的神经网络还比较初步,但在解偏微分方程这类问题上已经展现出了一些优势,主要是效率上的优势。本科毕业后,我就希望继续用 AI 的方式去研究自然科学问题。当时我本来准备出国,拿了几个学校的 offer,但那年因为签证原因没去成,2020 年我又拿到了哈佛、MIT 等更好的 offer,但赶上疫情,最终也没有去。
我从读博开始就做 AI 和科学结合的方向,这也离不开我博士导师的建议。他觉得我科学这块基础不错,同时又对 AI 感兴趣,应该去探索这样一个前沿方向。但当时这个领域非常冷门,基本上没有人会主动把它作为自己的研究方向。我在准备读博时想的是,做研究应该锚定五六年之后、甚至更长的时间段,去想那时候做什么事情更有意义、更能凸显自己的价值。当时最火的是图像识别,但我还是更愿意深入做自己感兴趣的事。所以我从博士一开始就做这个,当时领域里最有代表性的工作,像 AlphaFold2,其实都还没出现。
DeepTech:AlphaFold 2 的确是一个非常具有划时代意义的成果,它的发布对你有什么影响吗?
张载熙:它让我对自己在做的事情更加坚定了。看到它能突破传统方法长期无法解决的科学难题,我当时非常兴奋。我觉得很多领域都存在类似的困难,除了蛋白质,还有小分子、核酸和基因组等领域,都有大量长期悬而未决的难题,AI 在这里面的潜力非常大。看到 AlphaFold2 的时候,我觉得非常 exciting。
“单一的模型只能看到这个系统的一个侧面”
DeepTech:从早期偏传统的机器学习工具,到 AlphaFold 这种专用模型,再到现在开始出现通用模型。你现在做一个具体课题,完整的流程是什么样的?
张载熙:我们的研究方向是一步步推进过来的,中间有很多思考。一开始 AlphaFold2 出来后,我们是沿着这个趋势做模型,比如研究蛋白质的生成和设计,像 RNAGenesis 就是做核酸领域的生成模型。后来我们觉得,科学是一个复杂的系统,如果只做单一模型,它就只是一个更好的工具,很难产生我们想要的“科学智能”。因为在一个生命体里,有 DNA、蛋白质、RNA 等各种不同的分子类型,还有不同层级之间的相互作用在控制整个系统。所以我们觉得应该去做统一的模型。2023 年初,ChatGPT 展示出一个统一的模型可以在各种任务上都达到很好的效果,这更加坚定了我们往统一模型上走的决心。
我们一开始也尝试过智能体的方法。比如 STELLA,就是把大语言模型作为底座,接入各种垂直模型,希望通过智能体把不同的能力集成到一个整体。现在在公司,我们会更进一步,通过一套 tokenizer,把各种各样的数据训练到基座模型里去,同时做相应的对齐。
其实我们也是一点点探索出来的。不管是单点模型还是智能体,我们既看到了它们各自的能力,也看到了它们的局限性和天花板。现在做基座模型,并不是完全摒弃过去所有的思路,里面很多设计正是基于我们过去做垂直领域模型积累的 insight,才得以更好地实现。所以我认为这是一个很自然的发展轨迹,整体思路也很清晰,就是从单一模型走向更通用的模型,去做更大的科学闭环。
DeepTech:你前面说单一的工具很难产生智能,这一点能具体展开吗?
张载熙:可以举个例子。我们做的核酸模型,虽然已经做到了领域内最 top 的水平,能覆盖各种设计任务,但在做实验时还是发现,设计 100 个序列,真正能产生预期活性的大概只有 10% 左右。
即便模型做了很多改进,这个 gap 依然存在。这是因为我们在构建模型时做了很多简化。比如只做一个 RNA 模型,其实没有考虑到 RNA 在细胞内复杂的相互作用,包括从 DNA 到 RNA 再到蛋白质的中心法则等更长链路上的信息。所以单一模型相当于只看到了这个系统的一个侧面,或者说只看到了单一维度,没办法进一步泛化。忽略了这些信息,就会造成计算和真实实验之间的 gap。根据我们的观察,这种 gap 靠单点模型很难进一步解决。
DeepTech:那如果把你们现在做的这个模型放回到整个技术图谱上,它和已有的那些模型差别在哪?
张载熙:我们现在做的 AI for Science 基座模型,具体来说是一个多模态的科学推理模型。我们认为 AI 要去做科学探索,最关键的是在两个能力维度上实现突破:一是对科学模态的覆盖能力,除了文本和图像,还要涵盖蛋白结构、组学、基因序列、分子动力学等;二是推理能力,能不能系统性地解决问题,而不是单纯地调用工具。这两个维度是最重要的。
过去很多所谓的 AI for Science 基模,其实都是单模态的工具模型,比如 ESM、Evo 做的是序列生成,AlphaFold2 只做结构预测。后来也出现了一些多模态工具模型,比如 AlphaFold 第三代除了预测蛋白质单体,也能做复合物的结构预测,但它依然是个工具模型,只能解决非常具体的问题,达不到智能的层面。
另一条发展链路是推理能力。以大语言模型为代表,一开始只是简单对话,后来可以在特定场景和行业里做思考推理,甚至直接调用工具,这是目前通用大模型在做的事。但它们无法原生覆盖科学模态,也没办法在大分子结构空间、分子动力学时空这类科学空间里做推理。我们对自身模型的定义是,既能覆盖各种科学模态数据,同时又能在科学空间里做长程的探索和推理。
DeepTech:要让一个模型原生覆盖这些模态,就是 scientific token 要解决的问题?
张载熙:对。如果想用基座模型解决好科学问题,就要面对不同科学领域、不同模态的数据,比如蛋白质的空间结构、组学矩阵、极长的基因组序列,还有分子动力学这种动态、持续的结构数据。这些数据跟一般的文本或图像、跟目前通用模型处理的模态都很不一样。我们需要设计相应的 tokenizer,把它们统一做 token 化,变成 scientific token,在数据形式上形成统一的表示。
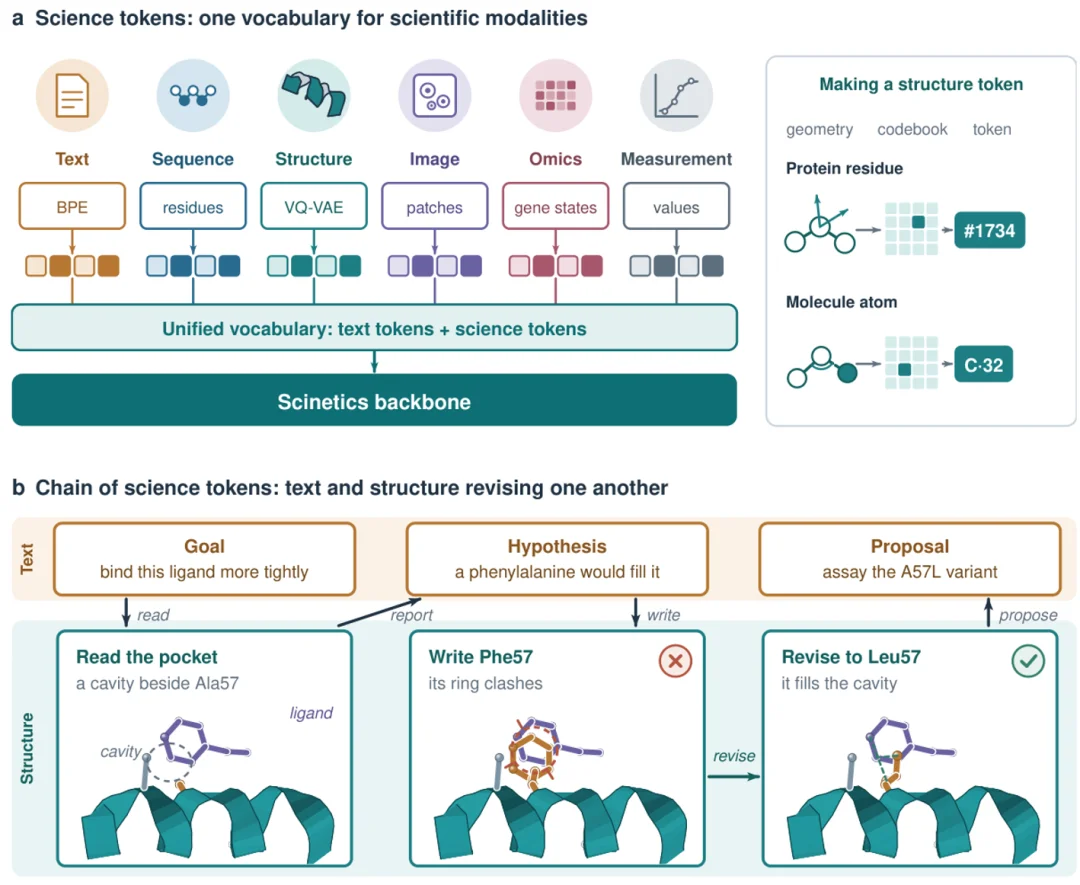
图丨科学 token与科学 token 链。(来源:Scinetics)
这样做有两个目的:一方面是通过 tokenizer 把不同模态里最关键的科学信息压缩、聚焦出来;另一方面,统一成 token 后,也方便不同模态之间的信息对齐,比如我们可以沿着中心法则去做跨模态数据对齐。我们希望通过引入更多模态和视角,让模型对科学系统建立全局认知,从而推进科学智能的涌现。这个概念也是我们在最近的技术报告里第一次明确定义下来的。
DeepTech:相比通用模型的 tokenizer 设计,你们的做法在方法或者特性上有什么不同?
张载熙:会有很多不同。比如化合物结构、组学矩阵,这方面原本就没有多少工作专门去设计 tokenizer,尤其是面向基座模型,该如何提取最核心的信息,同时支持几乎无误差的数据重建。这里面有很多具体挑战,既涉及数据格式,也涉及如何保留关键的科学信息。我们过去处理过很多科学模态的数据,在数据表征、数据建模上积累了不少领域知识,这支撑了我们去做相关的 tokenizer 以及模型和算法上的创新。
DeepTech:这种 tokenizer 会不会对数据的收集、清洗和筛选提出新的要求?
张载熙:对,很多科学数据需要我们自己从原始文献和专利数据库里去整理。原始数据非常粗糙,有时候还需要我们自己定义数据格式。比如我们之前做过一个平台,用来自动化收集蛋白质和小分子亲和力的数据。做下来发现,只收集蛋白质、小分子和亲和力这几项还不够,还必须把实验条件和实验 protocol 也记录下来。因为很多实验结果和性质是有前提条件的,实验方案不同,或者温度、时间等参数发生变化,最终结果就会不一样。所以我们前期做了很多摸索,发现必须把更完整的信息记录下来,不管是 tokenizer 还是后续的数据处理,才能建立更完整的理解,否则会损失很多信息。
DeepTech:“在科学空间里做推理”这个说法还是比较抽象,有具体的例子吗?
张载熙:在技术报告和 perspective 的基础上,我做了一个具体的模型叫 Chain of Structures,就是在蛋白质结构空间里做推理。举个例子,酶蛋白设计是非常困难的,因为酶的结构极其敏感,某些氨基酸结构稍微变化一点,就会决定它能不能催化。所以我们不是一步直接把蛋白结构生成出来,而是分步走:先设计活性中心,再搭建支架,接着设计侧链,最后做整体的能量优化和侧链修饰。
在这个过程中,每一步的结构推理和文本推理是同时进行的。因为它们都以 scientific token 作为表示方式,信息是互通的,没有模态之间的隔阂,而且能互相促进。文本会指导模型如何在蛋白结构空间里做推理和编辑;蛋白结构的信息又会直接反馈给文本,让推理模型知道设计已经到了哪一步、当前状态是什么、下一步该做什么,从而一步步把蛋白质设计出来。我们发现,在酶蛋白设计上,这种方法相比目前最好的一批蛋白质设计模型有明显提升,达到了 SOTA 的效果。
DeepTech:那你们如何定义这条路最终的目标?
张载熙:我们在技术报告里把下一个里程碑定义为 SSI(scientific super intelligence,科学超级智能)。我们的标准是:首先,这个模型在蛋白结构设计、分子属性预测等各种垂直任务上,一定要超过各自领域里最好的专用模型;其次,在相近的参数体量下,它在跨模态科学推理、科学探索任务上,要超过目前最好的通用模型。这就是我们定义的下一阶段目标。按照我们目前的内部 scaling law,大概在 100B 到 300B 的参数量级上能达到这个水平。
40 个靶点,和一个将信将疑的实验室
DeepTech:有报道提到,一家专门研究急性髓系白血病的重点实验室部署 STELLA 之后,十分钟之内就拿到了候选靶点列表。相比传统做法,拿到这类候选靶点大概需要多久、要投入多少资源?
张载熙:我们合作的那家国家重点实验室,过去十多年一直在研究急性髓系白血病。但他们绝大部分研究都是基于老靶点做药物开发或机制分析,很少尝试发现新靶点。我们也问过原因,其实他们早年尝试过,但总体成功率很低,效果并没有显著超过老靶点。
这主要是因为时间和资源成本太高了。如果靠人工去标注、整理候选靶点,再往下做细胞实验和基因敲除来验证靶点作用,单做一个靶点的实验可能就要花一个月甚至更久。从培养细胞到基因编辑,一整套流程走下来成本非常高。探索十个靶点,可能就要耗费一名学生一年以上的时间,不管是时间成本还是资金成本都相当高。
他们早期尝试后发现整体效率太低,就放弃了,后来尝试用 STELLA 系统来做新靶点发现。STELLA 之前做过很多科学探索,虽然不是专门针对这个疾病,但它学会了如何通过系统性分析去寻找线索。在这个具体的靶点发现任务中,它综合了生物功能、蛋白质相互作用、基因通路、科研文献以及临床数据,进行整理、分析和排序,最终给出了 40 个此前从未被文献报道过的候选新靶点。
DeepTech:使用这些工具的实验人员那边的反应是什么?
张载熙:实验人员一开始也是将信将疑地去做验证,毕竟验证一次差不多要花两个月时间。他们挑选了排名第一的靶点,在四个细胞系里做了基因敲除实验,结果发现整体效果非常明显,而且高度一致,我们也非常欣喜。现在他们正在基于这个新靶点做新的抗体药物设计。
DeepTech:另外一些成果,比如 PocketGen,生成速度大概是传统物理方法的十倍,在设计环节的指标也更高。到了后期真实实验里,成功率具体提高了多少?计算指标和实验结果之间的差距大概有多大?
张载熙:PocketGen 是我们之前做的一个垂直模型,用于蛋白质结构和序列的协同生成,可以设计抗体和其他类型的蛋白。它一方面效率很高,另一方面设计出来的抗体在稳定性、亲和力等指标上也超过了后续的一些方法。我们后来做过相关测试,它确实能提升实验端抗体的整体成功率,比如从 10% 提升到 20%。
但我们也看到,它依然是一个单点模型。如果想进一步提高,比如把成功率拉升到 80%、90%,还是需要依靠基座模型。这也印证了前面说的,单一的垂直模型很难形成科学智能的涌现,它只是一个更好的工具;而如何对科学做更好的建模,显著缩小计算和实验之间的 gap,我们现在押注的是靠基座模型来最终实现。
先在沙盒里练到接近 100%
DeepTech:实验这部分现在是整个领域比较关键的瓶颈。除了数据之外,湿实验的通量可能赶不上前端靶点发现效率提高的速度。你们搭了一个沙盒环境,用 VLA 模型驱动机械臂做实验,现在跑一个 loop 大概需要多久,瓶颈在哪一部分?
张载熙:我们之前先搭建了一个沙盒环境,对很多实验设备做了仿真建模。因为训练 VLA 或其他面向物理设备的世界模型时,相关的数据和反馈非常稀缺,直接在线下部署、收集真实数据的成本又太高。所以我们先在虚拟沙盒里做预训练,通过不断迭代,把实验成功率从最初的不到 10% 提升到接近 100%,然后再部署到线下实验室里做测试,收集真实反馈。
DeepTech:这已经是一个比较完整的 RSI 闭环了。你怎么看 RSI 在 AI for Science 里的应用?
张载熙:我们很早就开始在各个方面尝试 RSI(递归自我改进)的迭代应用了。比如去年 7 月发布并开源的 STELLA 第一个版本,就提