


大家好,我是天南,具身算法研究员。
前几天还在和同事吐槽 PI 的 API beta,一直觉得他们把事情想的太简单了。
就一个点,让用户自己采数据在上传没办法 work。其实做算法的都会明白,大部分的模型优化工作都在数据上,以及部署后的各种工程琐碎。
再之后是前两周 Dream Labs 上线的 Dream API,我倒是觉得方式不错。只不过看了十来分钟,成功率还在个位数。各种千奇百怪的提问方式都有。。。
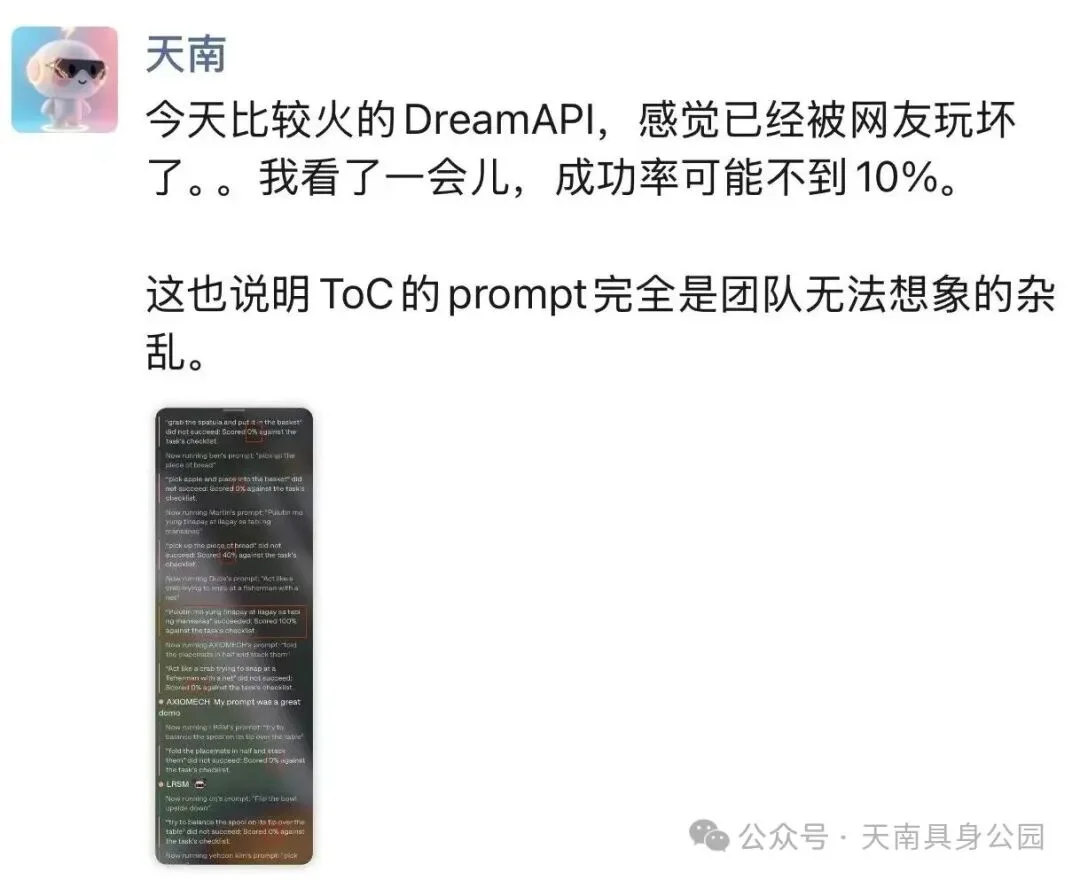
当时我发在朋友圈的一些感想
以及今天早上破壳刚刚公布的 RoboAPI。
PS. 大早上有被卷到。。。
这些事挤在一个月里,我相信大部分人的逻辑都会讲具身进入了“API 时刻”。
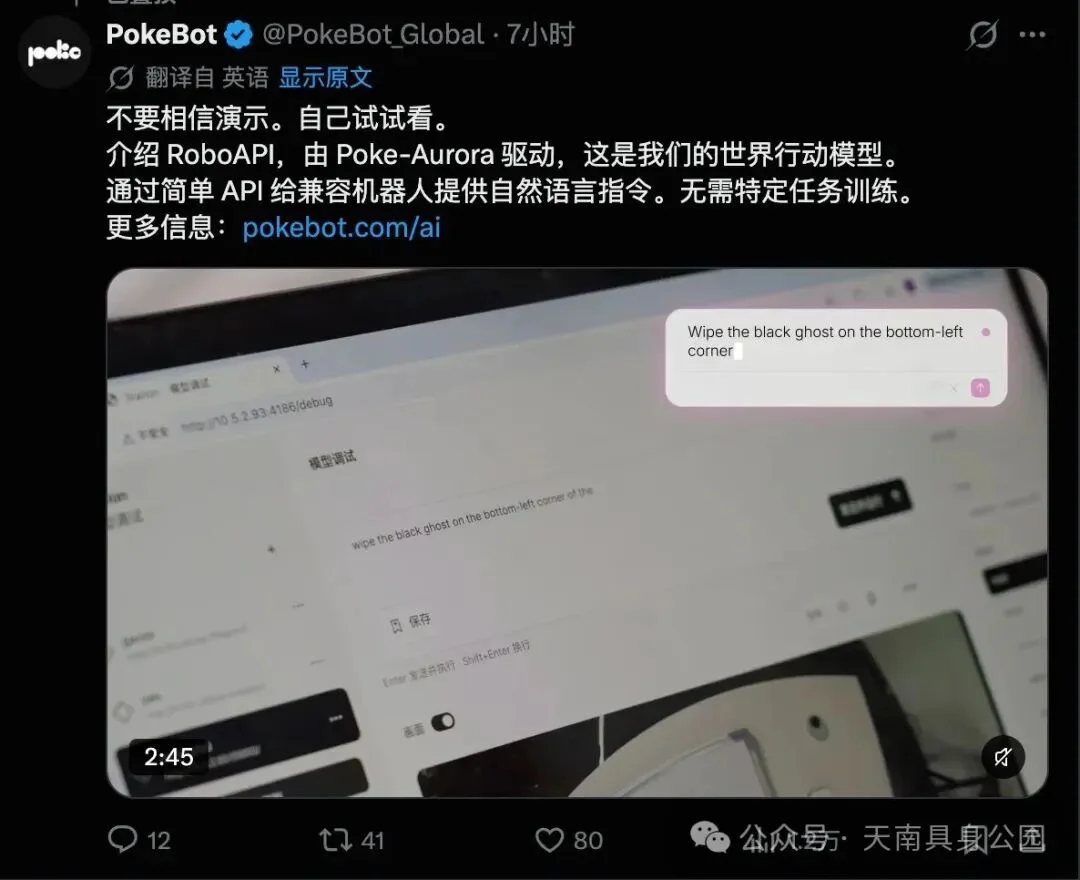
破壳发布在X上推文
这倒没啥错的,我也分享下自己不成熟的看法。
我感觉行业内部似乎形成了阶段性的自信,我们有一定的信心可以对外展示具身现有的能力了。而不是一直隔着屏幕发Demo的状态。
这种我是非常鼓励的,也确实是行业在持续进步的一大标志。
而作为国内第一个公布 API 进展的破壳机器人,我们也约到了许华哲老师交流,也听听他背后的思考和判断。
也聊到了很多的行业观察,比如GPT6会不会吃掉具身等,enjoy~
三家都在说 API,我们也看下实际情况。
事实上,这几家公布的 API 不太是一回事。
PI 的逻辑我感觉更像是技术迟滞后的无奈,Dream Labs 则像是先一炮打响让大家知道。
先说我看到的一些共性。
这几家做的事在形式上是一样的,把自己的模型挂到云端,让外面的人调用,可以进一步优化也可以直接泛化测试,结果呈现给大家。
这背后有一个逻辑:
就是大家都想让其他人看看。模型自己说好,已经没办法让大家信服了。
到了今天,一家公司想证明自己的模型好,最省事的办法反而是把它交出去。
有三家都都到这一步(算上 GEN-1.5,可能是四家),这件事本身肯定是很大的进步。以及,我也相信有更多的公司都在做类似的事情。
但往下一层看,破壳、PI 和 DreamLabs的做法还挺不一样的。
1)PI 的 API,服务对象是已经有场景的公司。
就是下面这张图里面的闭环,收集数据 → 训模型 → 部署 → 下一轮迭代。
看起来 PI 想卖的是这个闭环的 infra,客户不用自己搭训练集群和数据 pipeline 了。
Blog 里面有说,针对 Almond 和 Actor 两个部署案例,模型用 API 四天就能做出来。
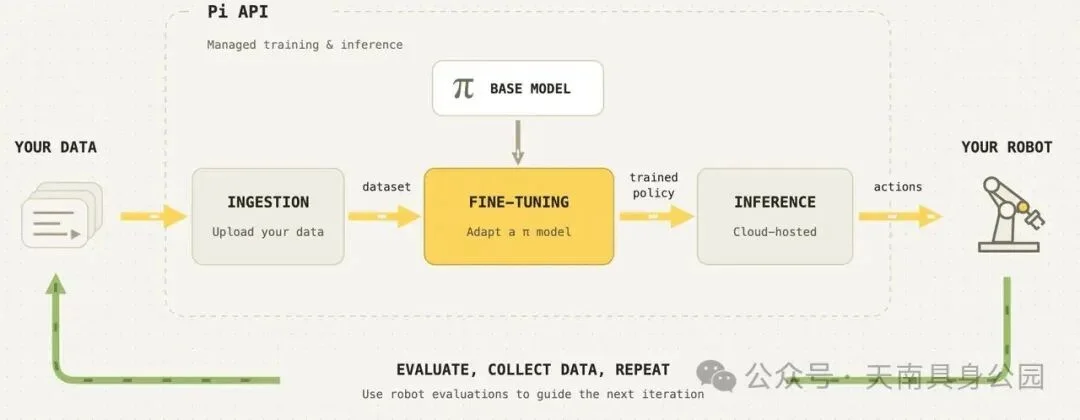
PI API的数据链路
四天确实很快。
但你仔细想一想就会发现,能用上它的人,手里得同时有场景、机器人(臂),更关键还得有人会采数据。
让用户自己采数据,在我看来是这个闭环最吃力的地方。
我们和许华哲老师也聊到了这里。
我会觉得 PI 的想象很美好。有一个好的基础模型,然后下游帮我采采数据,我帮他做后训练。
但下游的客户的意愿和能力都未必能达标,尤其是数据,怎么采、怎么记录,这些事情有很多 knowhow。
许老师也提到了可能有几种结局:
1)要么 PI 的团队下去支持,本质还是自己在做;2)要么找个外部的二开公司,把自己的一部分利润分出去;3)要不客户后面知道自己咋搞了,找个开源模型自己调。
从这些角度来看,PI的这种模式其实很难走通。
2)Dream Labs 的 API,服务对象是所有人。
Dream-1的打法,我确实觉得会很出圈。
因为这算是DreamZero团队第一次亮相和全球首发API的方式,声量还是挺大的。
就像官网里写的:Prompt a robot. Make your dreams come true.
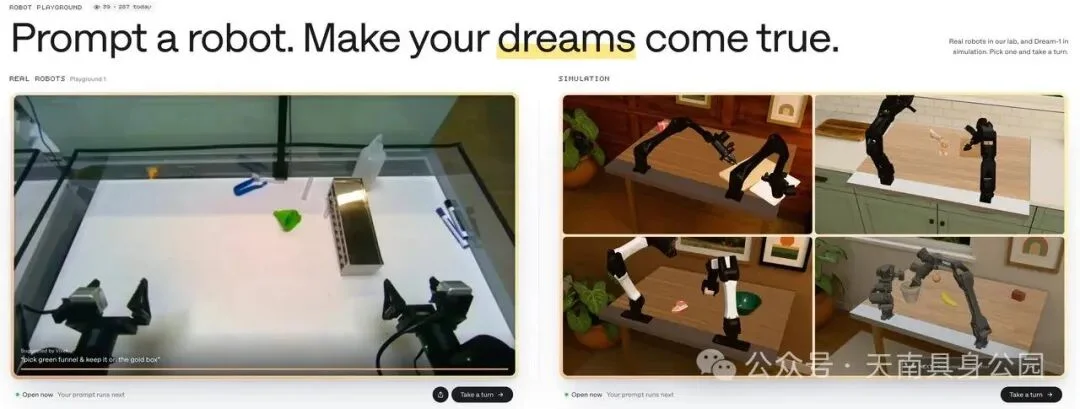
DreamLabAPI
用法超级简单,写一段提示词提交,完全不做任何限制,等待真机 or 测试仿真(有投票机制)。
所以出来的那天,很多人都上手去玩了玩。
只不过我看了十来分钟就发现了问题,网友给的指令完全就是天马行空。
我整体的感受成功率 10% 都不到。。。
DreamLabs 官方研究页给的是另一套口径:仿真里拿训练用的 YAM 本体当 100 分,27 款没见过的本体每款跑 300 次,其中 24 款能到 YAM 一半以上。注意这是相对分,不是成功率,而且是仿真。
这个数跟 playground 里看到的,完全是两个世界。
3)破壳这边,准备的时间比我想的长。
许华哲说他们大概今年四月份,就看到了把模型做成 API 的希望。
那会儿公司刚成立,他们看到了两件事:
- WAM 在数据起量之后,泛化性确实有提升。在没见过的场景里抓一个小方块这种最简单的事能做到了,而且跟随语言指令做不同任务也能泛化;
- 另一条是数据标注做到了很细的程度。除了常见感知、位姿、运动轨迹,语言标注能做的有很多,取决于你想做到的程度。
但前面几个月还在起步阶段。
他们当时拿模型训了一个麻婆豆腐,那个 demo 其实是针对特定任务做后训练的。再之后才比较 all in 在零样本这件事上,就是今天发的 RoboAPI。
所以这半年,他们做的事情就是把那个针对特定任务做数采的模型,换成一个更通用的 API。
许老师聊了他对 API 的观点,引起了我的思考,也分享给大家,非常的真诚的观点,持续做正确的事情:
“无论 API 未来能不能成为一种商业模式,在今天它都是一种正本清源式的验证。”
“我们希望屏幕里呈现的东西,和大家手上能拿到用的东西,是一模一样的。”
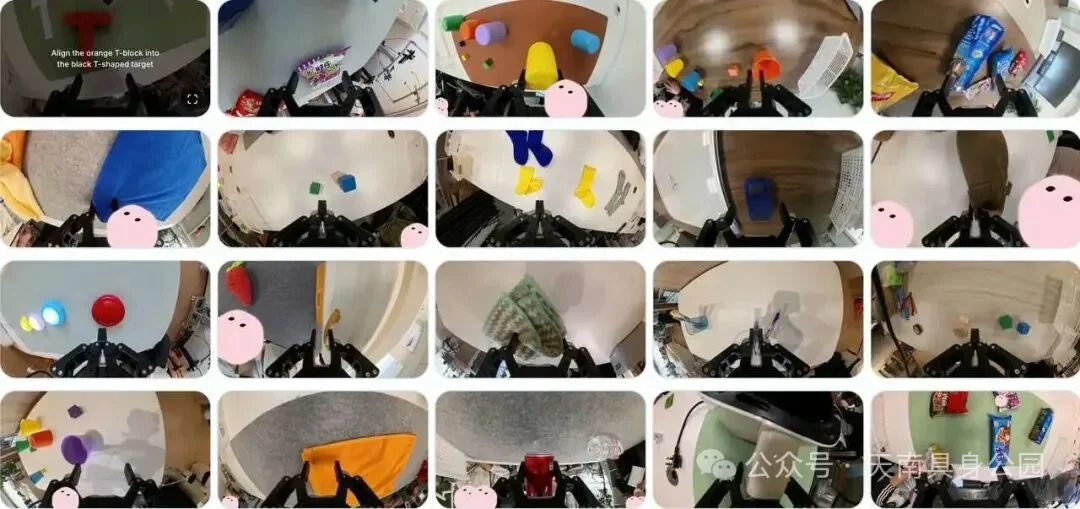
RoboAPI官网放出的各种测试例子。
再回到大家都在讲的词,部署。
可能大家都在讲部署 API,但强调的点不一样。
我抛个问题:部署这件事,要不要为每个场景单独定制。
PI 的答案是必须定制,而且得把定制做成流水线卖给你。Dream-1 还没回答这道题,因为 playground 算不上部署,它是一个传播装置。
许华哲老师给的答案,是通用场景里面定制不了。
当然,如果是工厂、专业场景走后训练也无可厚非,场景方有能力也有意愿去做。但通用场景不行,有的养老院在山里、海边,也有可能在城市。 把一个地方做到完美,迁移到另一个地方可能直接 fail。
家庭也没办法定制,准确的说往 C 端走就没办法二开,所以用户开箱拿到的就得是产品。
这也是 RoboAPI 想要做通用的初衷吧。
RoboAPI 到底给了你什么。
再来聊聊 RoboAPI,我看到了什么。

框架中规中矩,核心的是 Poke-Aurora,破壳的第一个世界-动作模型。
我直观上的感觉,模型应该不小,以及预训练规模在几十万小时的量级。
使用方式就是你把适配的硬件接上,API 接收机器人的观测和状态,根据你的指令,近实时地预测并输出接下来的动作。
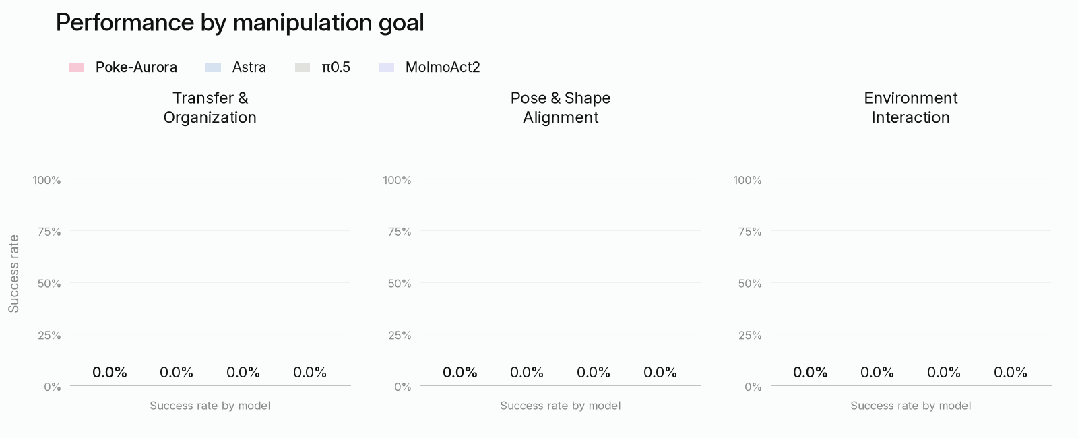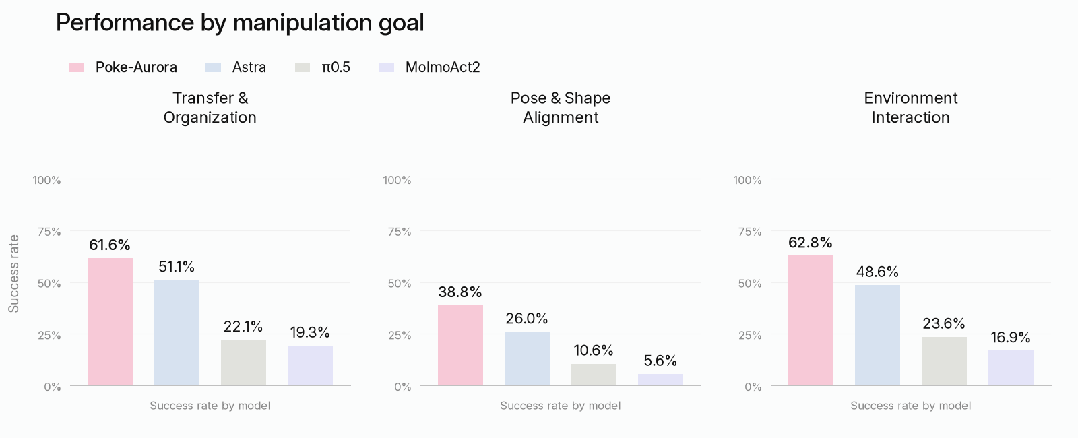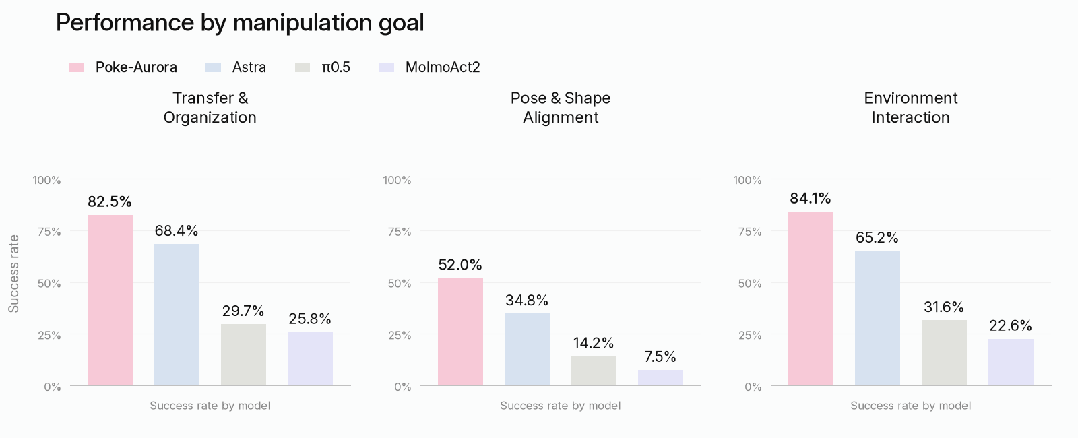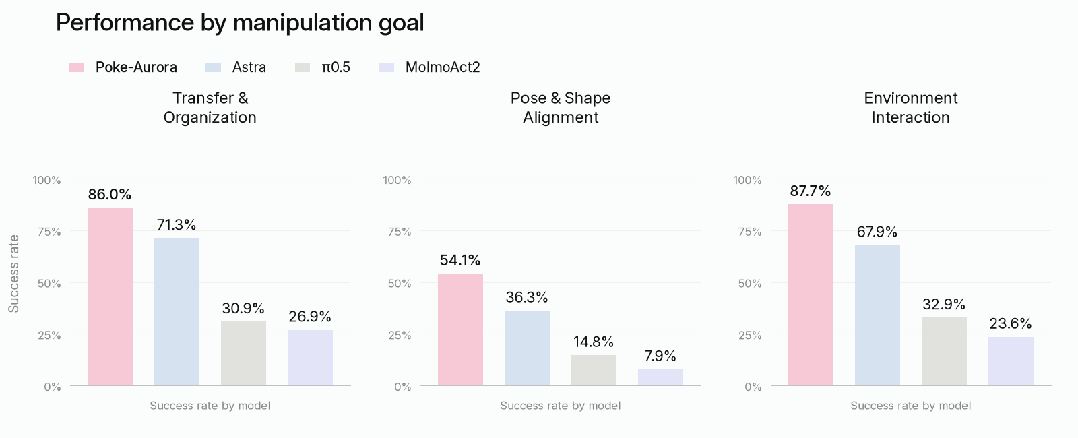
破壳给的结果是,整体任务成功率 70%,抓取类任务超 80%。
而且非商业化应用,不向盈利性第三方提供产品或服务。
我还是有些感动的,毕竟 Dream-1 是每小时 3 美元,PI 是排队加交数据。
说白了,就是想让大家体验下模型的能力,众人拾柴火焰高,一起来看看哪些地方做的好,哪些地方还有问题。
我也进一步和许老师展开讨论:如果真到了 C 端,想教机器人做西红柿炒鸡蛋,是不是得有个示教或者 ICL 的过程。
许老师说他自己其实不一样的看法。
虽然ICL很火热,但 Zero shot 就是 Zero shot。如果模型本身不会西红柿炒鸡蛋,那你就告诉我机器人不会西红柿炒鸡蛋,过几天你就会发现它会了。用户一旦示教,感觉就乱套了。
像 GEN-1.5 或者 Skild AI 展示的 One-Shot 或者叫 ICL,说起来是拍个视频就行。但相机架在哪、动作快慢,其实都有讲究。 如果能随便拿手机拍示教就能教模型,那种才叫强大,我不认为今天的 ICL 能做到。
然后他给了一个我之前没想到的说法:
“与其搞示教的数据闭环,或者大家说的数据飞轮、数据反馈,那不如搞任务级的飞轮。”
“你就告诉我你不会啥,过几天我们模型本身就带上这个能力了。你说做不了西红柿炒蛋,那我们就开始往里面加,加完你再试一下,就 work 了。”
「不要让用户干任何事」,这是他的原话。
所以我感觉破壳想从这个 API 里拿走的,是一张失败清单。
这是个 bug report 式的回路,不是数据回路。
再说一句他为什么愿意免费开放 API。大家对具身的信任度要远远低于对大模型的信任度,提到头部的具身公司,大家往往说他是拍电影的。
很真诚的一句话,所以我们才要向大家展示,慢慢积累公众的信任。
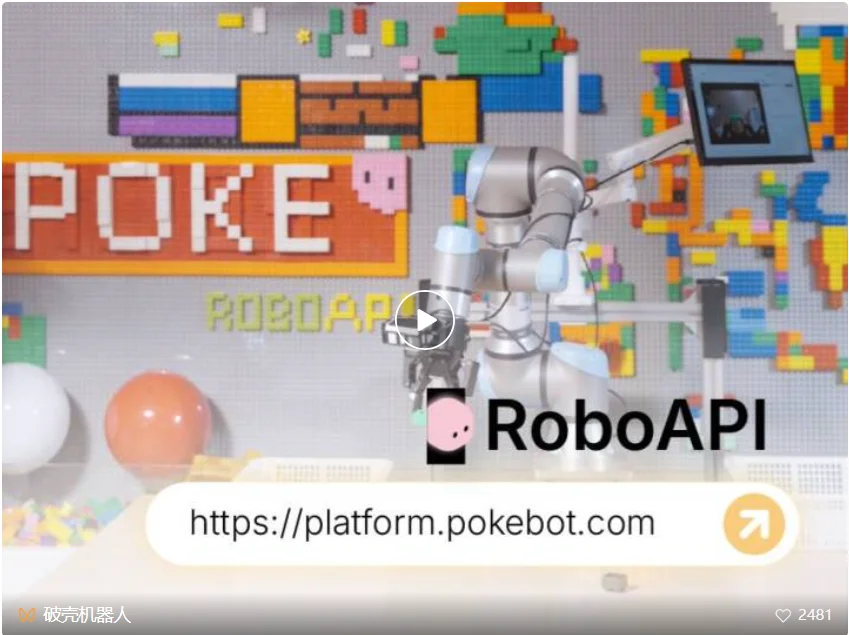
官方的Demo也给大家看一下。
大脑公司的壁垒,和云端这条路的问题
我和许老师接下来聊到了一个尖锐的话题。
天南:现在作为一家大脑公司,壁垒在哪,该往哪发力。最近感觉技术进展没那么快了,架构上也没大的突破。剩下全是极其精细的数据配比,是否对算法同学来说挺无聊的?
许华哲不同意。他的回答画面感很强,我尽可能保留原意。
许华哲:10 个活可能 9 个都是把数据搞对的脏活累活,剩下 10% 的活才是模型。 拿厨房举例子,最后颠勺的就那么仨俩人,其他人都在旁边切菜、洗菜,外围还得有人去把菜买回来。你不能说因为 90% 的活都不是颠勺,所以颠勺不重要。
这里也举个具体的例子,比如两个异构的神经网络之间怎么做 cross attention,这里面有很多门道。
同构的没啥说的,但异构的 attention 得仔细设计,不然会影响之前训练好的初始权重。
从最后的模型性能看,这类事非常重要,但能做这件事的人非常非常少。
...
Poke-Aurora 里面提出的「调制残差耦合」,就是这么个例子。 这件事也符合我自己的体感。
从我搞预研的经验上来讲,一个模型最后能不能 work,往往就卡在那两三个有感觉的人身上。其余人把基建做扎实,整个团队才能顺利往前推进。
然后聊到了一些宽泛技术细节。
天南:其实聊过的很多技术团队都说很难打过PI,许老师怎么看这个问题?
许华哲: 这个分多个因素的影响,我主要从数据角度来谈谈细节。 比如要做坐标轴原点对齐和旋转方向对齐,全部对到手腕上,统一成同一个右手系。如果不这么干,堆的数据再多也没用,坐标轴都对不齐,越学越乱。
数据检测算子要写齐全,还得做光流检测。有人相机掉帧了,往里面做插值再把数据卖给你,30 帧掉到 20 帧又插回 30 帧,这种数据不能要,得找他退货。
而标注成本可能高于买数据的成本。行业里有些人会严格控制标注预算,比如 300 块一小时买来的数据,标注预算不让超过 150。
而破壳很多时候标数据比买数据还贵。
许老师强调说破壳的思路先把单位时间里压榨出来的信息做足,再考虑怎么把这种信息量充足的数据规模化。
说完壁垒,说云端。
许华哲认为云端大脑这件事长期非常有可能,瓶颈不在模型,在通信。 网络通信已经是个老技术了,里面能做的事情有很多。
短期的办法是在任务上做约束,让模型自主判断这个任务是不是时间敏感的,如果是,它就应该拒绝去做。
...
这个思路还挺有意思的,包括我自己测 Dream-1 的时候就很卡,跨洋传输的速度很慢。
PI 之前也说过,合作方分布在日本、瑞士,有些伙伴反馈网络连通性有挑战。
其实大家也都遇到了同一个问题,这大概是这波 API 里最少被提到、但最硬的一个共同约束。
所以我会感觉,具身不单单是一个机器人和几个模型这么简单的事情。
更大范围内的公共基础设施,我觉得都会有想象空间。
顺着这个思路我们还聊到了 GPT-6,也分享下其中的insight。
第一层,他觉得 Astra 最厉害的是重新思考的能力。
当 GPT 看到一件事怎么做都做不对的时候,会回头想是不是哪里搞错了,然后换一种方法。这种模式切换非常宝贵,不管 VLA 还是 WAM,未来都应该集成进来。
模型不该只是看到一个观测就按数据里的方式解决掉,而应该多思考几种方式,A 不行要不要换 B。