


过去,在灵光闪应用中,用户需要等到应用生成完成,才能看到完整的页面设计和视觉效果。
在画眉的专业设计场景中,设计师拿到成图后,还要经过拆层处理,通常需要 5 分钟以上才能继续编辑。
一个需要更早看见设计,一个需要继续编辑设计。两个场景指向同一个问题:AI 设计还需要从“能够生成”,进一步走向“可预览、可编辑、可交付”。
今天,我们正式开源 Ming-Image-0.1-Design 系列,包含两个参数量均为 6B 的模型:
- Ming-Image-0.1-Design(下文简称 Design):从文字需求生成 UI、信息图、海报和完整视觉设计;
- Ming-Image-0.1-Design-Layer(下文简称 Layer):将创意图或者设计图拆成可独立编辑的透明图层。
同时开源 Design Skill 和 PPT Skill,将模型能力继续连接到前端页面与可编辑演示文稿。
从生成设计、拆解图层,到进入 Coding、PPT 和设计工具,这次发布希望解决的不是“再生成一张图”,而是怎样让生成结果继续被使用。
两个 6B 模型,
把设计生成和后续编辑接起来
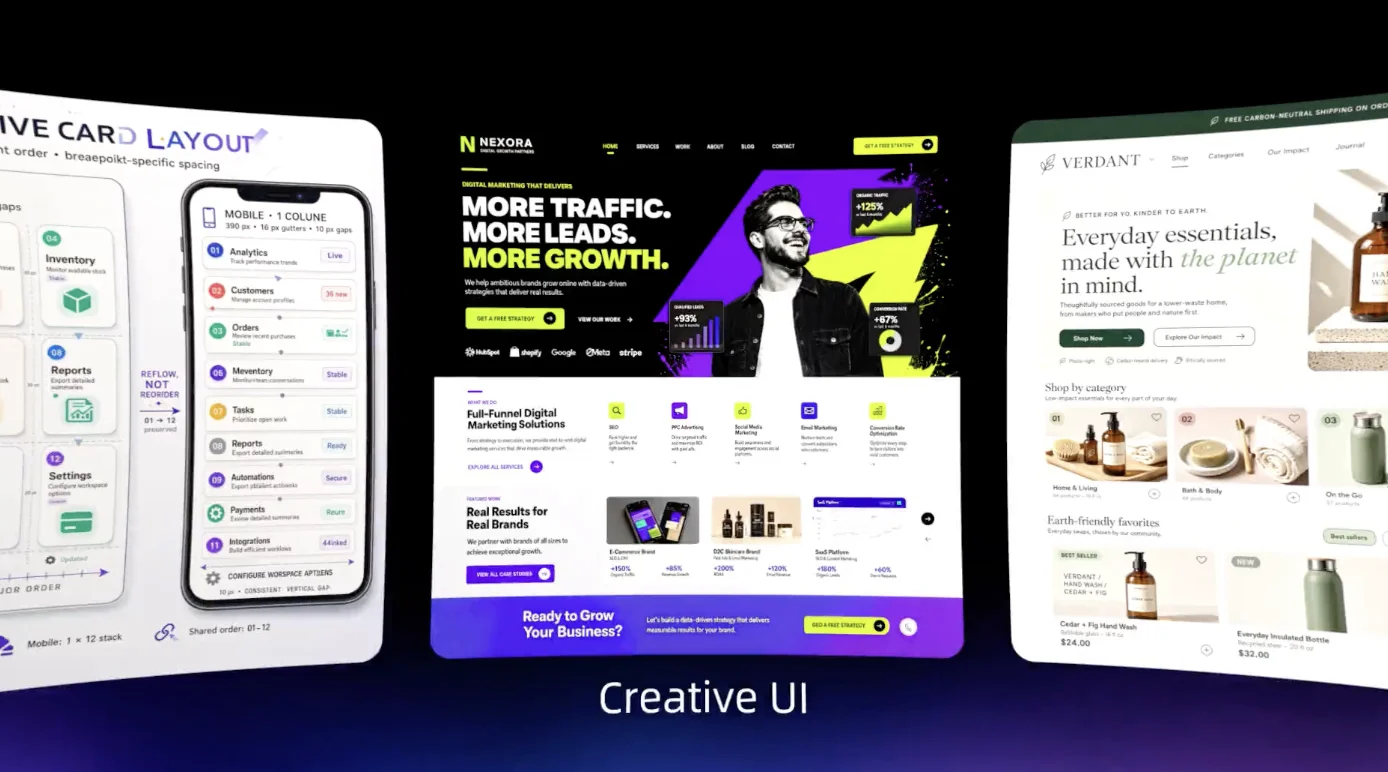
Design 先把完整设计画出来
UI、Dashboard 和信息图不同于普通图片。模型需要同时处理文字、功能模块、视觉层级、配色和布局;少一个字、按钮位置偏移或卡片关系混乱,都可能让结果无法直接使用。
Ming-Image-0.1-Design 因此重点增强了四项能力:
- 支持 8K 长结构化提示词增强,将自然语言需求组织为文案、模块、布局和视觉风格;
- 优化标题、按钮、卡片和多区域信息的文字渲染与版式稳定性;
- 通过端到端生成一次性完成整体设计,统一配色、构图和素材风格;
- 创建原生 RGBA VAE,直接生成人物、商品、图标和装饰等透明背景素材。
相比通过代码多次调用通用生图模型,分别生成背景、插画和装饰,端到端生成拥有更完整的全局控制,能够减少素材之间色系冲突和画风不一致。
Layer 将设计变成可编辑资产
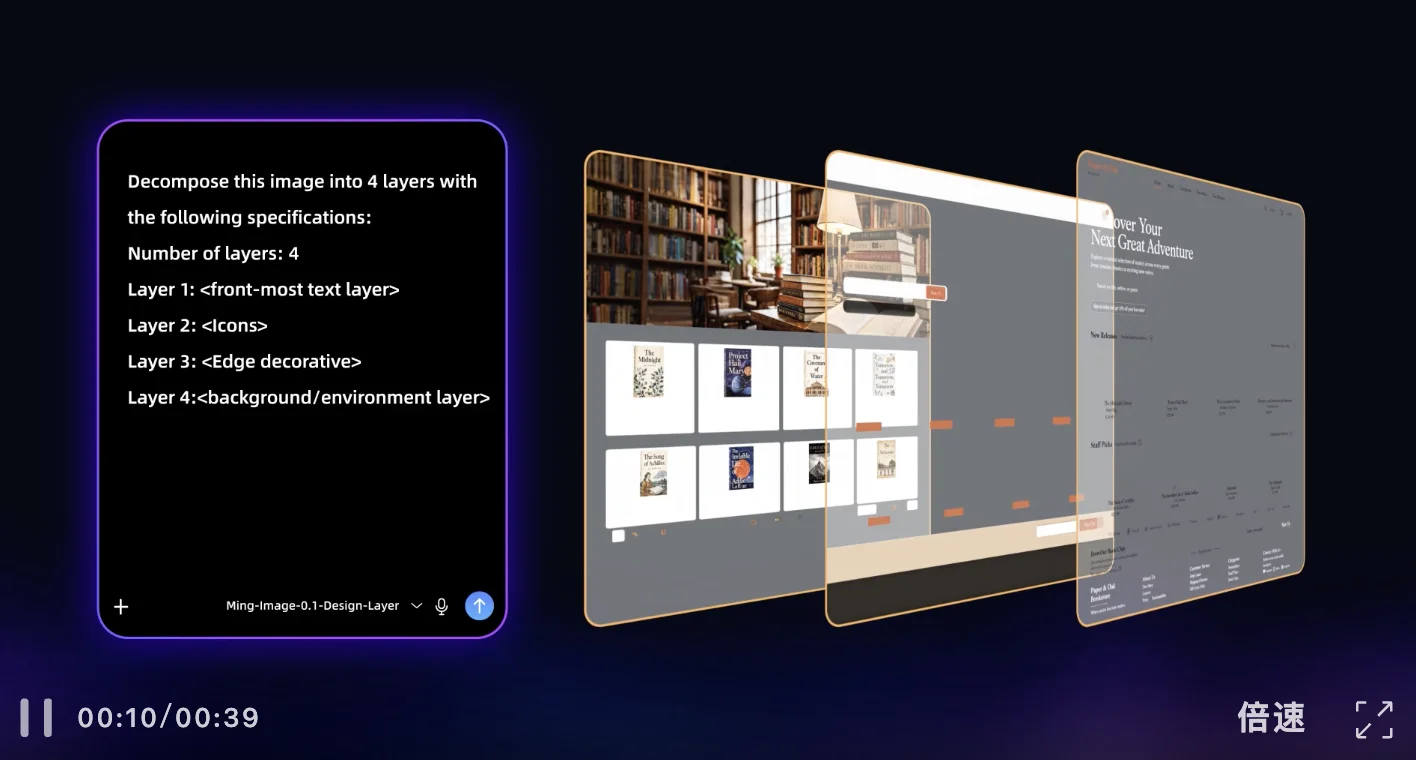
它做的不是普通抠图,而是在恢复一张设计图背后的结构。
设计生成后,文字还会修改,人物需要移动,背景可能替换,商品和装饰也需要单独复用。
Ming-Image-0.1-Design-Layer 可以将设计图拆成 2—9 个语义独立的 RGBA 图层,侧重广告海报、PPT、UI/UX、信息图、电商主视觉和模板再创作等场景。
模型按照文字、卡片、主体和背景等设计角色组织图层,保留透明边缘,补全被遮挡区域,并保障所有图层重新组合后的结果一致性。
Layer 为什么能够拆得更准
模型通过 Type Token 告诉每个图层自己承担的设计角色;Alpha-Aware Layer Optimization 重点优化透明区域和边缘;Composite-Layer Stack Consistency 则通过重新合成检查各图层能否还原原图。
对应到使用体验,就是内容分得更清楚、边缘更干净,叠回去以后也更接近原始设计。
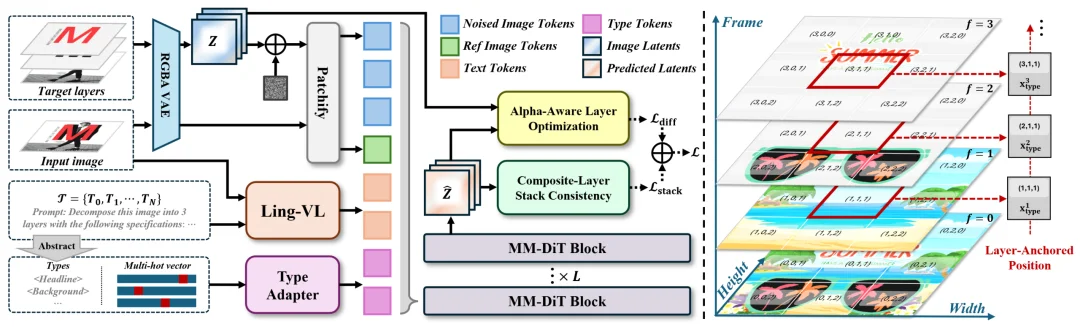
图1:Ming-Image-0.1-Design-Layer 模型架构。模型结合图层类型条件、Alpha 感知优化和重组一致性约束,使各图层保持语义独立和透明边界,并在重新合成后尽可能还原原始设计。
6B 参数进入设计模型第一梯队
Design 位列 AA UI/UX Design 榜单开源第一
在 Artificial Analysis 于 2026 年 9 月 18 日更新的 UI/UX Design 专项评测中,Ming-Image-0.1-Design 位列开源模型第 1,Elo 得分为 1082。
模型在 UI/UX 场景中的版式胜率达到 67.4%,复杂构图达到 67.0%,文字渲染达到 66.7%。
这些能力对应的正是真实页面中的核心问题:信息能否排清楚,多模块能否保持协调,文字能否准确呈现,多张页面能否使用同一套视觉语言。
在具体案例中:
- 同时包含果园地图、采摘状态、图表和操作按钮的桌面 Dashboard,Ming-Image-0.1-Design 对照 Nano Banana 2 Lite、FLUX.2 [max] 和 Krea 2 Medium,获得 12 / 12 胜出。
- 三个连续步骤页组成的食谱 App,Ming-Image-0.1-Design 对照 Nano Banana 2、Nano Banana Pro 和 MAI-Image-2.5-Flash,获得 10 / 10 胜出。
这说明 6B 并不意味着降低对复杂设计任务的要求。通过面向文字、版式和多元素组合进行专项训练,小参数模型同样可以进入大模型竞争区间。
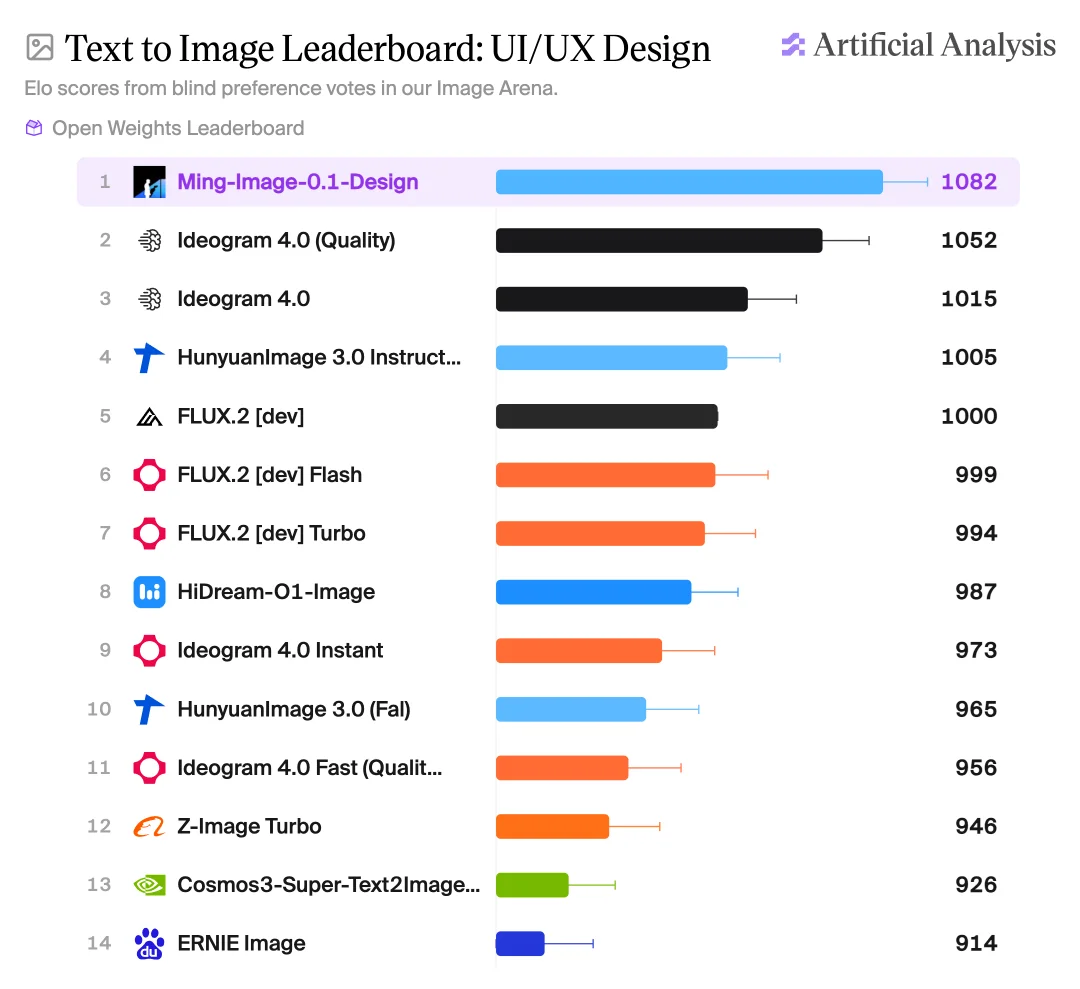
图2:Artificial Analysis UI/UX Design 开源模型排名
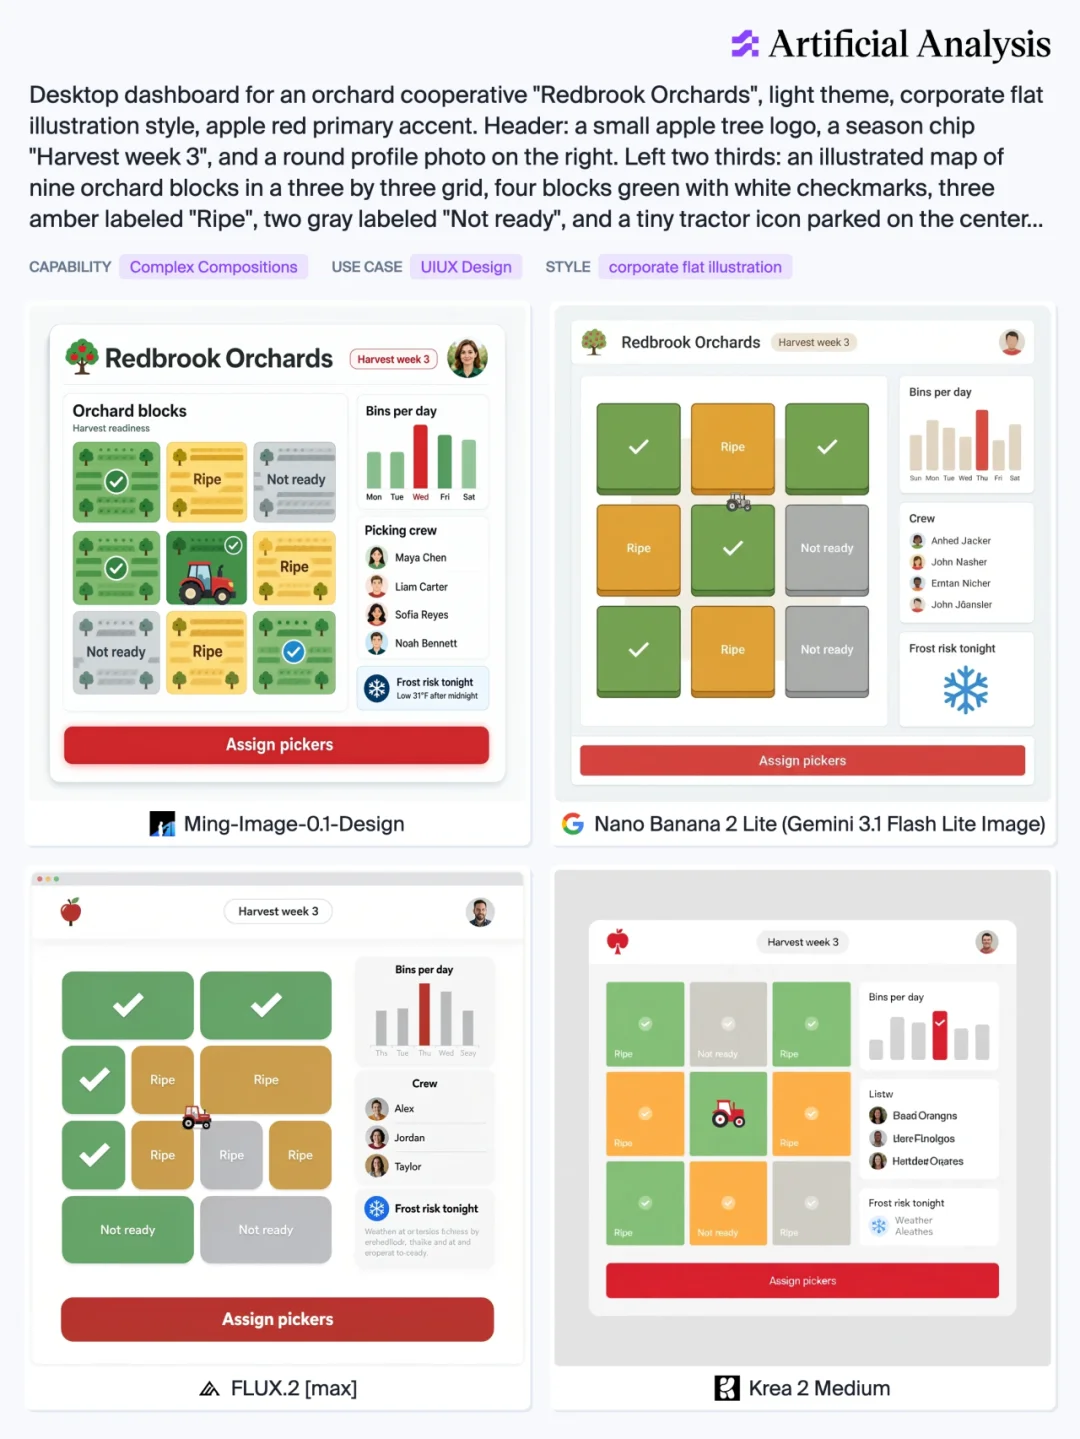
图3:果园dashboard要同时画出果园地图、采摘状态、图表和操作按钮。
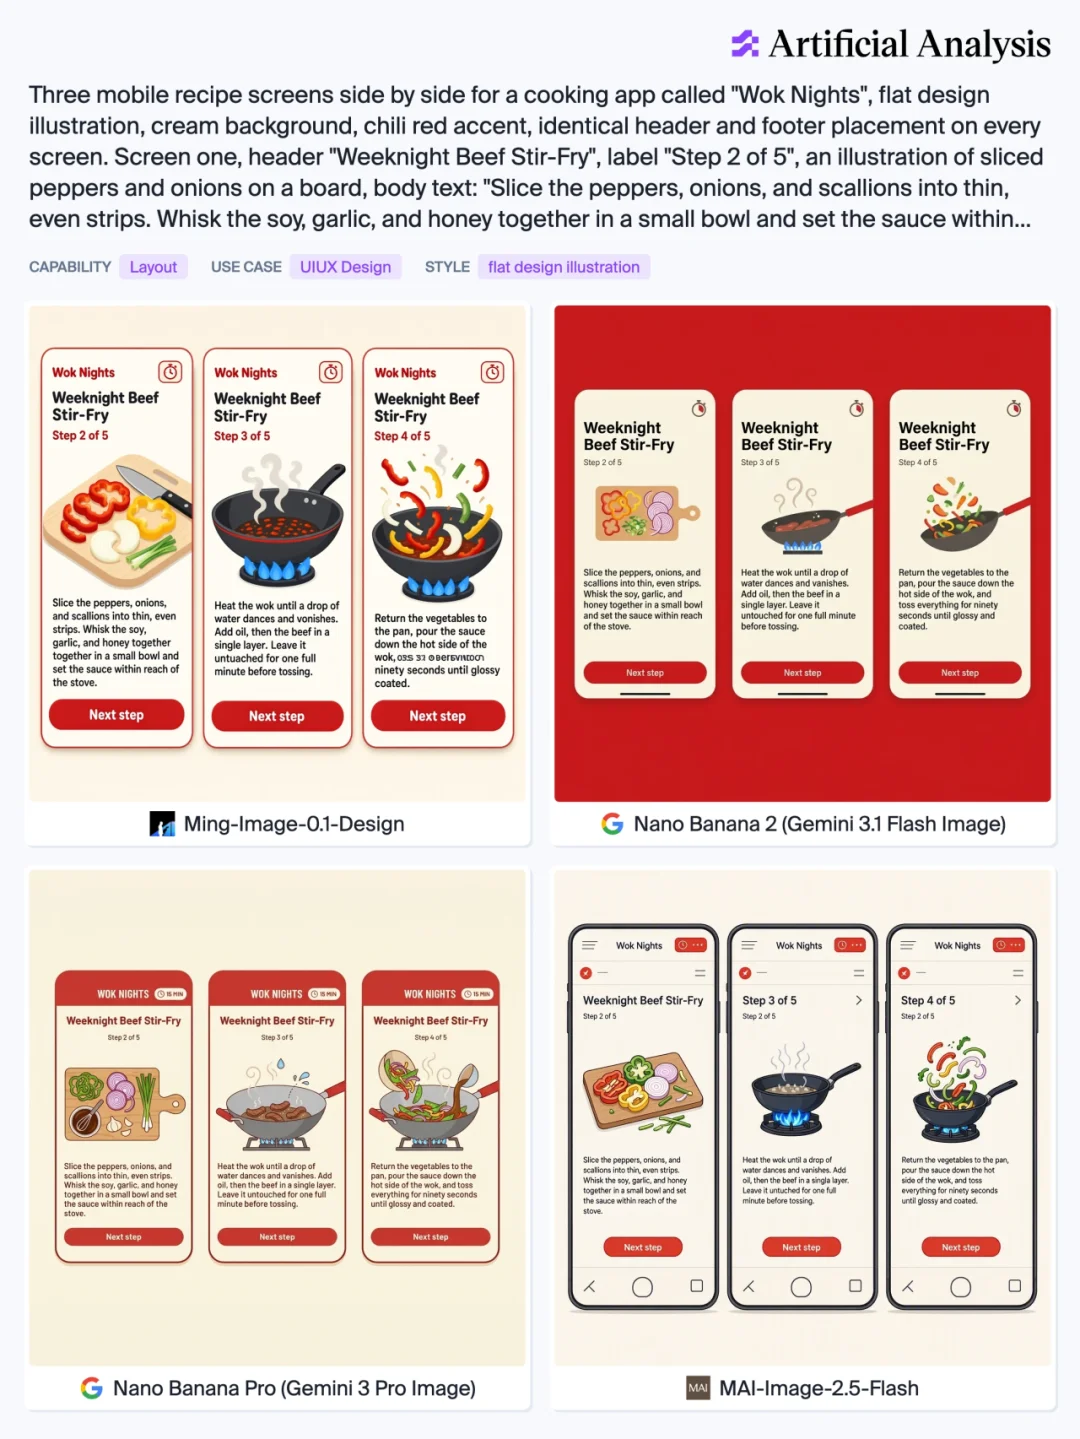
图4:三个步骤页的食谱 App 要共用同一套视觉语言。
Layer 在 Crello 12 项指标中全部最优
对于 Ming-Image-0.1-Design-Layer,我们关注三个问题:
- 不同内容是否被正确分开;
- Alpha 边界是否准确;
- 所有图层重新叠加后,是否接近原图。
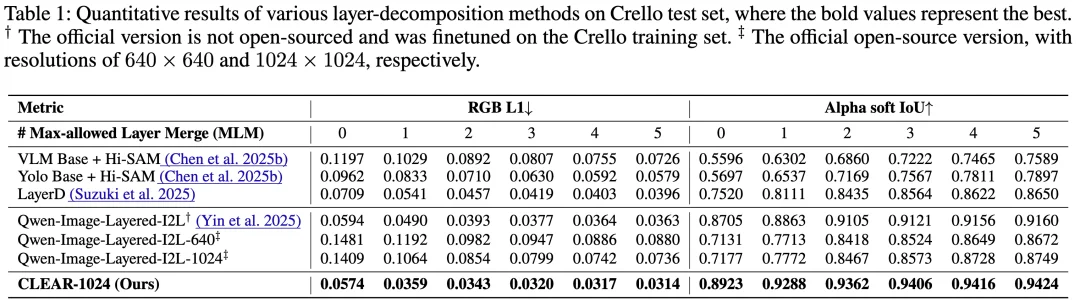
在 Crello-Test 图层解耦评测中,Ming-Image-0.1-Design-Layer 在 RGB L1、Alpha soft IoU 两项指标,以及 MLM-0 至 MLM-5 六档设置下均取得最优结果,即 12 项结果全部排名第一。
即使与未开源、并使用 Crello 训练集微调的 Qwen-Image-Layered-I2L 版本相比,Ming-Image-0.1-Design-Layer 仍全面保持领先。
在相同软硬件和统一评测条件下,6B 的 Ming-Image-0.1-Design-Layer 在质量优于 20B Qwen 官方开源版本的同时,将单次推理时间从 795 秒降低至 183 秒,速度提升约 4.3 倍。经过工程优化,当前 1024 分辨率的端到端服务通常约 20 秒即可返回完整结果。
走进真实业务,
改变不只发生在效果上
灵光闪应用:提前预览设计,最终应用高度还原
灵光闪应用让用户通过自然语言生成可实际操作的小应用。
过去,在应用生成过程中,系统虽然会持续展示编写进度,但用户要等到应用完成后,才能看到页面的布局、配色与整体效果。
接入 Ming-Image-0.1-Design 系列后,设计预览被前置到应用生成的初始阶段。Design 根据用户需求,端到端生成布局完整、风格统一的应用预览,让用户提前看到应用最终的视觉方向。随后,Agent 调用 Layer 拆解设计素材,并结合设计文档完成代码生成,使最终应用在页面结构、视觉风格与细节元素上和预览保持高度一致,带来更接近“所见即所得”的体验。
这一变化不只是让用户“更早看见”。Design 能够从全局统筹布局、配色与素材风格,减少多次生成和代码拼装造成的风格割裂、模板感与拼接感,让 AI 生成的应用拥有更完整的主题表达和更统一的设计语言,更接近经过系统设计的产品。
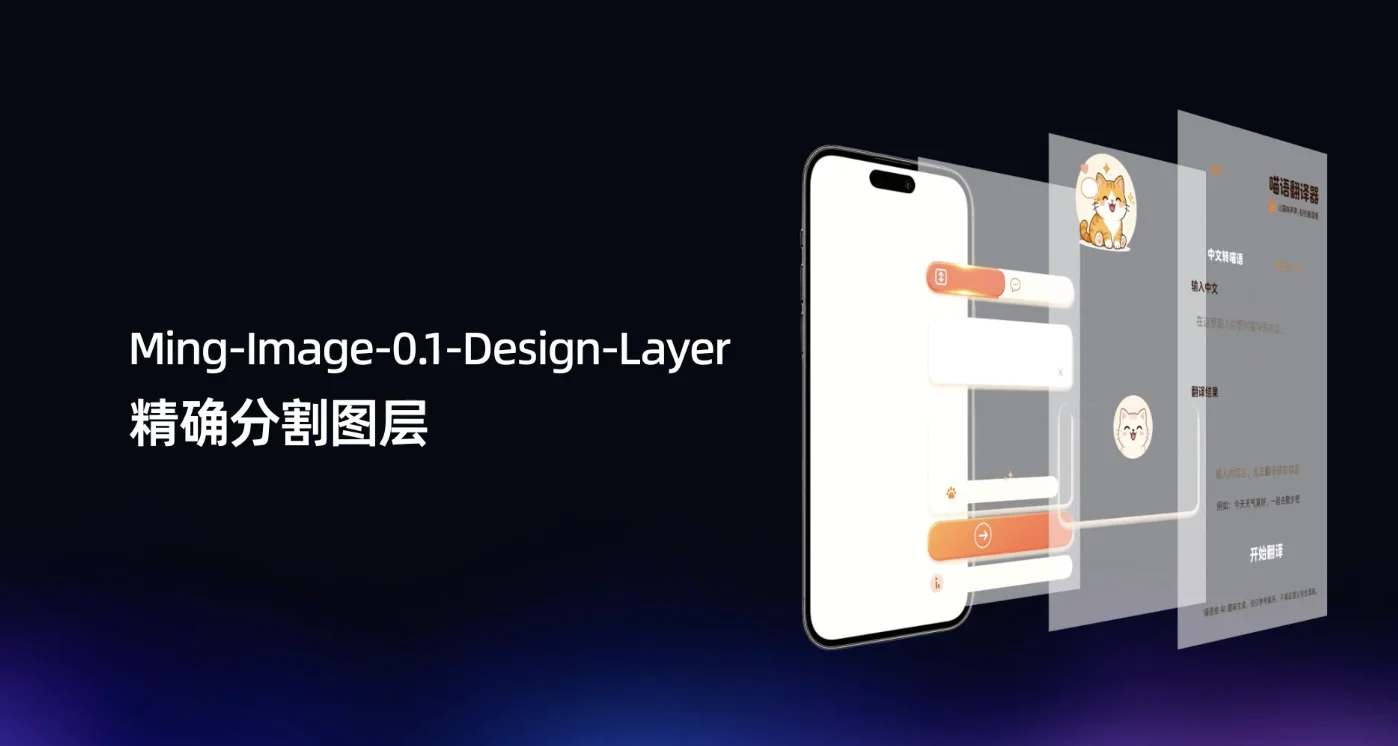
注:接入 Ming-Image-0.1-Design 系列模型的闪应用目前正在内测,将于近期与大家见面,带来更统一、更可控、更高效的应用生成体验。
画眉:从先出图再拆解,变成约 40 秒获得可编辑图层
在专业设计中,生成图片通常只是起点。文案会继续调整,主体需要移动,背景和颜色可能替换,设计也会随着需求不断完善。
旧流程需要先生成图片,再进行抠图、拆层和调整。首次获得可编辑图层通常需要 5 分钟以上。
画眉接入 Ming-Image-0.1-Design-Layer 后,可以直接将图片转换为语义独立的可编辑图层。文字、主体、背景和装饰能够分别修改、移动、隐藏或替换,通常约 40 秒即可获得分层结果。
如果只是修改少量文字,可以使用“改字”;文案需要持续调整时,可以使用“转文字”;需要移动主体、替换背景或继续精细编辑时,则可以使用“图像分层”。
在当前内部测试口径下:
- 首次获得图层:5 分钟以上降至约 40 秒,提速约 7.5 倍;
- 过去用 GPT-image2 完成改字操作,成本高出 Ming-Image 模型的 7 倍。
设计,不止于生成。支持图层编辑与文案调整,可导出 PSD 源文件,让创意持续完善。
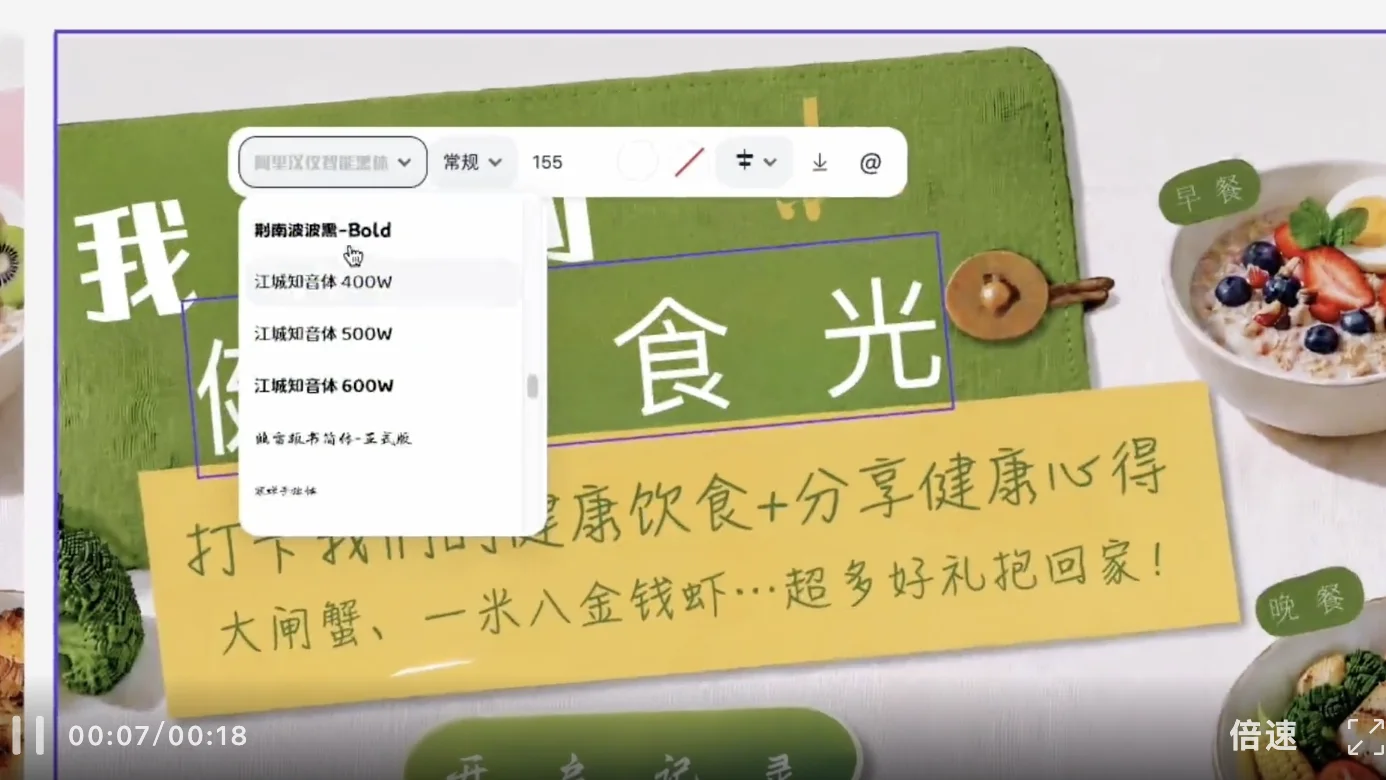
注:画眉是蚂蚁集团内部面向设计师和业务团队的智能设计应用,支持 AI 生图、文案调整、图像分层、图层编辑和 PSD 导出等能力。
从模型能力继续走向前端和办公交付
本次还同步开源 Design Skill 和 PPT Skill。
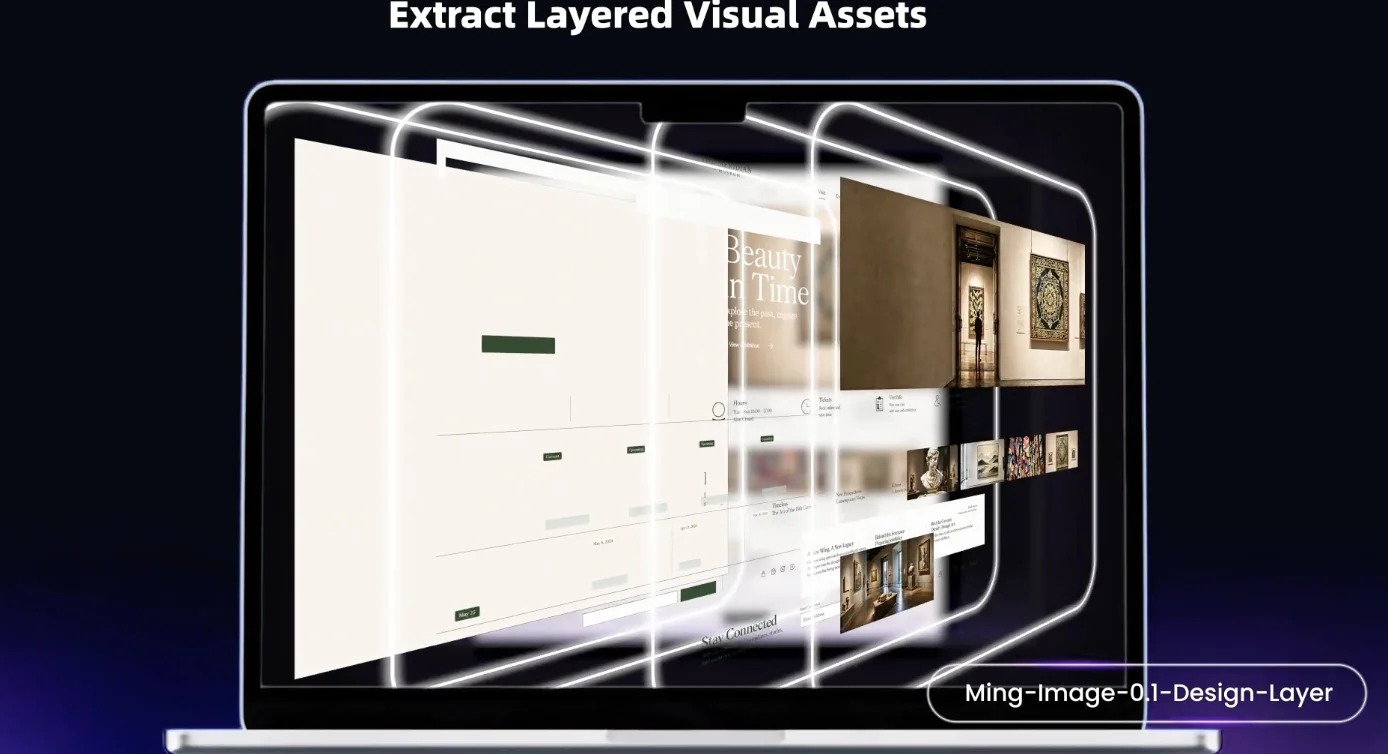
Design Skill 支持 Text-to-Page 和 Image-to-Page(Visual Coding),把 Design、Layer 和 Coding 串成一条完整链路,直接生成可运行、可继续修改的前端页面。传统 AI Coding 往往是先生成代码、再打开页面看效果,如果风格或布局不对,就要回头改代码、换素材,改动大时甚至需要重新生成。Text-to-Page 把这个过程前置成“先设计、再写代码”:用户输入一句需求,约 15 秒就能先看到完整页面方案,确认风格和布局后,再提取素材并交给 Coding 构建页面。这样首次看到结果可以从约 5 分钟降到 15 秒,在启动Coding 前先把方向选对,减少无效生成和后续返工。
Visual Coding 是“从参考图直接还原页面”:输入设计稿或截图后,通过Layer的模型先理解页面结构和视觉关系,正确拆解背景和插画等素材,再进入Coding环节;页面生成后还会通过截图与原图做视觉校验并继续修正。相比传统“看图写代码”,Design Skill把视觉理解、素材拆解、代码生成和视觉验证做成闭环,提升页面还原度,同时减少反复调代码和换素材的成本。
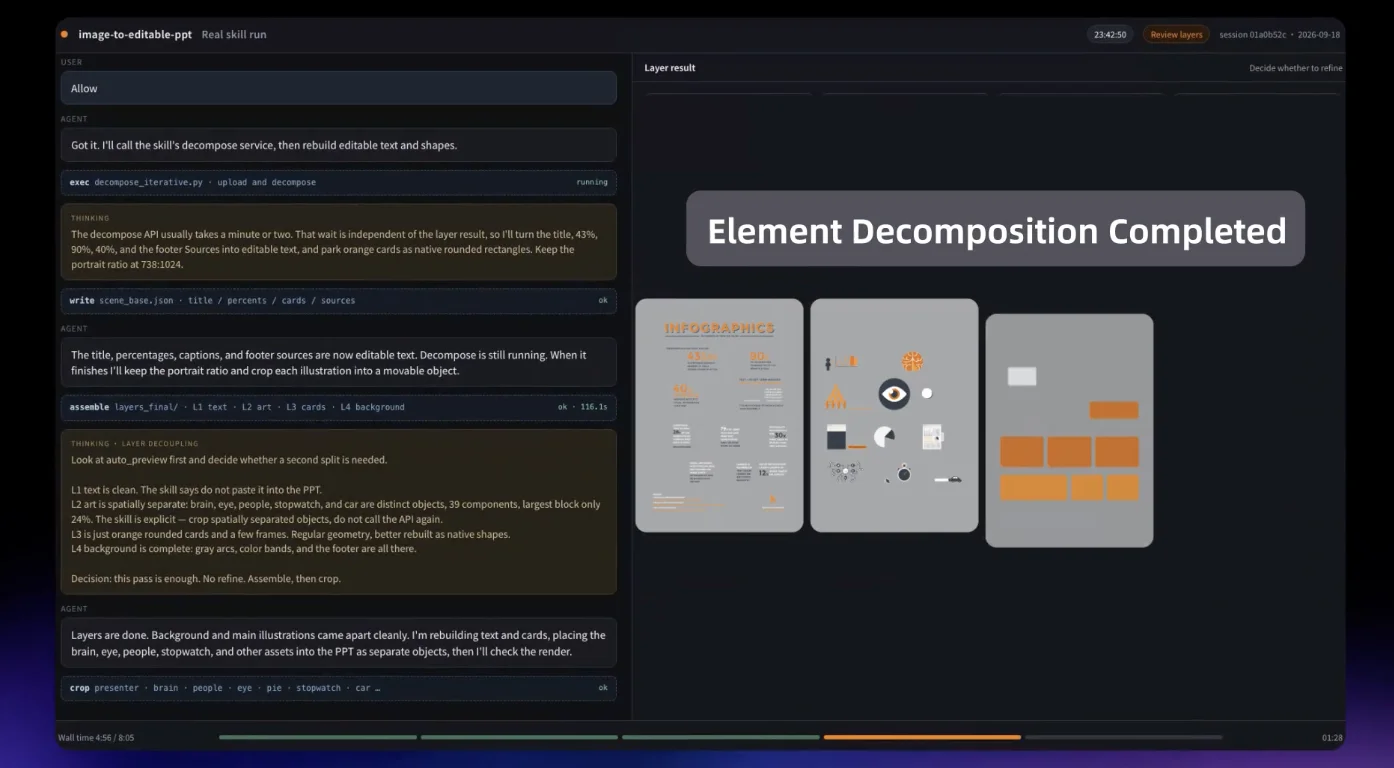
PPT Skill 可以将图片中的文字、色块和布局关系还原为 PowerPoint 中可编辑的元素。复刻所需的图标、插画等视觉资产可直接从源图中分离提取,无需额外重复生成,在保留原有视觉细节的同时,支持用户继续修改文案、字体、配色、图片和页面布局。
用于将一张设计图直接还原成可编辑的 PowerPoint 页面。它会识别图片中的文字、色块、图片和布局关系,并转换为 PPT 中可单独编辑的元素;其中的图标、插画等视觉素材可以直接从原图中提取复用,不需要重新生成。转换完成后,用户可以继续修改文案、字体、配色、图片和页面布局,在尽量保留原图视觉效果的同时,把一张“只能看”的图片变成一页“可以继续改”的 PPT。
四项能力既可以独立使用,也可以组合:
文字需求或参考图 → Design 生成完整视觉 → Layer 拆出独立素材 → 继续编辑与复用 → 生成前端页面或可编辑 PPT
对外部开发者而言,6B 参数降低了部署和二次开发门槛;模型权重与 Skills 同步开源,则提供了一套从视觉生成到应用交付的基础能力。开发者可以基于它构建设计工具、商家营销产品、办公应用和前端生成服务。
当前局限与未来计划
Ming-Image-0.1-Design 系列仍有明确的能力边界。
Design 目前最稳定的是排版和文字;但遇到复杂的人手动作、连续操作步骤,或者需要很精细的阴影、反光效果时,效果还不够稳定。
在 Layer 模型中,分层不存在唯一答案。有人只需要背景、主体、文字三层,也有人希望将每段文字和每个图标分别拆开。大量叠加光效、特殊透明材质和复杂遮挡,也可能出现边缘残留或图层缺失。
下一步,我们将继续提升文字与复杂布局稳定性,扩展图层语义和可控分层能力,优化透明效果、遮挡补全和推理效率,并将模型接入更多设计、办公与应用生成场景。
我们关注的不只是模型还能生成什么,而是生成结果能否真正进入下一步:继续改、继续用、继续交付。
即刻体验
在线体验
为方便开发者快速体验,Ming-Image-0.1-Design 已在 OpenRouter 开放为期两周的免费 API 调用。
- https://openrouter.ai/inclusionai/ming-image-0.1-design
🤗 Hugging Face
- https://huggingface.co/inclusionAI/Ming-Image-0.1-Design
- https://huggingface.co/inclusionAI/Ming-Image-0.1-Design-Layer
🤖 ModelScope
- https://www.modelscope.cn/models/inclusionAI/Ming-I