


最近,Anthropic的CEO Dario Amodei 说了一句话:
AI将在10年内,把人类在生物学上50到100年的进展压缩完成——癌症、阿尔茨海默症、心脏病,统统有望攻克。
这话说得够狠,但很多人觉得,也就听听。
直到一个叫顾全全的科学家站出来说:10年太慢了,我们要把药物研发周期压缩到4年!
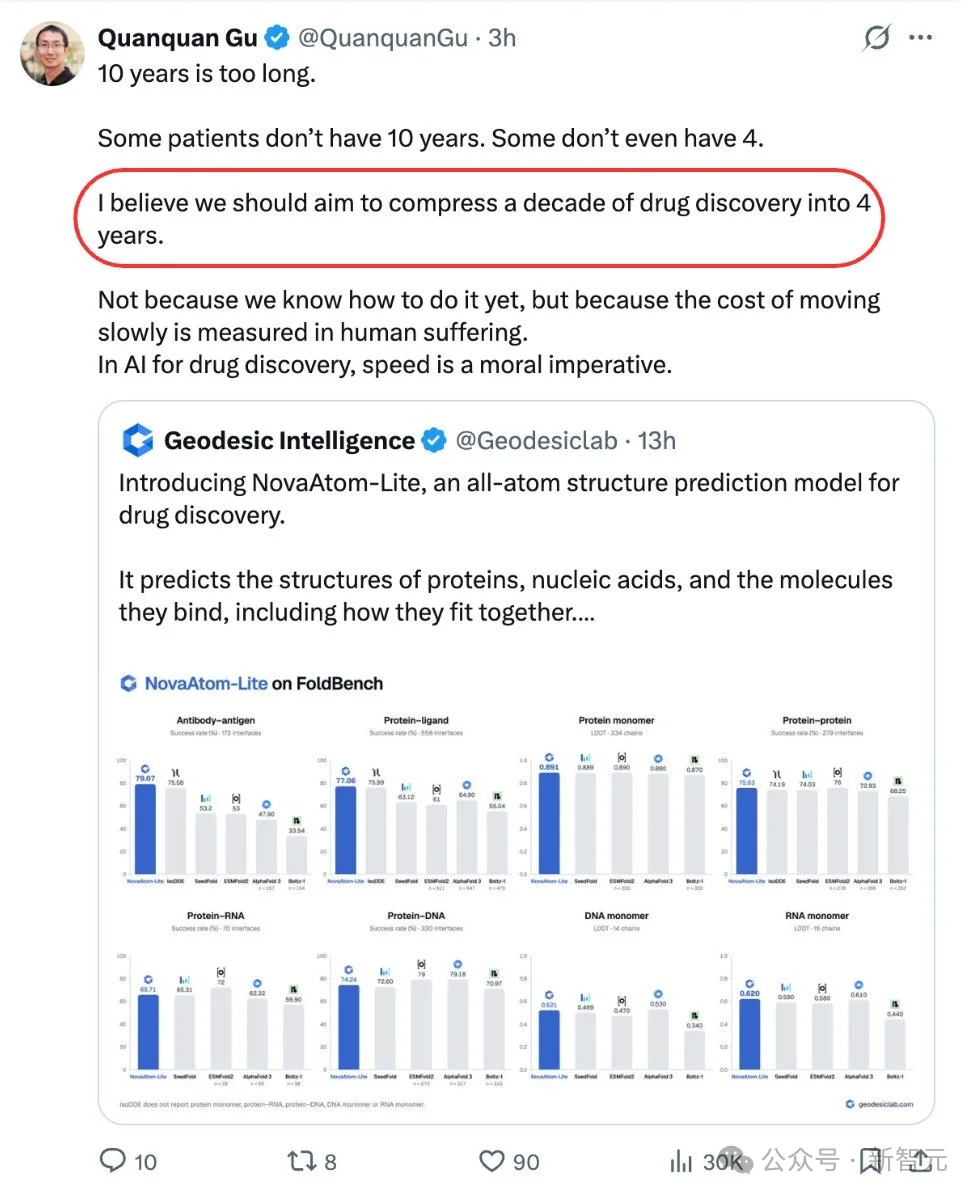
11月10日,他创立仅5个月的公司 Geodesic Intelligence,发布了全原子结构预测模型 NovaAtom-Lite。
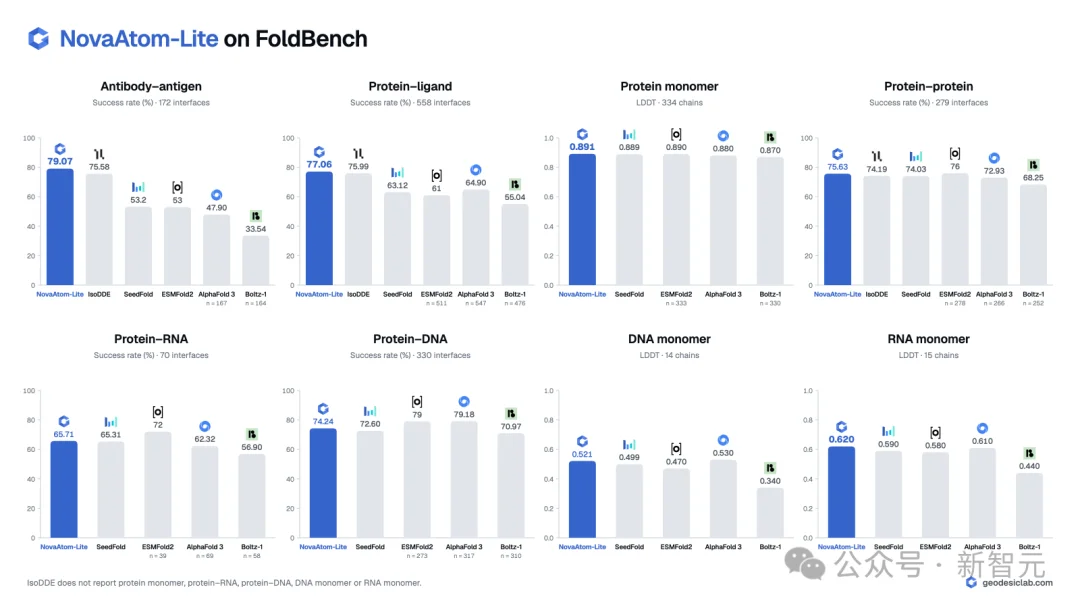
在全球最严苛的生物分子预测基准测试 FoldBench上,NovaAtom-Lite直接把谷歌 DeepMind 旗下Isomorphic Labs 的王牌模型 IsoDDE 拉下了马。
在一系列生物制药基准测试中屠榜,获得多项TOP 1!
Model card链接:https://www.geodesiclab.com/news/introducing-novaatom-lite
15个人的创业公司,几百张GPU,5个月。对面是累计融资27亿美元、正在以400亿到500亿美元估值谈新一轮融资的 Isomorphic Labs。
X上瞬间炸了。
有人感叹:「Dario Amodei 预测癌症10年内攻克,而 NovaAtom 的创始人说只要4年。」
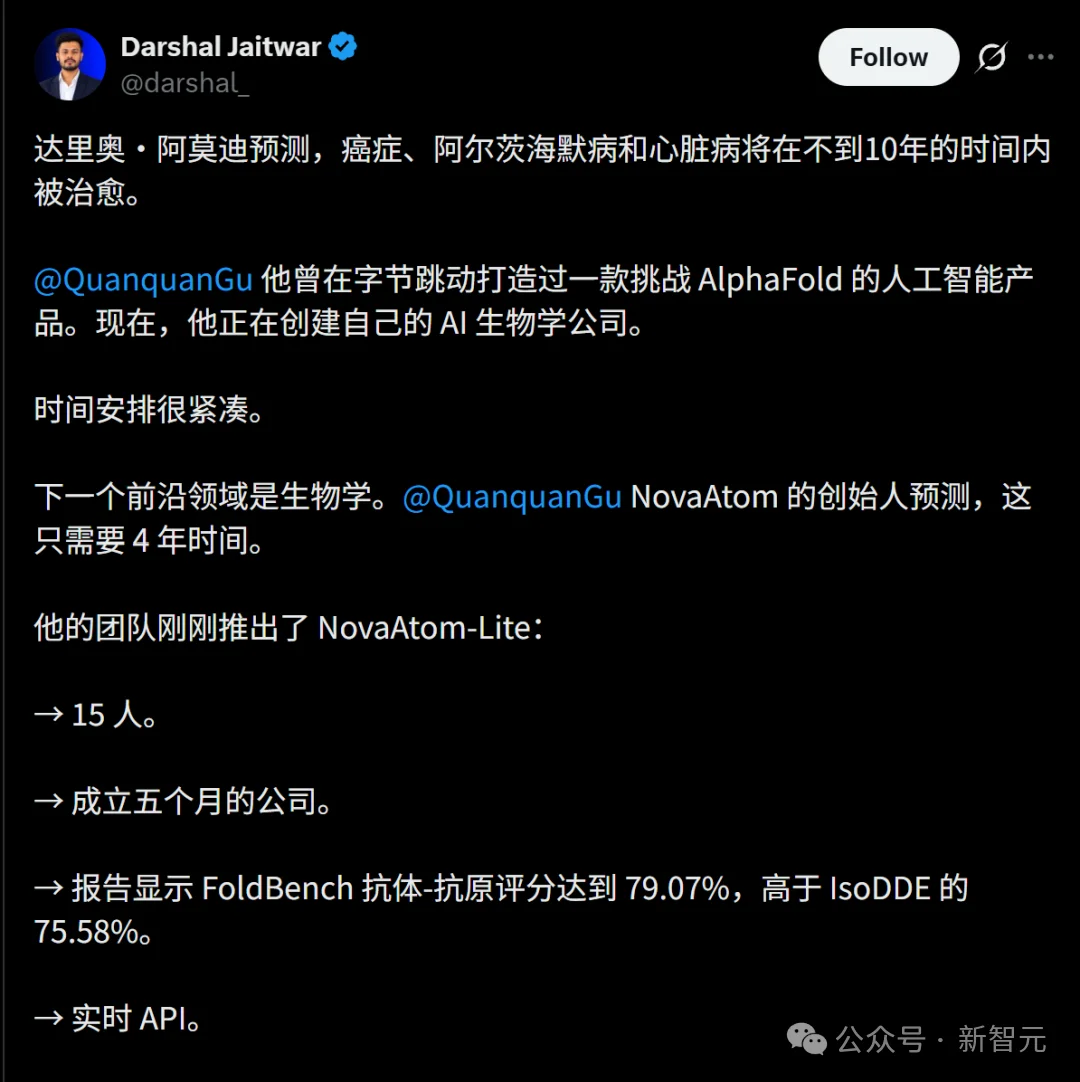
有人算账:「谷歌 DeepMind 剥离出 Isomorphic,烧了几十亿美金,估值谈到400亿以上。结果一个UCLA教授带着15个人的创业公司,5个月就超了。」
而且,这不是顾全全第一次干这种事。他之前在字节跳动带队做出了 SeedFold——世界上第一个在 FoldBench 上超越 AlphaFold 3 的模型。
正是 SeedFold 的横空出世,逼得 Isomorphic Labs 不得不祭出 IsoDDE,重新夺回结构预测的王座。而这次,NovaAtom-Lite 又把 IsoDDE 拉下马,王座再次易主。
更狠的是,根据顾全全在 X 上透露的信息,NovaAtom-Lite 只是开胃菜,后面还有更大更强的 NovaAtom-Pro 蓄势待发。
也就是说,就算 Isomorphic Labs 近期再放出更强的模型试图反扑,迎接它的可能是 NovaAtom-Pro 的又一次击穿。
这场结构预测的王座之争,顾全全已经连赢两局,而第三局的底牌他还攥在手里。
从此,人类攻克绝症的时间表,再度提前!
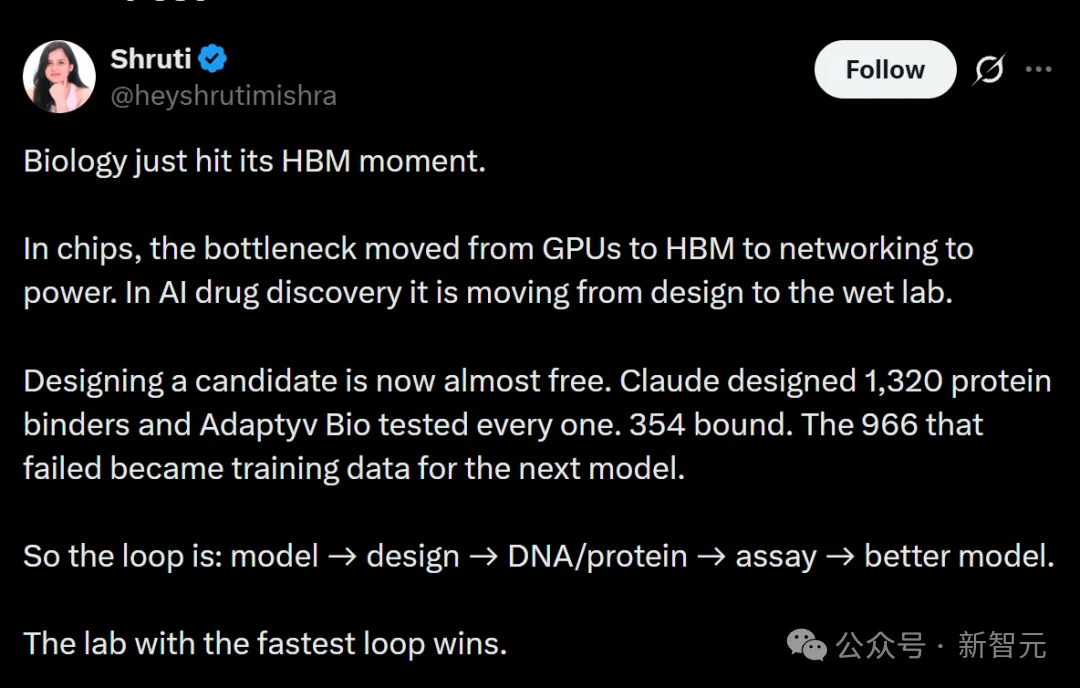
生物界已经迎来了它的「HBM爆发时刻」,投资人这样感慨
NovaAtom-Lite 到底在干什么?
为什么药那么难做?
因为药物起效的本质,是让一个分子精准地「咬住」另一个分子。
抗体要咬住抗原,小分子药物要塞进蛋白质的口袋里。
这个「咬合」发生在原子尺度——埃(Å)级别,一埃等于一百亿分之一米。
稍微偏一点,药就不灵。
传统方法靠湿实验一个一个试,平均一款新药从实验室到上市要13年、烧掉近20亿美元,成功率不到5%。AI的价值就在于:在计算机里先把这个「咬合」模拟出来,大幅缩短试错周期。
这正是 NovaAtom-Lite 干的事——
输入蛋白质、DNA、RNA的序列以及小分子配体的信息,它就能预测出整个复合物中每一个重原子(氢以外的原子)的三维空间坐标。
不是模糊的轮廓,是精确到原子级别的位置。
而且,它不是一个「死板」的计算器。
NovaAtom-Lite 加入了一套极具工程价值的「条件约束与提示」功能。
你可以告诉它:这里有一个共价键,那里有一个已知的结合口袋。模型会把这些信息当作参考线索,而不是死板约束,像一个懂化学物理法则的「AI大脑」一样,灵活地做出预测。
输出的也不只是一组坐标。
模型同时返回局部结构置信度 pLDDT、残基间预期误差 PAE,以及界面可靠性指标 ipTM——简单说,它不仅给你答案,还告诉你「这个答案我有多大把握」。
两记重拳:79.07% 和 77.06%
评价一个结构预测模型有多强,制药界有两块最核心的试金石:抗体-抗原结合预测和蛋白质-配体结合预测。
前者是大分子药物(比如抗癌抗体)的核心——你得知道抗体是怎么精准「锁住」靶点的;后者是小分子靶向药的命门——药物分子得准确塞进蛋白质的结合口袋里。
两个方向,一个比一个难。
FoldBench 是目前公认最严格的全原子生物分子预测基准,包含1522个复合物结构,数据全部来自模型训练截止日期之后的新结构,杜绝了「提前看答案」的可能。
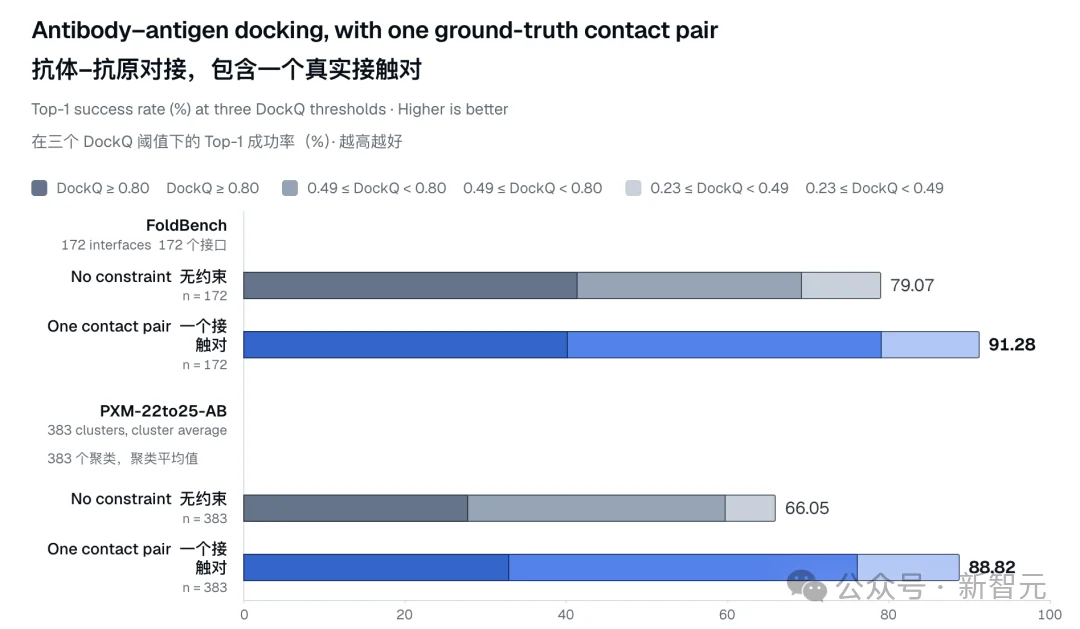
第一拳:抗体-抗原。 FoldBench 收录了172个抗体-抗原结合界面。
评判标准用的是 DockQ 分数(可以理解为预测的结合姿态和真实结构有多像,0.23 以上算预测成功,越高越好)。
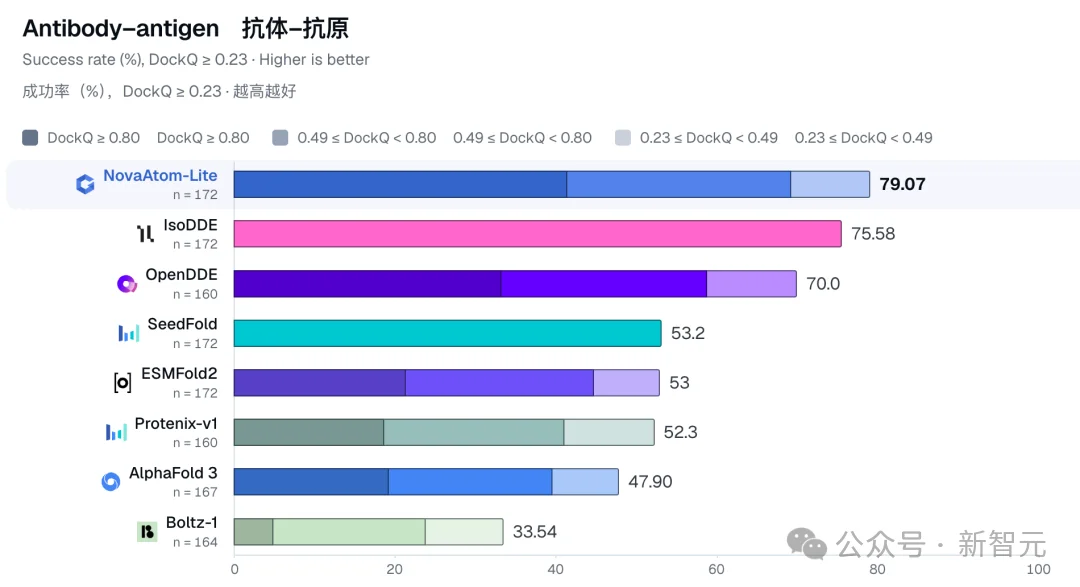
一个5个月大的公司,比 AlphaFold 3 高出31个百分点,比融资27亿美元的 Isomorphic Labs 高出3.5个百分点。
更夸张的是,如果把标准提高到 DockQ ≥ 0.80(要求极高精度的预测),NovaAtom-Lite 的成功率是 AlphaFold 3 的2.2倍。
第二拳:蛋白质-配体。 这项测试覆盖558个结合界面,判定标准更苛刻:不仅要求小分子药物的预测位置与真实位置偏差小于2埃(配体 RMSD < 2 Å),还要求周围蛋白质的接触细节也高度吻合(LDDT-PLI > 0.8)。两个条件同时满足才算成功。
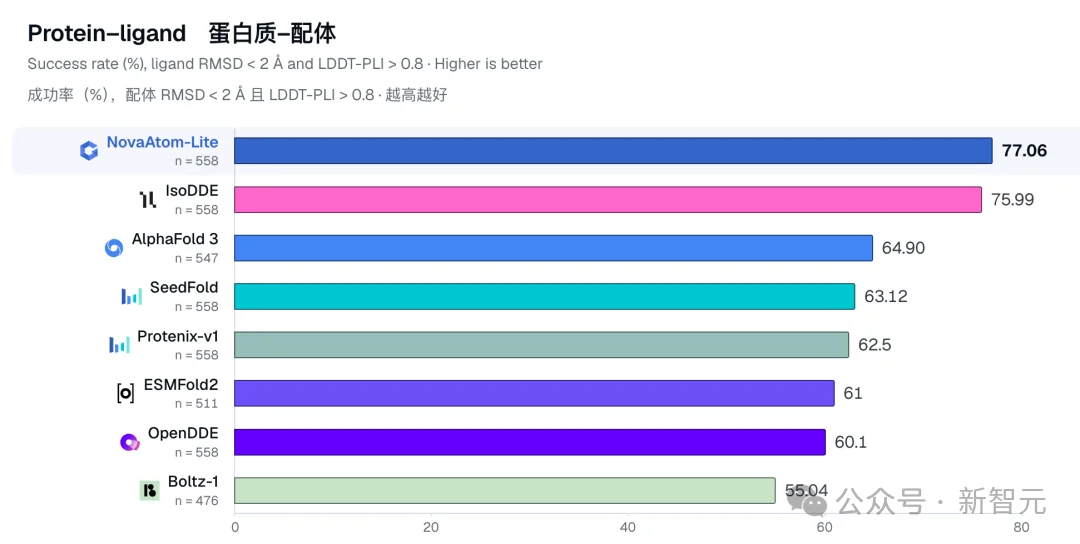
两项核心指标,全部TOP 1。
它真的「懂」物理,还是只会背答案?
每次有模型刷榜,圈内第一反应都是:你是不是偷看答案了?
这个质疑完全合理。结构预测模型吃的训练数据就是已知的蛋白质结构库,如果模型只是把见过的东西背下来了,那跑分再高也没用:真到了药物研发前线,面对的全是从没见过的新分子。
业界有一个专治「死记硬背」的狠测试叫 Runs N' Poses。它把测试样本按照与训练集的相似度分成8组,从「长得像」到「完全陌生」,一层层剥开模型的底裤。
在相似度最低的0-20%组(63个与训练集「毫无关系」的配体,相当于考试里那些完全超纲的题)各模型成绩如下:
AlphaFold 3 直接腰斩到24%,NovaAtom-Lite 依然稳在47.6%,几乎是前者的两倍。
而在相似度最高的80-100%组,两者差距反而缩小到91.0% vs 88.2%。
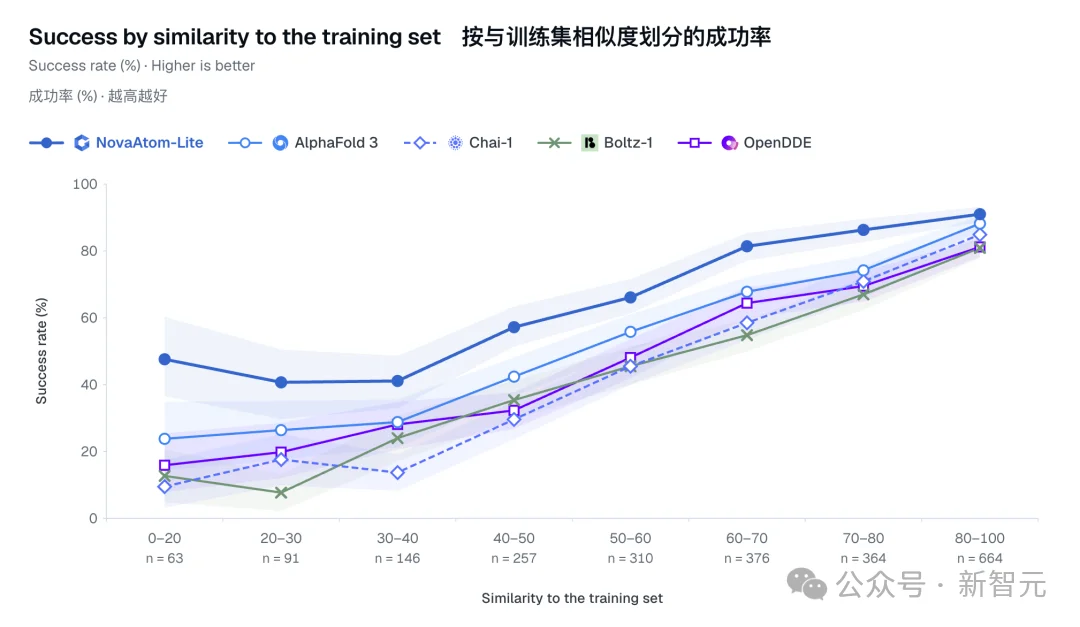
这说明越是面对陌生的分子,NovaAtom-Lite 的领先优势越大。
它不是在背书,而是真正掌握了微观原子世界的底层物理法则,拥有了一套可迁移的「推理引擎」。
给它更多时间思考,它就更聪明
做 AI 的人都知道一个趋势叫 Test-time Scaling——推理阶段给模型更多算力,答案质量就更高。
大语言模型领域早已验证了这一点,而 NovaAtom-Lite 证明,这个规律在生物分子预测里同样成立。
在同一批172个抗体-抗原界面上,团队做了一组优雅的实验:
- 1个随机种子(最少算力):成功率 74.3%
- 5个随机种子:79.07%
- 25个随机种子:81.7%
- 100个随机种子(深度推理):83.1%
- Oracle 上限(事后用实验答案挑最优解):88.4%
从74.3%到83.1%,仅仅是增加采样数量,成功率就提升了近9个百分点。
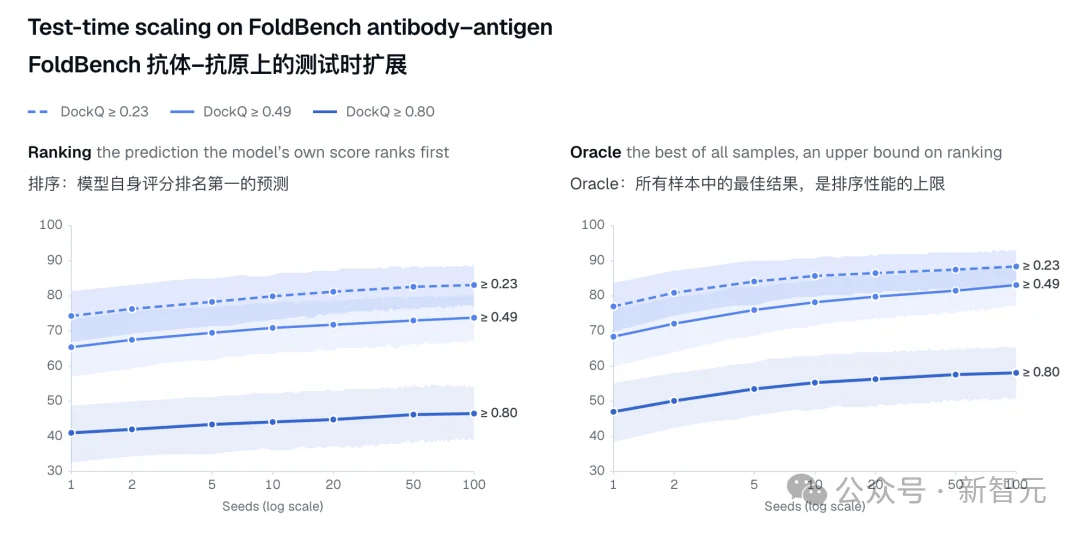
这意味着这套系统具有极强的「弹性」。
创业公司预算有限,用少量算力快速试错,依然能拿到不错的结果。而对于医药巨头来说,当一款靶向药关乎百亿市场和无数患者的生命时,你可以开足算力、全力压榨每一点精度——模型的上限远没到头。
这是极其令人兴奋的可扩展性。
给它一点提示,就能起飞
光靠自己猛算还不够。
真实的药物研发场景里,科学家手上往往已经有一些线索。比如知道抗体和抗原大概在哪个位置接触,或者小分子大概塞在蛋白质的哪个口袋里。
问题是:模型能不能「听懂」这些提示,并用好它们?
NovaAtom-Lite 的回答:不仅听得懂,而且效果炸裂。
在 FoldBench 的172个抗体-抗原界面上,不给任何提示时成功率是79.07%。只要给模型一个接触残基对(相当于告诉它这两个残基离得很近)成功率直接飙到 91.28%,提升了12个百分点。
在另一个更大规模的抗体-抗原测试集 PXM-22to25-AB(383个聚类)上,这个提升更夸张:从66.05%一口气拉到 88.82%,涨了将近23个百分点。
更有意思的是蛋白质-配体方向。
在 Runs N' Poses 上,团队测了四种设置:无约束、一个接触对、四个口袋残基、完整口袋,层层递进。
提示对最难的样本帮助最大:在与训练集相似度最低的0-20%区间,给完整口袋提示能把成功率从47.6%拉到 63.5%,提升近16个百分点;而在高相似度区间(60%以上),提升只有2到5个百分点。
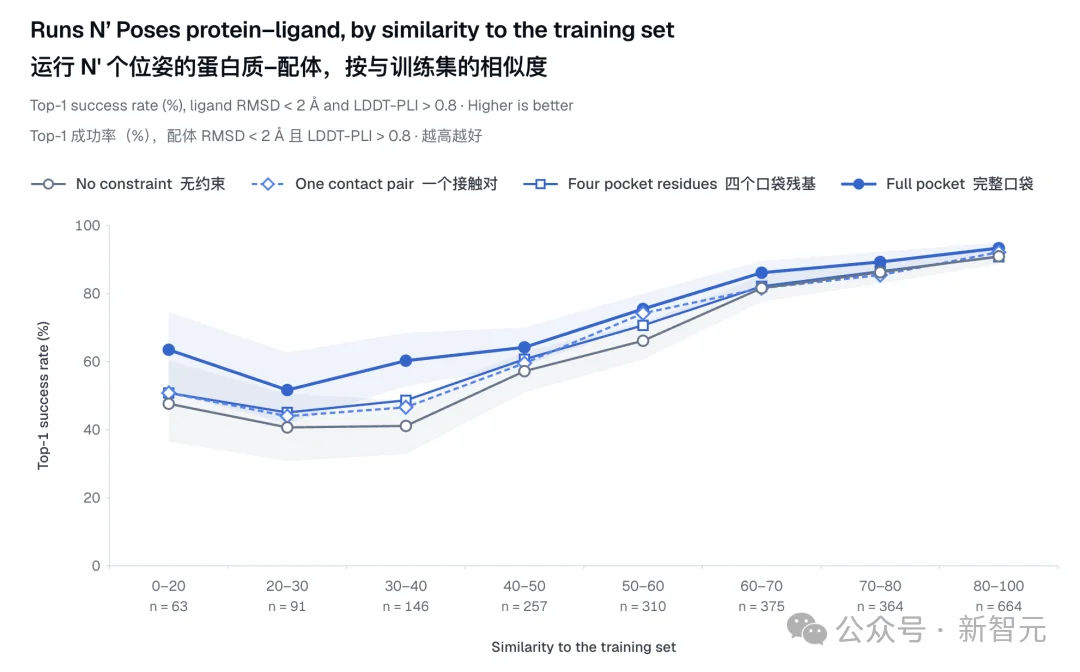
简单说就是,越是「超纲题」,模型越能从你给的线索里「悟到」更多。科学家的经验不会被浪费,你知道得越多,它算得越准。
两个「神级」案例:从分子套索到暗门破解
数字再漂亮,制药的人最终要看的是:你能不能解决真实世界里那些最棘手的结构难题?
案例一:给疯狂甩动的「分子套索」拍高清定格照
中东呼吸综合征(MERS)病毒是个凶残的对手。科学家找来了一种纳米抗体 VHH-T148 去对付它,这个抗体的核心武器是一条由22个氨基酸组成的 CDR-H3 长环。
想象一下,一条在三维空间里疯狂甩动的「软鞭」。它极度灵活,缺乏进化上的共变信号,预测难度极高。
这是结构预测领域公认的噩梦级难题。
结果,NovaAtom-Lite 生成了25个候选方案,全部命中。DockQ 达到0.839,CDR-H3 的预测误差仅为 0.56 Å,覆盖了全部18个表位残基中的每一个。
0.56 Å大约是一个碳原子直径的三分之一,这是「分子级单反相机」的定格拍摄。

案例二:让「锁着门」的癌症靶点自己把暗门打开
KRAS 是医药界出了名难搞的癌症靶点。
它表面光溜溜的,药物几乎无处下口。
有一类抑制剂能钻进 KRAS 上一个「隐藏口袋」(switch-II pocket)起效,但问题是这个口袋平时是锁着的。
也就是说,AI 不仅要算出药物小分子应该怎么放,还得凭空推测出蛋白质的构象变化——那扇门是怎么打开的。
在这个案例(结构编号 8UN5,KRAS G13D 突变体)中,OpenDDE 直接懵了,配体 RMSD 高达 17.74 Å——药物被扔到了十万八千里外。
而 NovaAtom-Lite 的配体 RMSD 仅为 0.98 Å。
不仅如此,在全部25个样本中,switch-II 区域的预测与晶体结构仅差 0.4 到 0.6 Å,并重现了全部12个天然极性接触,没有任何配体原子与蛋白质发生空间冲突。
这是真正的分子级微雕。

a16z 的「预言」:
制药业正在迎来它的 GPT-3 时刻
就在 NovaAtom-Lite 发布三天后,硅谷顶级风投 a16z 发布了一篇重磅研报——《大型制药企业,即将与大型软件分庭抗礼》(Big Pharma Can Rival Big Software)。
这份报告有几个核心判断值得细品:
第一,AI 制药正式进入「GPT-3 时刻」。
a16z 的原话是:我们认为当前 Bio × AI 的市场成熟度已接近 GPT-3 水平。GPT-3那是通用AI从「能用」到「好用」的转折点。a16z 认为,类似的能力正在生物模型中涌现。
第二,药企未来将按「科技股」定价。
传统药企的估值逻辑是对已有药物组合做现金流折现,背后的药物研发引擎几乎不被资本认可。但如果 AI 让药物发现变得「高度可重复、可预测」,投资者就会愿意为药企的 AI 基础设施买单——就像他们为 SaaS 公司的平台付费一样。
这是估值逻辑的根本性重构。
第三,11月10日发布的 NovaAtom-Lite 已被 a16z 收录进了这份研报。
一个发布仅三天的模型就被顶级资本写进了行业报告里,反应速度本身就很说明问题。这是真的被注意到了。
更