


机械臂伸向苹果,合上夹爪,接着往容器方向移动……动作很流畅,苹果却还留在桌面上。
这是当前机器人最常见的缺陷之一:动作完全符合流程,却常常达不到任务目标。
夹爪是否接触到物体、物体有没有被抬起、支撑关系如何改变,都会影响任务的完成情况。
浙江大学ACES实验室OmniAI团队的最新工作VLA-Δ,关注的正是动作示范中的这一层信息:从当前状态走向未来状态,机器人和物体应该发生哪些变化?
团队把任务进展、空间位移和接触变化变成明确的预训练目标,让动作生成所依赖的内部表征同时学习任务语义和视觉运动。
基于2B规模的视觉语言骨干,VLA-Δ在LIBERO上取得98.4%的平均成功率,并在真实双臂机器人上的五类任务中取得68.0%的平均成功率。
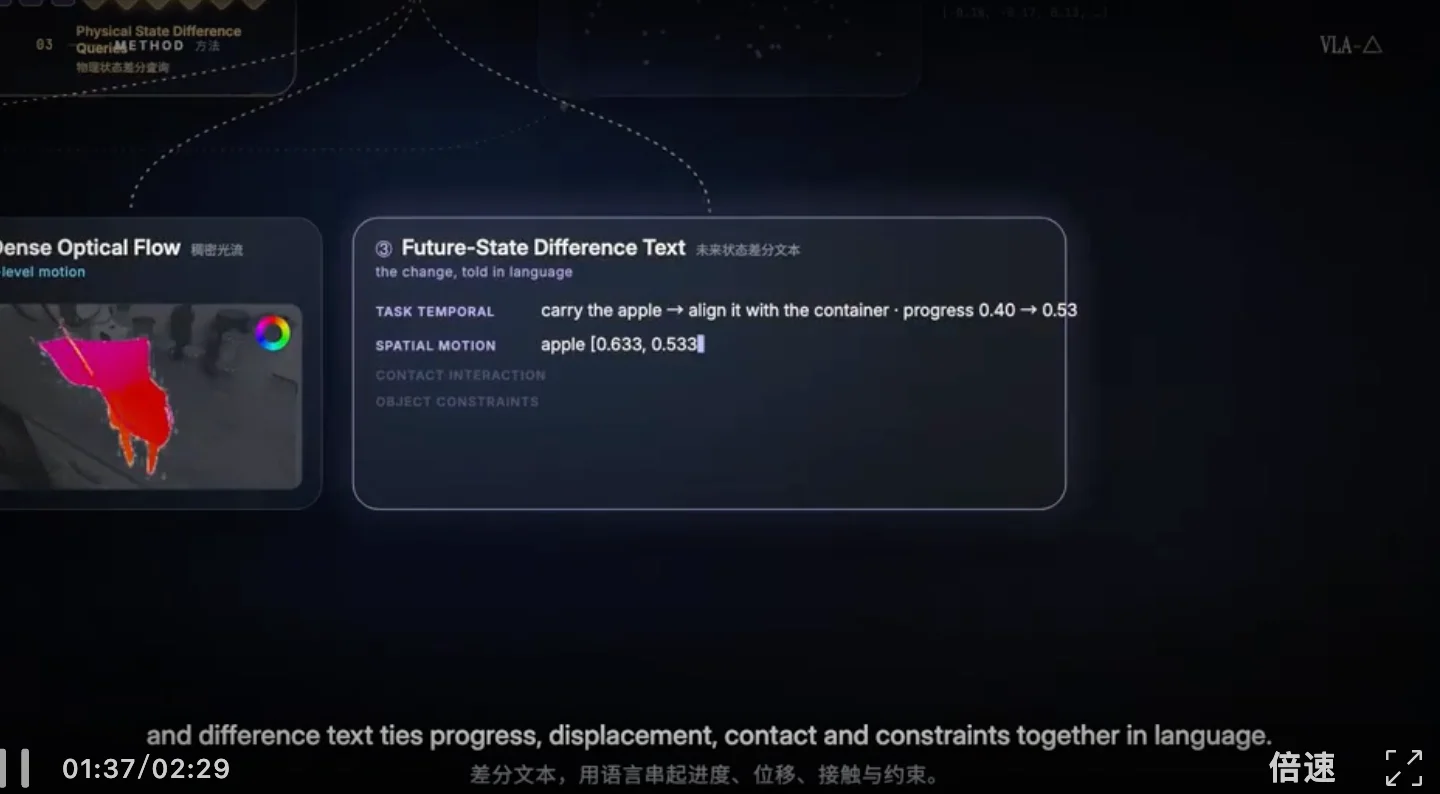
△VLA-Δ工作介绍,串起研究动机、三类状态变化监督、模型架构和实验结果。
抓取、搬运、放下,动作之间发生了什么?
现在主流的视觉—语言—动作模型(VLA),通常根据相机画面、任务指令和机器人自身状态,预测接下来的一段动作。视觉语言预训练提供了丰富的理解能力,机器人示范再把这些表征与动作连接起来。
然而,直接学习“看到什么,就做什么动作”,还可能让策略过度依赖观察与动作的对应关系。物理状态如何随操作改变,需要更直接的学习信号。
以“把苹果放进容器”为例,靠近时,夹爪与苹果的距离缩短;抓取时,二者由分离转为接触;搬运时,苹果离开桌面并随夹爪移动;释放后,苹果又获得新的支撑。每个阶段形成的状态,都会改变下一阶段的操作条件。
已有研究通过任务规划、思维链、未来图像或未来潜表示,为动作生成引入中间信息。VLA-Δ进一步把学习目标对准当前到未来之间,与任务有关的物理状态变化:哪些位置会改变,哪些接触需要建立或保持,这些变化怎样推进任务。
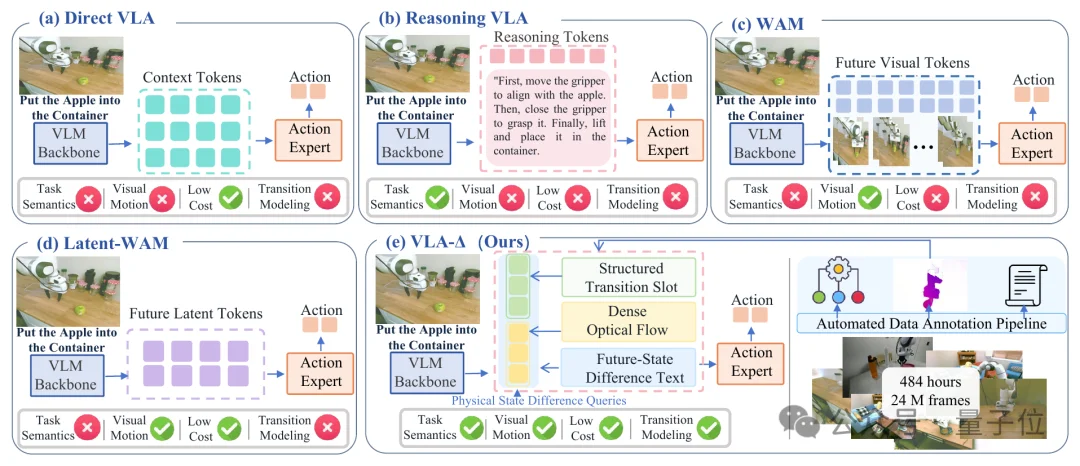
△VLA-Δ通过结构化状态变化、稠密视觉运动和差异文本,为动作生成学习物理状态变化表征。
让变化有语义,也有运动细节
VLA-Δ引入一组可学习的物理状态差异Queries(Physical State Difference Queries)。这些Queries根据当前图像和任务指令提取状态变化表征,动作专家再结合机器人自身状态,生成连续动作段。这些Queries可以理解为动作专家读取的一组内部信息载体。为了让它们包含有用的变化信息,研究团队引入三类互补监督。
结构化变化槽位:明确关键状态及其变化。
Structured Transition Slots将任务进度与阶段、目标和夹爪的位置、运动与相对位移、可交互位置、夹爪与接触变化、障碍物风险等信息,组织为九类监督目标。
这些目标让变化表征具有具体含义:当前处于哪个操作阶段?目标在哪里?夹爪即将闭合还是释放?接触关系将如何改变?
相关监督还鼓励不同Query组形成语义分工,共同支持动作生成。
- 稠密光流:保留细粒度视觉运动。
接近物体、调整夹爪和精确对齐,都涉及细小的局部运动。
VLA-Δ使用同一视角下当前帧与后续帧之间的光流,以稠密二维位移补充这些细节。光流本身无法区分哪些运动与任务有关,因此还需要结构化槽位和差异文本提供语义约束。
- 未来状态差异文本:把局部变化串成任务进展。
Future-State Difference Text用连贯的自然语言,描述当前到未来之间的任务进展、空间变化、接触变化和操作约束。在学习这类文本时,当前图像和指令信息需要先经过Queries,再用于文本预测。这鼓励内部表征保留能够解释任务变化的语义内容。
三类信号共同训练这组表征,随后由动作专家结合机器人自身状态,通过Flow Matching生成连续动作段。
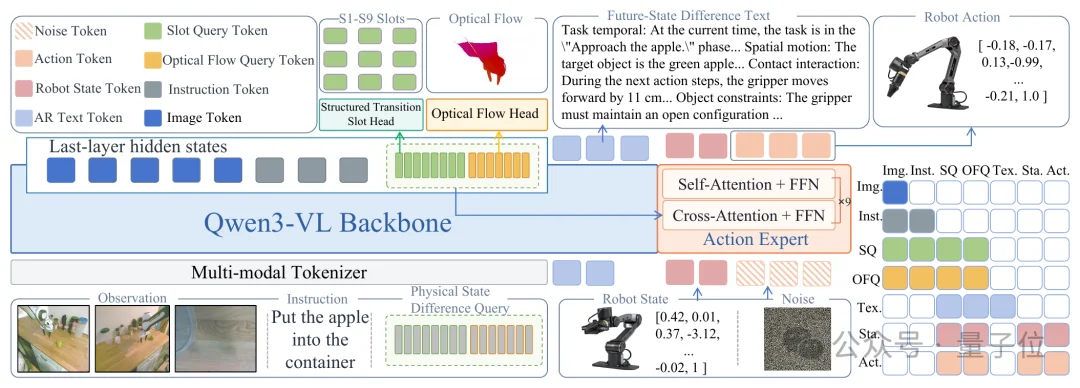
△Queries汇集视觉语言信息,通过三类监督学习状态变化,并为基于Flow Matching的动作专家提供条件表征。
让机器人示范提供更明确的变化信息
为了支持上述学习目标,研究团队基于DROID、MolmoAct和RH20T的机器人示范构建预训练语料。论文报告的语料规模约为484小时、2400万帧,并配套设计了自动化标注流程。
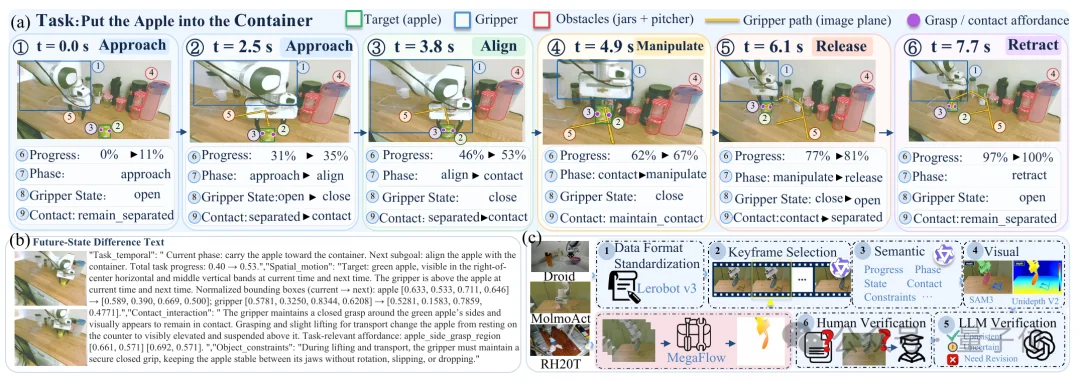
△以苹果搬运为例,展示操作阶段、任务进度、夹爪及接触变化,以及多层次标注的构建流程。
这些变化知识,能带来多少操作收益?
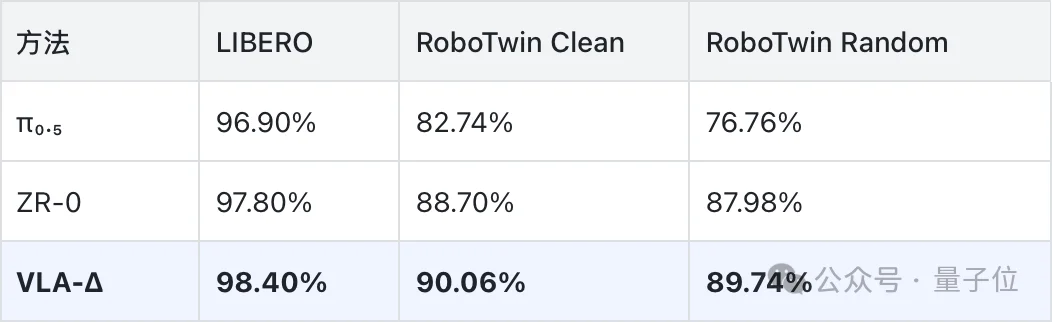
在LIBERO的40个任务中,VLA-Δ取得论文对比方法中最高的平均成功率。在RoboTwin 2.0的50个双臂任务中,VLA-Δ在Clean和Random两种设置下均取得对比方法中最高的平均成功率,分别比ZR-0高1.36和1.76个百分点。
把变化表征用到真实机器人上
在真实世界中,研究团队使用AgileX PiPER六自由度双臂平台,设计了避障、长程执行、精细操作、空间推理及背景变化泛化五类任务。每项任务测试40次,共完成200次测试。
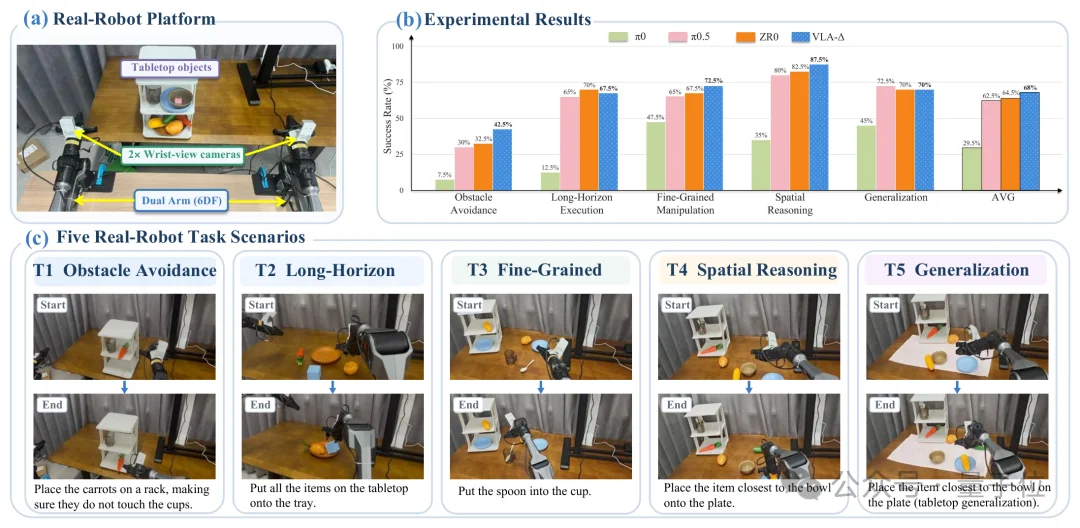
△真实机器人上的平均成功率为68.0%,π₀.₅为62.5%,ZR-0为64.5%。
VLA-Δ在五类任务上的平均成功率为68.0%,比π₀.₅高5.5个百分点。其中,避障、精细操作和空间推理三类任务的成功率分别为42.5%、72.5%和87.5%,均为图中对比方法的最高值。从这些测试可以看到,预训练中的状态变化监督也能支持真实操作,覆盖需要考虑接触、空间关系和操作约束的任务。
动作示范中的变化,值得被直接学进去
一次抓取或放置,都会改变物体的位置、姿态或接触关系。示范轨迹记录了动作,也记录了这些动作在环境中产生的结果。VLA-Δ将其中与任务相关的变化转化为明确监督,用差异文本连接任务语义,用结构化槽位描述关键状态,用光流保留运动细节,再让统一表征支持连续控制。把物理状态变化作为可训练、可检验的学习目标,为视觉语言知识如何更好地服务机器人操作,提供了一条具体路径。
作者介绍
浙江大学OmniAl团队致力于大模型与智能体、多模态空间推理、具身智能和情感交互等方向的研究。作者卢琦为浙江大学硕士一年级学生,张文祺与张旭鸿为共同通讯作者,张旭鸿为OmniAl团队负责人。
论文:https://arxiv.org/abs/2610.21306
项目主页:https://zju-omniai.github.io/VLA-Delta/
代码:https://github.com/ZJU-OmniAI/VLA-Delta
文章来自于微信公众号 “量子位”,作者 “量子位”