


家人们,真的有人能同时管理多个线程Agent吗....
前两天在推特上刷到一条求助,简直是广大 AI 用户的嘴替:
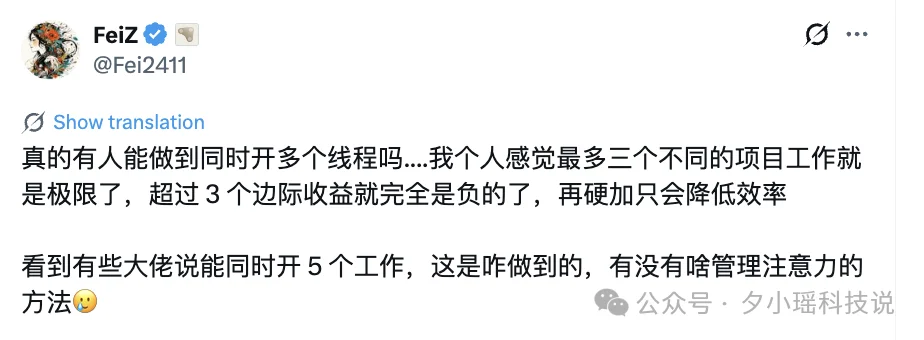
如果你高频使用Agent,肯定懂这种崩溃。
本来以为多开几个Agent能「一人成军」,结果真开到第4个窗口,人就崩溃了。。
在各个对话中切来切去,刚写好A的下一句提示词,B又弹窗等确认,回头C卡死了。
一天下来,活没干完,人先废了。
很多人都在问,那些说自己能同时开5个、10个Agent的人,到底是怎么管住注意力的?
巧的是,OpenAI 最近刚放出了一份极其夸张的客户案例。
一家叫Third Moment Research的量化初创公司,分享了他们跑Agent的几个数据:
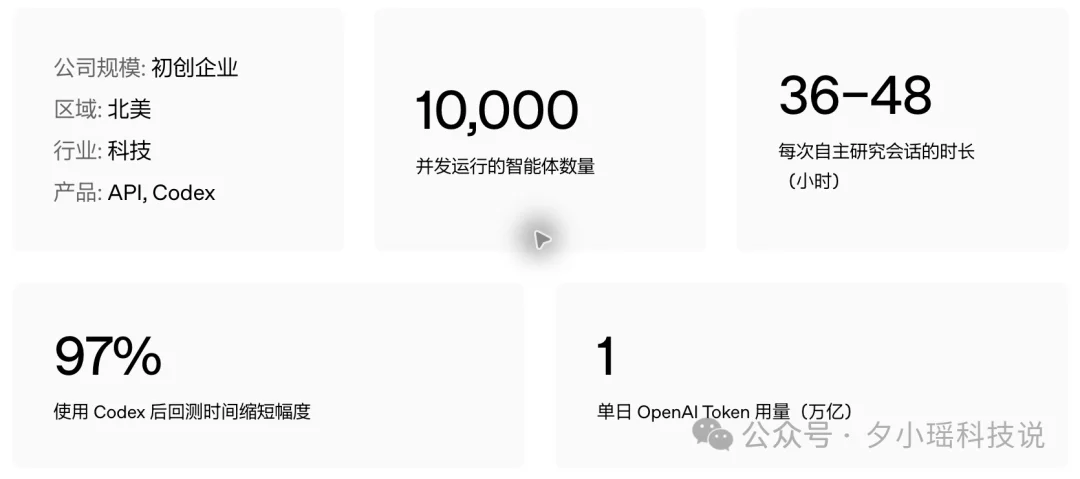
- 10000个Agent同时在线并发
- 单次研究任务连续跑36到48小时
- 单日峰值消耗1万亿Token
我把这篇工程报告扒了个底朝天,发现管5个Agent和管10000个Agent,规模差了2000倍,但底层的算术题其实一模一样。
下面,我就结合自己管理十来个Agent的经验,跟大家分享一些Agent管理心得。
先算一笔时间账。
假设一个Agent每干十分钟,就要找你处理五分钟。
你手里只有一个的时候,还能应付;同时开五个,它们找你的速度,很快就会超过你处理的速度。
这也是为什么,有时候多开一个窗口,工作反而更慢了。。
其实早在2004 年,人机协作领域就用过一个Fan-out(扇出)公式,专门算一个人最多能同时盯几台半自动机器:
text可监管数 ≈ 1 + fractextAgent 能独立跑多久text每次接手要花多久
FO=AT/IT,AT为两次指令间的活动时间,IT为交互时间
把刚才那笔账代进去算一下,AI自己跑10分钟(分子),你每次接手花5分钟(分母),算出来是 1 + 10 div 5 = 3。
在这个时间账本下,只要你的操作习惯不变,哪怕你开10个窗口,同一时间真正在干活的也只有3个,剩下7个全在排队挂机。
想突破 3 个的极限,甚至像Third Moment那样管住10000个,做法其实全写在这个除法公式里了:
- 把分子拉长让Agent自己一口气跑的时间尽可能长;
- 把分母压短把最耗神的看日志、做验收甩出去,加快自己接手的速度。
下面我们顺着这两步,看看具体怎么落地。
◈一、拉长分子:
大家玩Agent,应该遇到过这种情况:
派它去做个任务,刚开始有模有样,跑着跑着突然就陷入无限死循环,把你的API额度刷得一干二净;要么就是半路卡死,等你进去捞它。
Agent一旦卡死,就必须有人进去把它捞出来。这部分花掉的时间,直接决定了你手底下能同时放几个Agent干活。
Third Moment最早在做美股量化策略时,就一头撞上了这个问题。
他们给每个Agent 配了1TB的历史行情数据、代码库、GPU 训练集群和回测引擎,本以为能坐等AI挖出神仙因子。
结果一查后台执行轨迹,团队当场给整不会了。
这只Agent居然开始抓狂了。。
因为数据庞大,所以跑完这个测试系统至少需要3个小时。
人类面对一个3小时的进度条,还能去喝杯咖啡摸个鱼;但Agent它只认一条死理:
任务已发出,我必须拿到结果。
等待的3个小时里:它每隔一会儿就调一次工具,疯狂敲门问系统:
“跑完了没?”“现在好了吗?”“怎么还没出结果?”
Agent: [调用检查状态 API]
System: 运行中...
Agent: [调用检查状态 API]
System: 运行中...
...(此处重复几百次)
这直接把现场变成了灾难片:
- Token 在轮询里疯狂蒸发;
- 上下文被完全污染。对话里被密密麻麻的「正在运行…」垃圾日志塞满了。等3小时过去真拿到数据时,它脑子早就宕机了。
逼得人类频频进场擦屁股。。
套进前面的Fan-out公式里就是,分子直接归零,分母无限拉长。
摸清病根后,团队让Codex对整套回测底层做了次性能剖析。
Codex自己揪出了数据读取和内存占用的冗余,写了一套缓存优化方案,把修复补丁推到了生产环境。
结果,效果极其惊人:
Agent轮询的耗时从3小时缩短到了3到5分钟,削掉了97%以上的等待间隙。
没了无休止的“敲门轮询”,上下文瞬间清爽了。
落到咱们日常管手里的Agent,怎么防止它卡死、拉长独立运行时间?
核心就是,遇到慢任务别让它在窗口里傻等刷屏,让它把长日志写进文件,保持上下文干净。
如果连续两轮、大约十分钟,Agent既没有新消息也没有新文件,就算卡住。
这时候让它回原任务里找阻塞在哪,接着已有的文件往下做。
真恢复不了,才重新起一个。
把这些话提前写进去,子会话出问题的时候就不用你重新读一遍上下文了,它自己就能从死循环里退出来,或者让主会话把失联的分支拉回来。
◈二、 压短分母:把「监工」换成AI
解决了卡死和轮询,长任务的第二个问题是:AI也会摸鱼,而且会静默死锁。
稍微复杂点的工程任务,模型只要碰上隐蔽报错,往往就会擅自宣告胜利,扔下一堆烂尾工程。
你点开一看,全是半成品。
如果靠人肉去盯着一万个Agent,系统还没跑完,人已经先进ICU了。。
Third Moment 搭建了两层Agent来解决这个问题。
- 一是外层监工(Supervisor)由独立的GPT-6 Sol / 6.1 Sol 坐镇。它只站在容器外部审阅执行轨迹。发现任务未达标,当场打回;发现连续撞墙,立刻止损切断;实在搞不定,才弹窗摇人类工程师来救场。
- 二是内层工蜂(Worker)由Codex调度GPT-6.1 Sol,全封闭在隔离的Docker容器中。专职修改代码、推进实验分支,并随着进度动态压缩上下文。
这套架构把Fan-out公式里最昂贵的分母——“人类交互时间”转包给AI质检员。
落到我们日常使用,最值得借鉴的,就是留一个主会话,让它负责分工、跟进和汇总。
之前做「牛来」模型评测时,我就是这么用Codex的。
模型评测这种任务,往往需要测试整理大量的案例,中间涉及的决策逻辑非常多。
为了提升效率,我把这个任务的苦力部分外包给了AI。
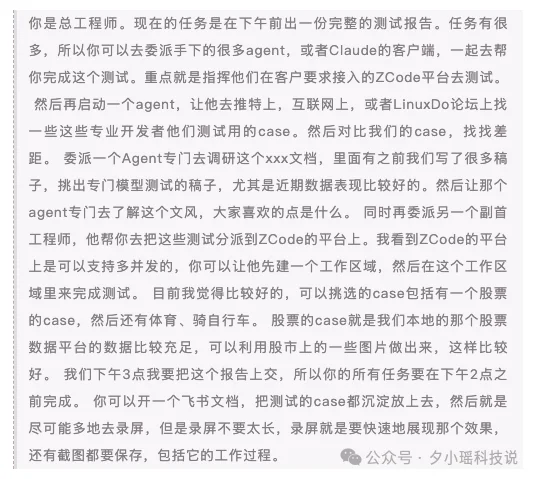
所以,我在目标模式里先给 Codex 定了个角色:
你是总工程师。现在的任务是在下午前出一份完整的测试报告。
随后再交代需要做哪些事、什么时候交、交到哪里。等等一系列的工作,让他去安排。
完整的提示词是这样的:
接到任务后,Codex先启动了三名Agent:一组研究测评稿和文风,一组提取案例与提示词,一组找社区里的开发者案例。
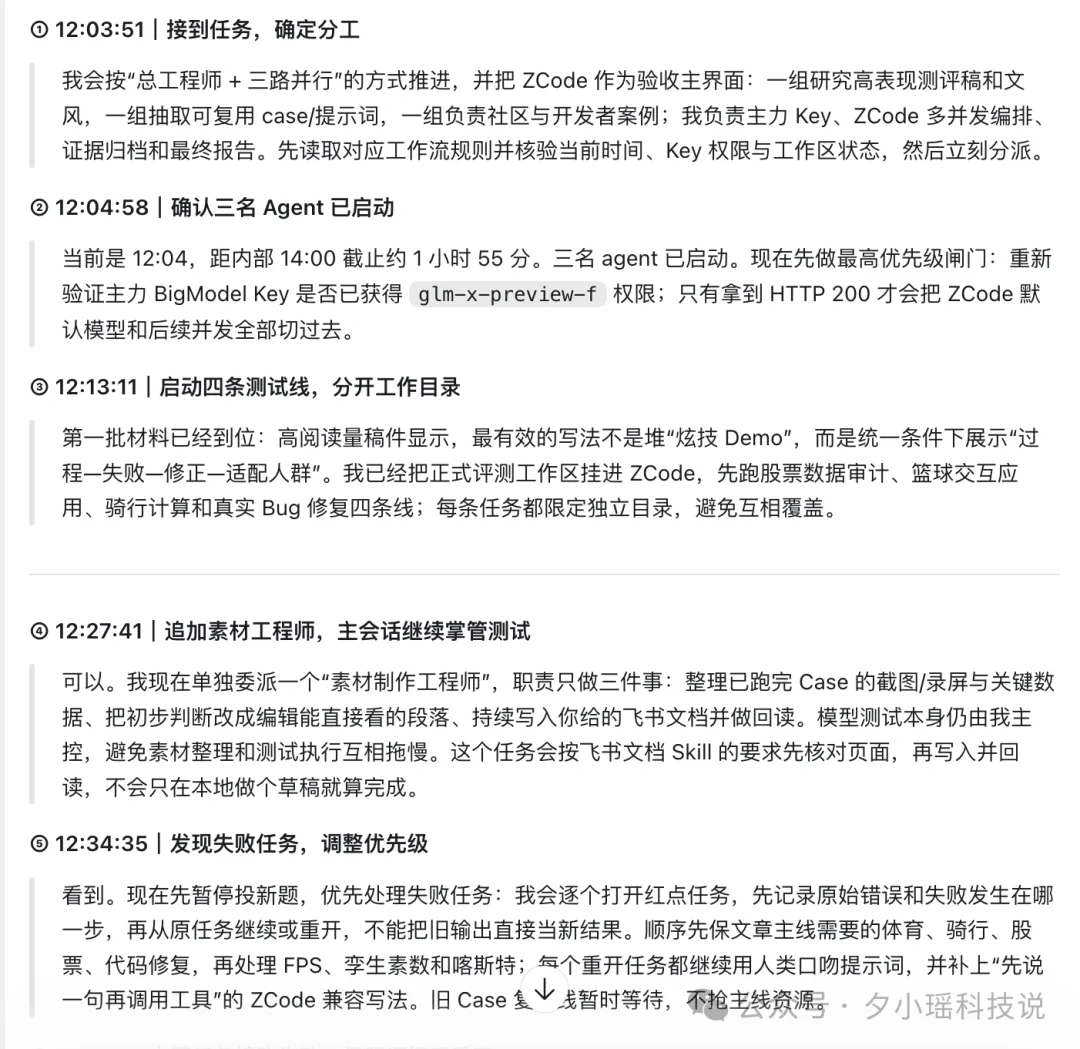
第一批材料回来后,它又安排股票、篮球、骑行和代码修复四条测试线,在ZCode里同时跑。
分工由此形成,ZCode里的几个对话负责写代码、做页面;Codex负责检查它们的进度,遇到问题再介入。
当时,我还让主Agent里设置一个定时任务,每五分钟去检查一下Zcode里的跑的任务状态。如果Zcode遇到哪些卡点,或者陷入无限循环,就让Codex即时介入处理。
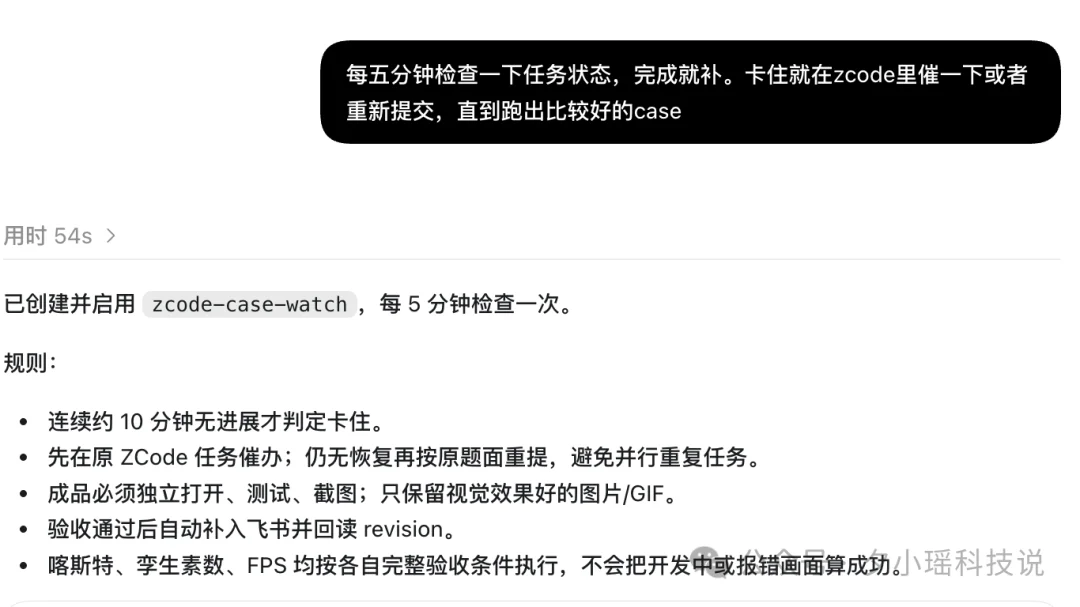
实际操作效果中,Zcode每遇到一个卡点,Codex都会在五分钟内接手任务,引导Zcode一步步往正确的方向工作。
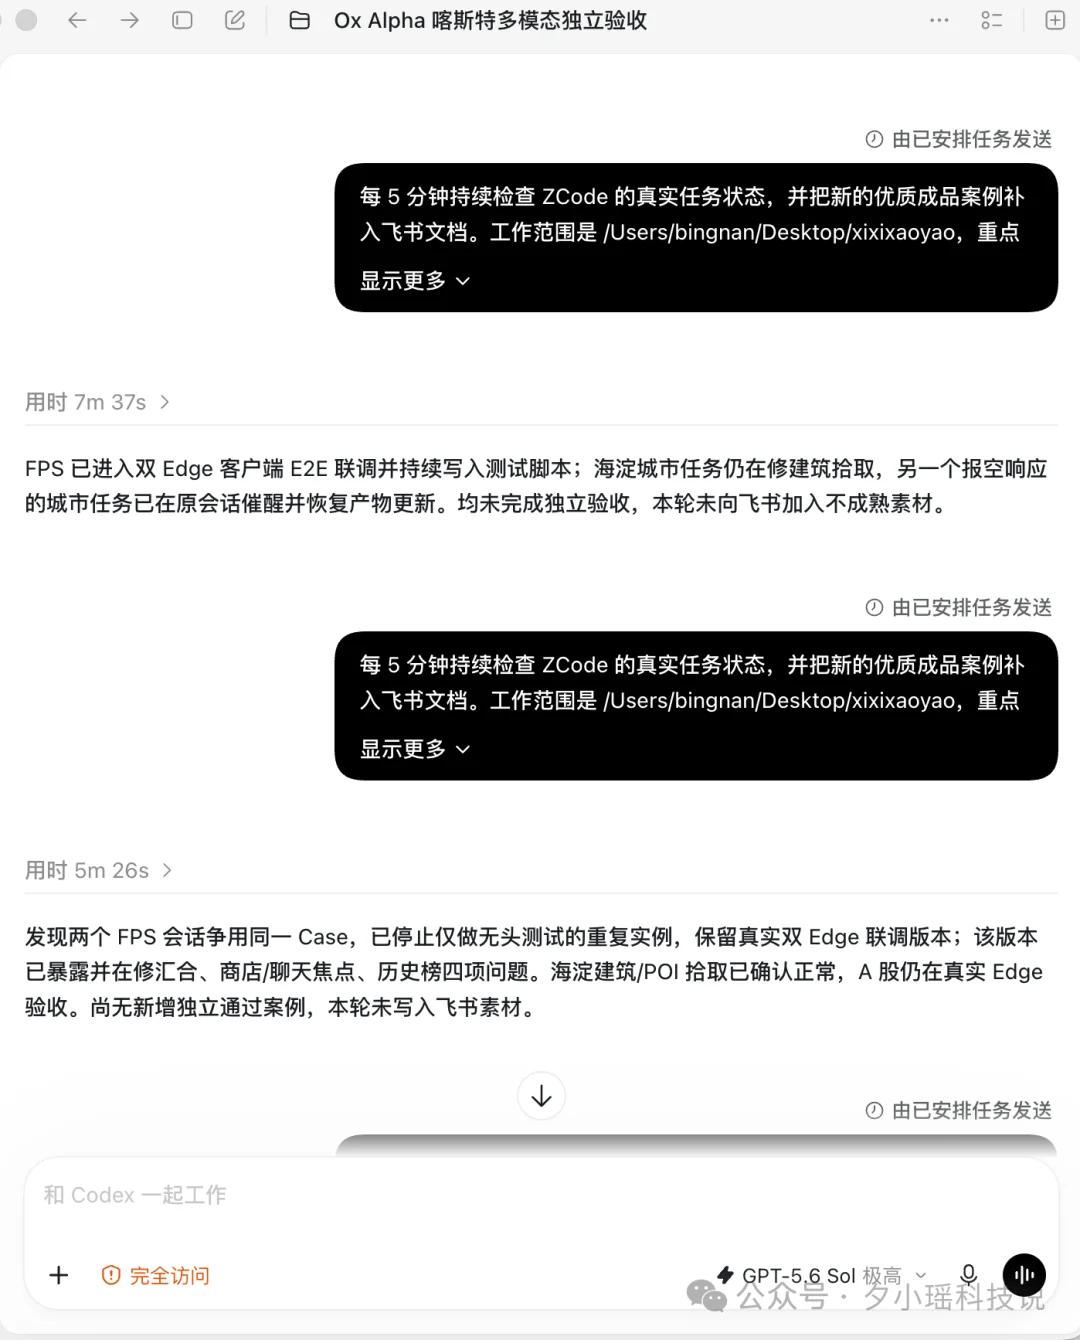
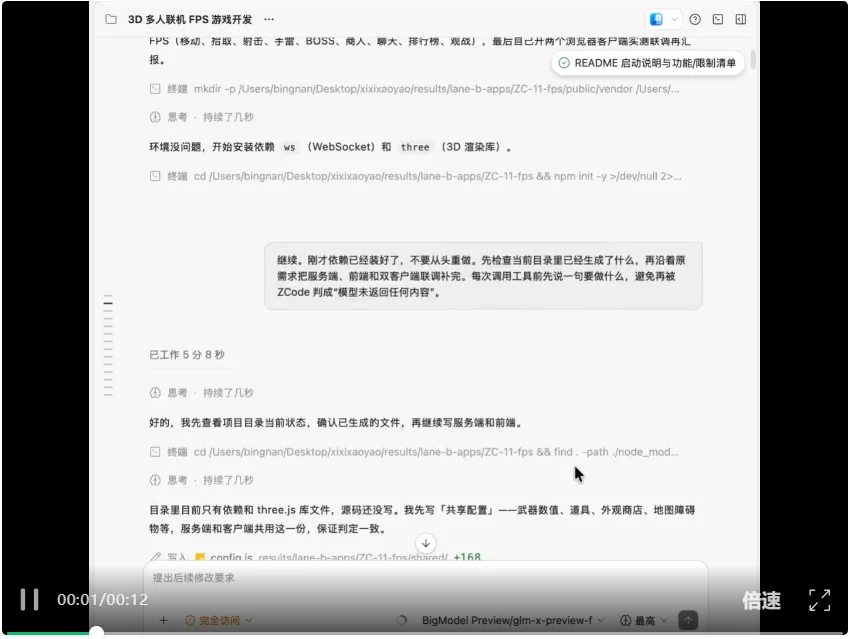
在Zcode的视角里,他的效果是这样的,就仿佛真有一个人在实时给它下达指令。
最终,在我的视角里,界面是这样的:
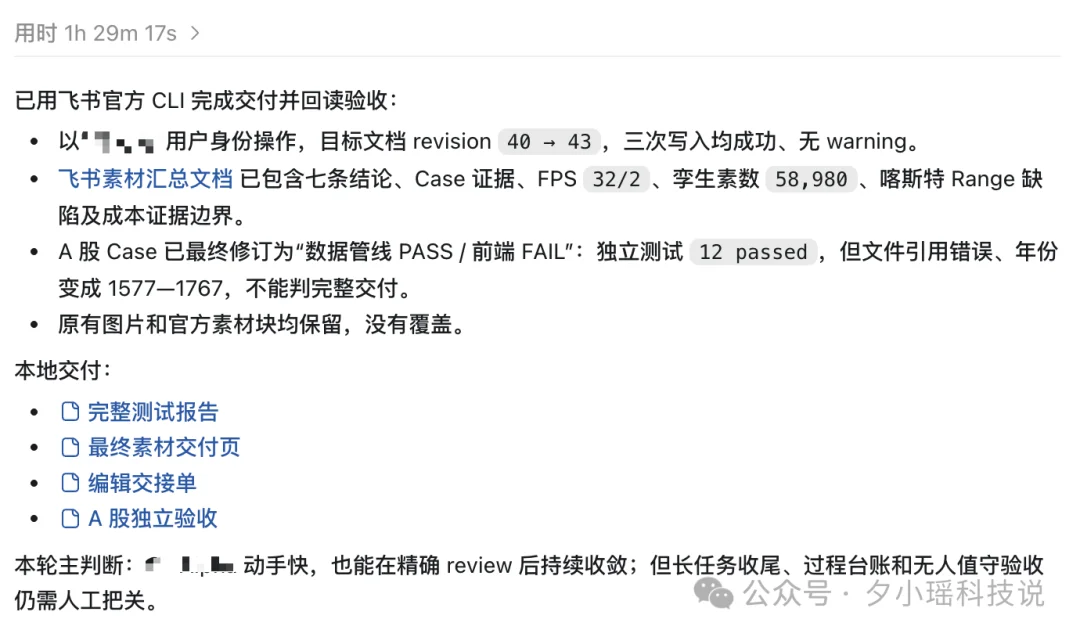
我只需要确认Codex把关过的产出,中间和Zcode逐个案例的交互时间,剩下来了。
而像这样被省下来的交互,可以是十线程的。
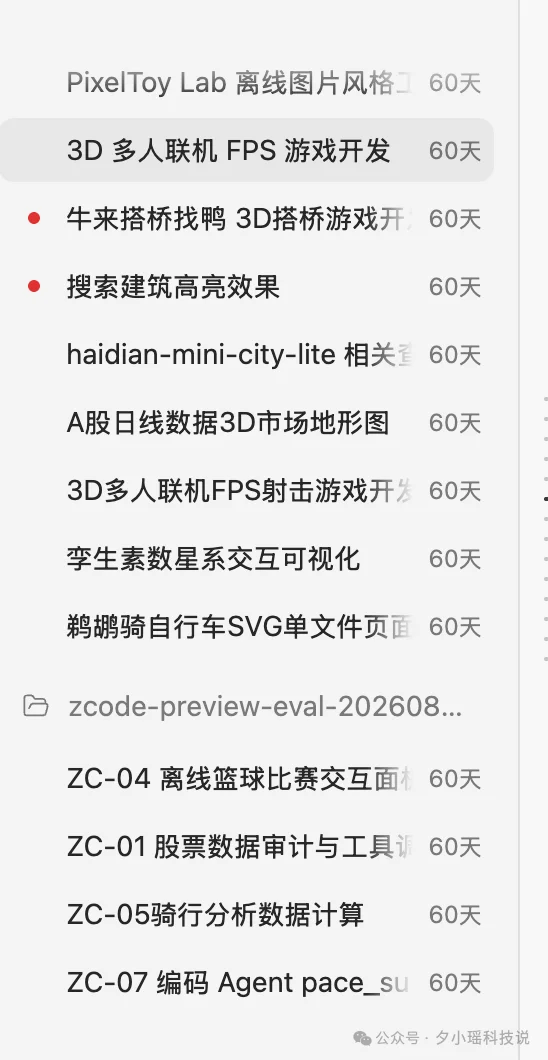
综合算下来,我和主对话Codex的一条交互,就帮我生下了至少10次和Zode的对话。
不过,在多开窗口之前,还有一条保命习惯:
把活儿拆细致,做好分工再加线程。
开五个窗口之前,得先确认你这些任务互不依赖,否则五个Agent可能会凑到一起却打起来。。
Anthropic的研究员之前做过一个实验,让16个Claude同时合作写一个C语言编译器。
到了编译Linux内核的时候,16个Agent全撞上了同一个底层Bug,大家各自修一遍,然后疯狂互相覆盖对方的代码,现场乱成一锅粥。。
连A社都会撞车,更别说我们本地的项目了。
◈三、咱们普通人怎么管好手里的Agent?
说到底,管5个Agent和管10000个Agent,规模差了2000倍,但遇到的麻烦其实差不多。
都会卡住,都会犯错,都会把一个原本简单的任务搞得一团糟。
以前我们用AI,习惯了自己盯着它干活。它写一段,我们看一段,可当Agent越来越多,这种玩法迟早会把人累死。
回头看今天聊的这套方法,其实非常好记,就三句话:
- 拉长分子,提高Agent自己干活的时间提前写好卡住后Agent的交接规矩,别让Agent原地死循环;
- 压短分母,缩短人工审核耗费的时间留个主Agent当工头,让主Agent当子Agent的第一把关人;
- 错峰防撞,给Agent做好分工。
怎么让Agent在没人盯着的时候,也能把事情继续往下推进。
这个课题,越来越重要了。
文章来自于"夕小瑶科技说",作者 "丸美小沐"。