


说好的未来几周,Anthropic只等了6天。
上周Opus 5.5发布的时候,官方顺手剧透了一嘴,Sonnet 5.5和Haiku 5.5都在后面。
刚刚,Sonnet 5.5先到了。
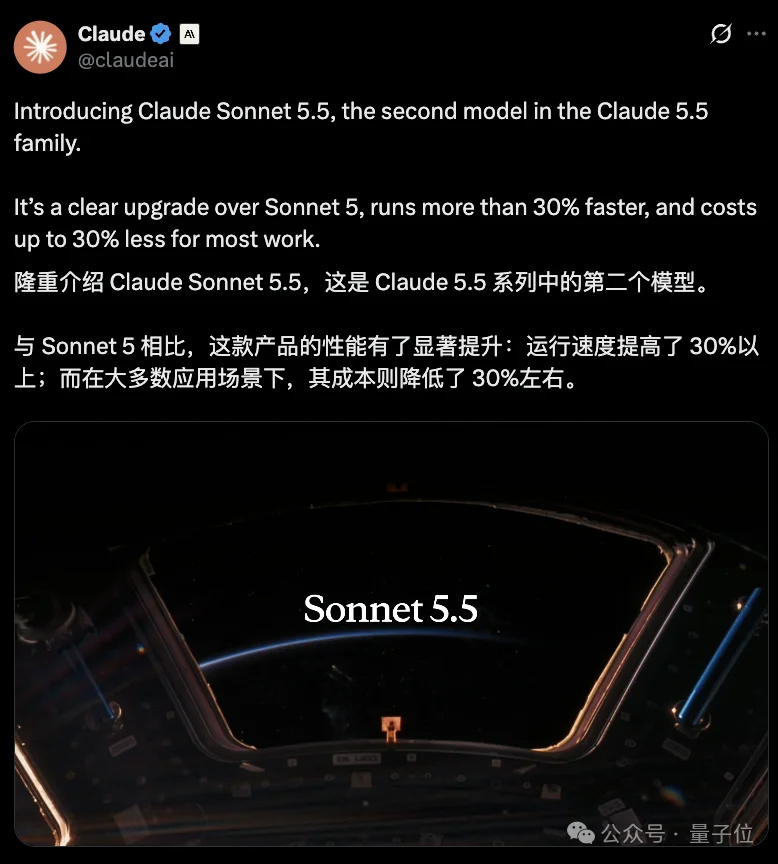
而且Claude家的“中杯”,已经撵着刚发布的旗舰追了。
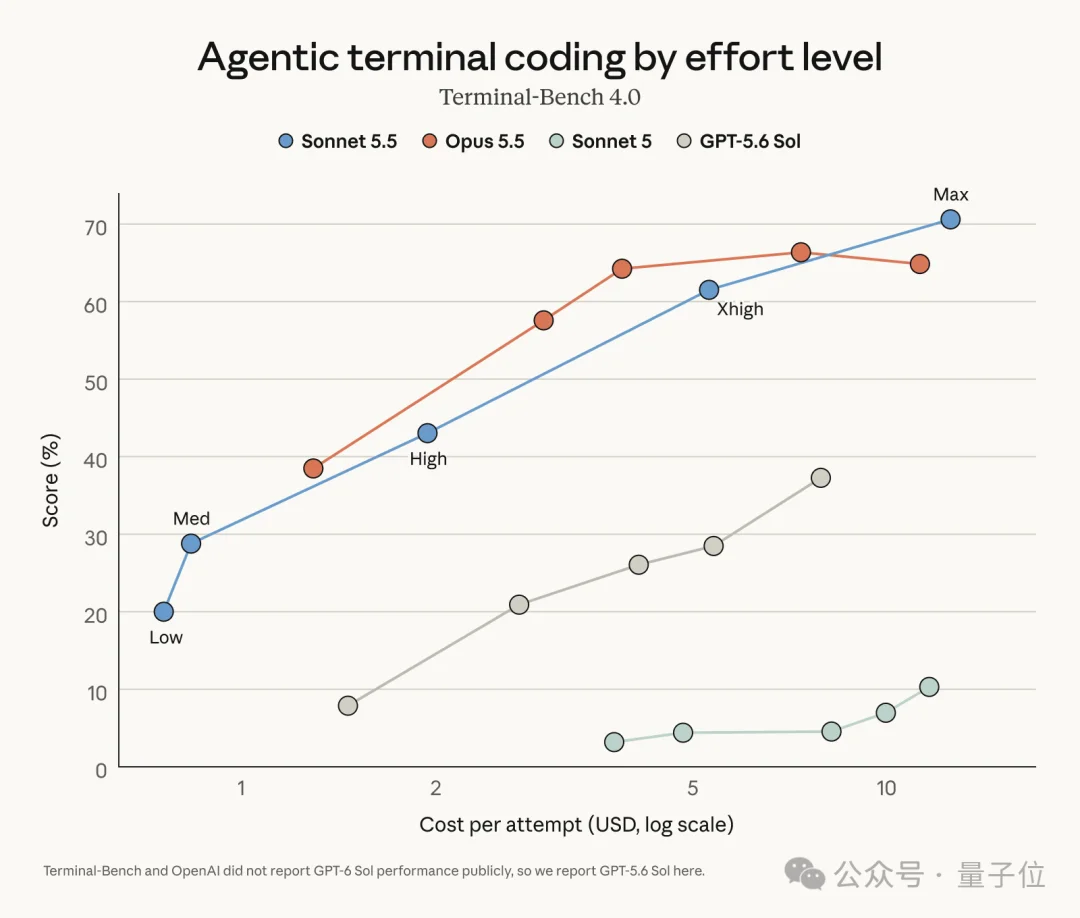
上周Opus 5.5发布时,Terminal-Bench 4.0的66.4%还是一个挺能打的成绩。
Sonnet 5.5一来直接干到了70.6%,上一代Sonnet 5只有10.3%……
在覆盖44种职业真实任务的GDPval-AA里,Opus 5.5拿到1846 Elo,Sonnet 5.5已经追到1844;
OSWorld 2.1测试计算机操作,两者分别拿到81.8%和80.1%。
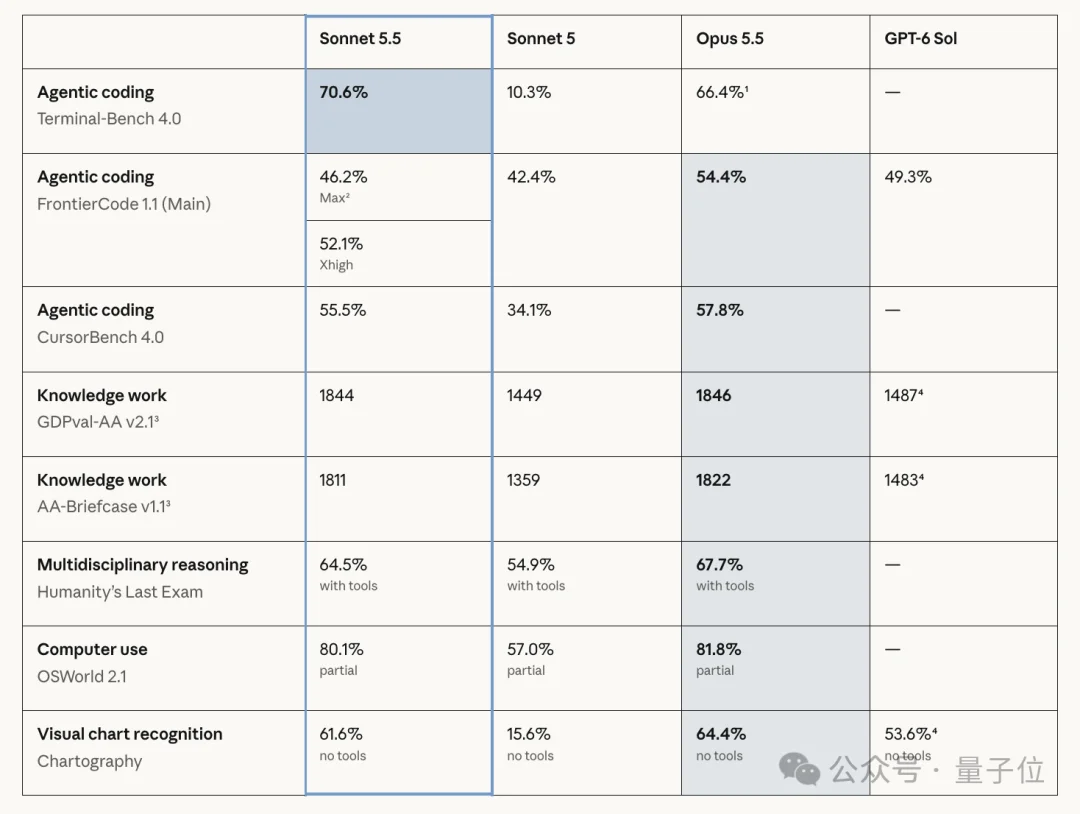
当然了,真碰上复杂、开放式、需要长时间判断的任务,Opus 5.5依然明显更强。
Sonnet 5.5更适合日常Coding、修Bug、做文档、PPT、表格这些边界比较明确的活。
价格也继续保持Sonnet档:
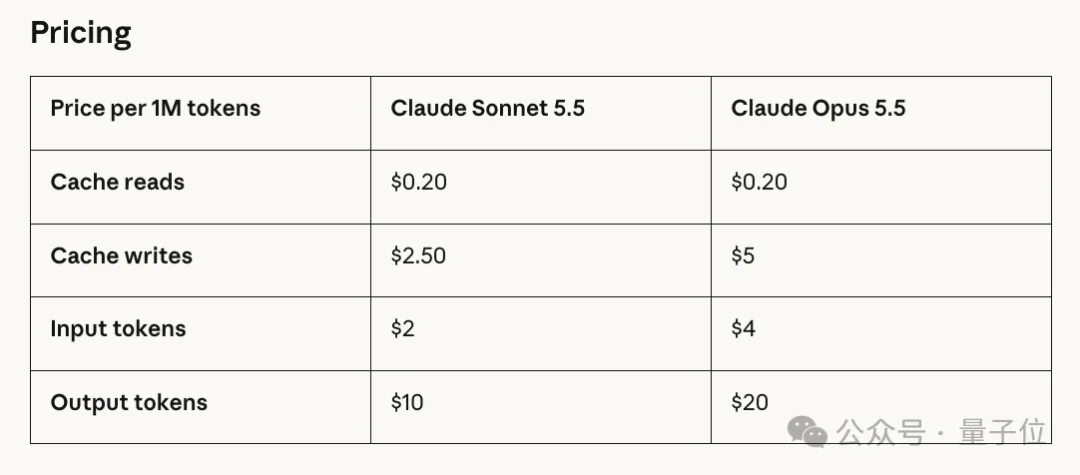
输入2美元/百万Token,输出10美元/百万Token,正好只有Opus 5.5的一半。
中杯贴着大杯跑
而且Sonnet这次不只是更会写代码,干活方式也利索了一点。
早期测试发现,新Sonnet不太爱一个工具一个工具往下磨了,能并行处理的调用会更积极地放到一起。
最后完成同样一项Coding任务,工具调用少了大约三分之一,Shell运行次数差不多直接砍半。
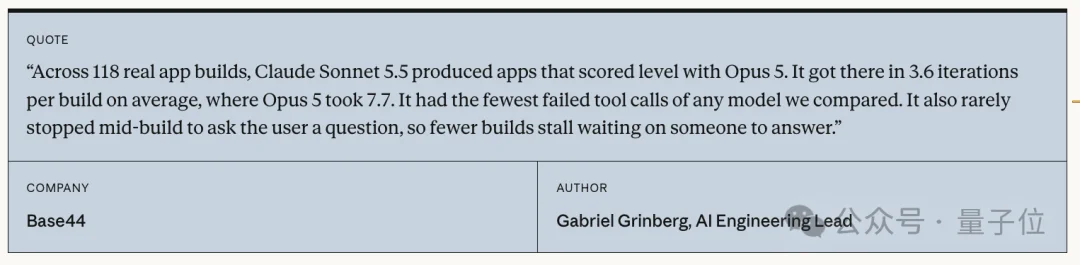
Base44干脆拿118个真实App构建任务来测。
Sonnet 5.5平均跑3.6轮就能做到和Opus 5相当的结果,后者平均需要7.7轮;
同时,新Sonnet还是这组测试里工具调用失败最少的模型。
还有人直接把它扔进大工程。
Epic Games让Sonnet 5.5去啃数万行游戏系统代码,拿它检查系统架构和数据流;
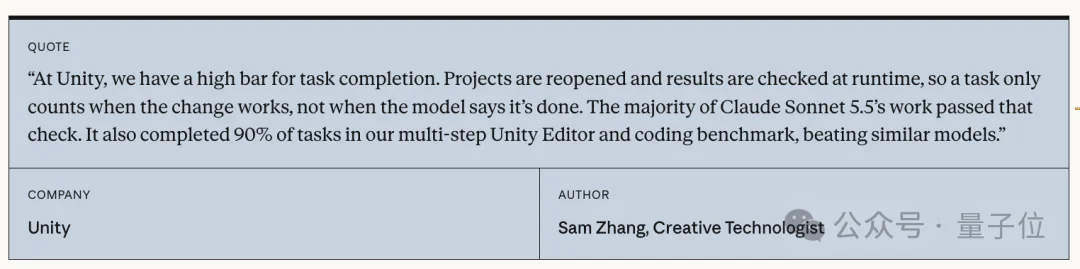
Unity的验收方式是模型改完代码之后把项目重新打开,真正跑起来才算完成。
最后Sonnet 5.5做完了他们多步骤Unity Editor和Coding测试中90%的任务。
Anthropic祖传的宝可梦也没落下。
Sonnet 5.5成了Claude家第一款只看游戏截图就成功通关《宝可梦:红》的Sonnet。
这一代Sonnet还多了点设计感,给定幻灯片模版,就能照着原来的版式和视觉规范往下做,生成的PPT只需要少量人工调整,大大减少工作量。
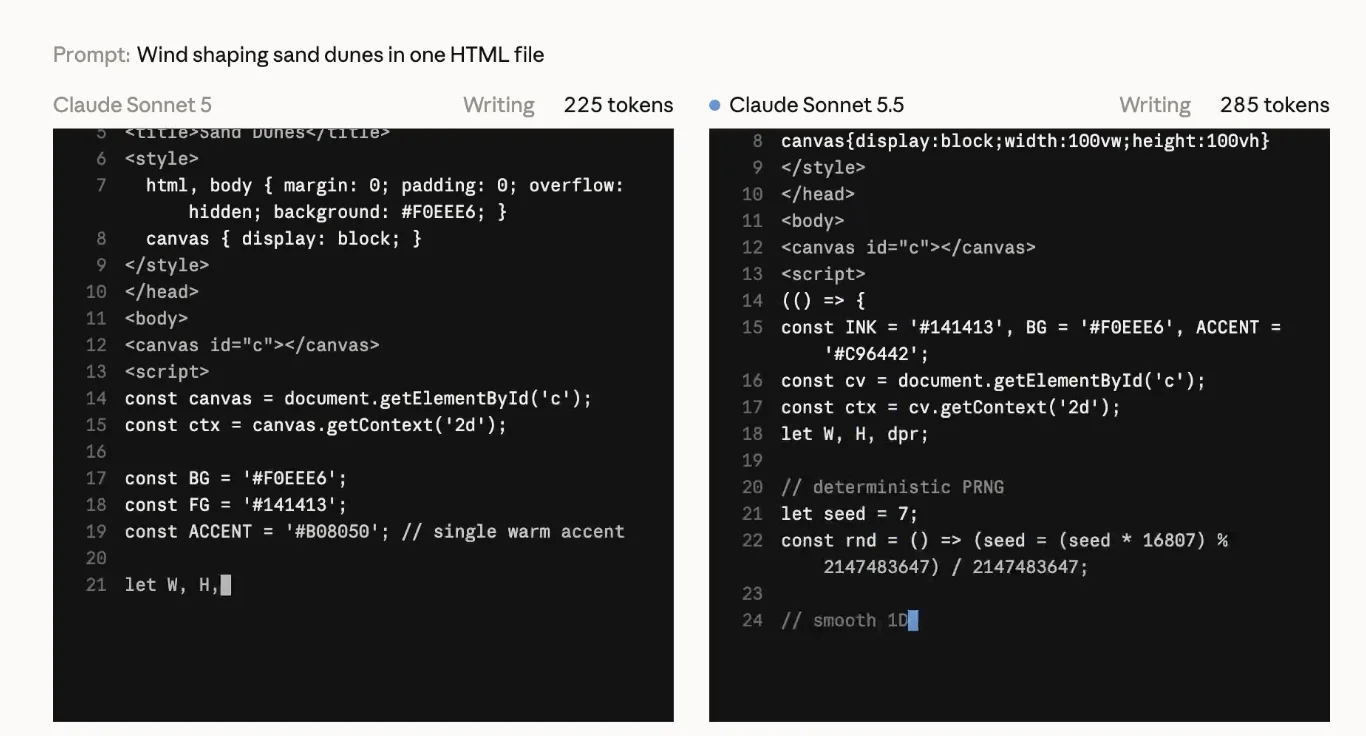
单次任务花钱更少
Sonnet 5.5这次连API单价没动。
每百万输入Token还是2美元,输出还是10美元,缓存读取也继续维持0.2美元,和Sonnet 5完全一样。
但Anthropic测下来,完成大多数任务的实际成本,最高能再降30%,速度提升30%以上。
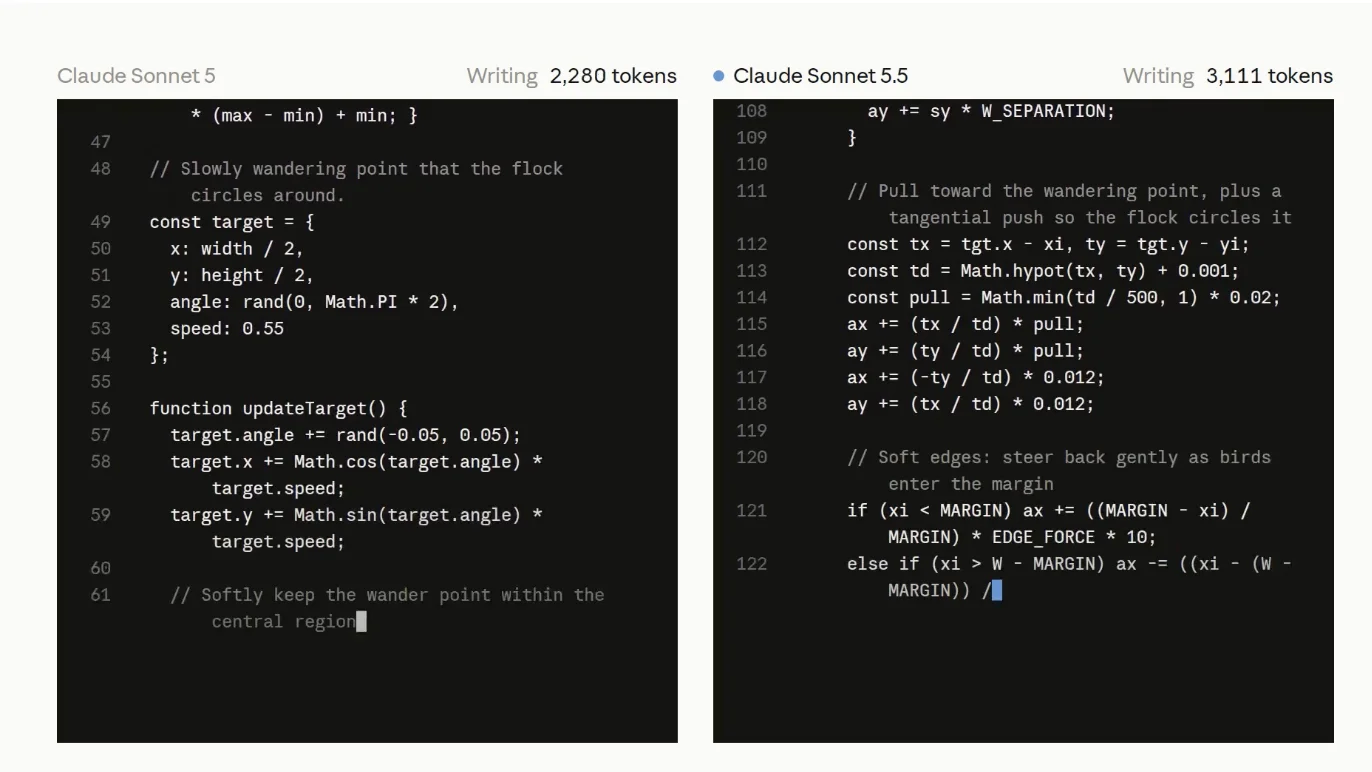
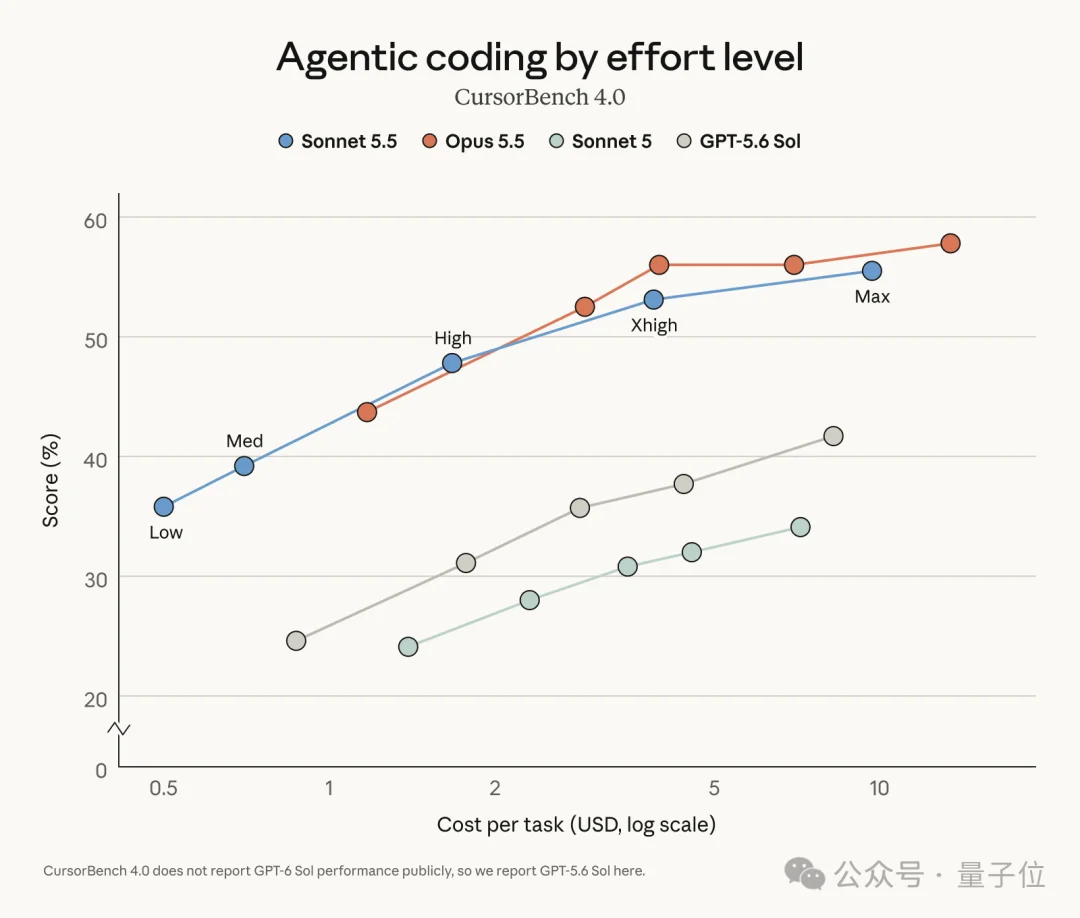
而且这次Anthropic还专门算起了另一笔账,同样的钱,模型到底能干多少活。
Terminal-Bench 4.0上,Sonnet 5.5只开到Medium effort,已经超过Sonnet 5能做到的最好成绩,单任务成本却不到后者的十分之一。
CursorBench更省,Sonnet 5.5甚至只开Low effort,就能超过Sonnet 5的最高成绩,同样只花不到十分之一的钱。
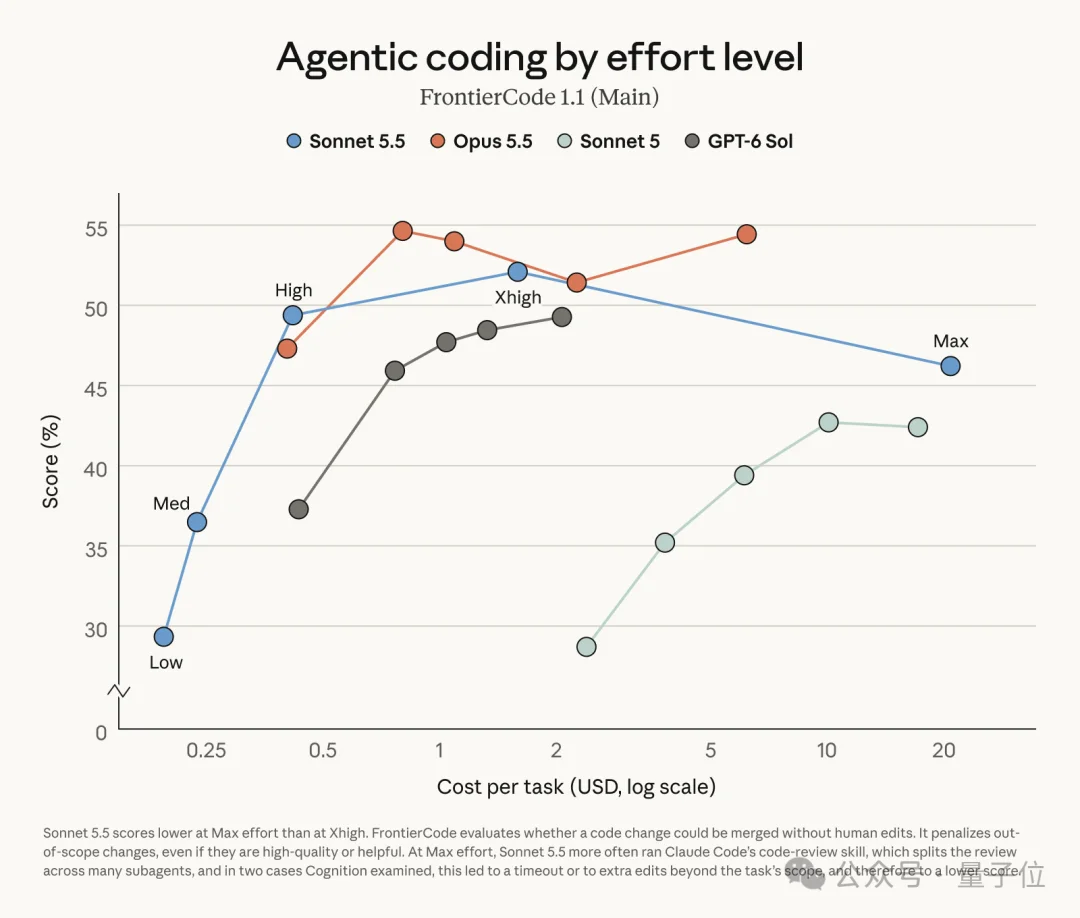
到了FrontierCode,比较对象直接换成了GPT-6 Sol。
在Claude Platform默认的High effort下,Sonnet 5.5能做到和GPT-6 Sol最佳成绩相当,而Anthropic给出的单任务成本大约只有后者的五分之一。
这两周Claude连续更新,Anthropic已经越来越喜欢把一个数字放在Benchmark旁边:
完成一项任务,到底花多少钱。
而Anthropic接下来还有一款模型,更是来卷这笔账的——
Haiku 5.5。
Anthropic给它的定位很明确,高吞吐量、成本敏感型。
参考链接:
[1]https://x.com/claudeai/status/2104633131760333046
[2]https://www.anthropic.com/claude-sonnet-5-5
文章来自于微信公众号 “量子位”,作者 “量子位”