


上周六,陶哲轩、邓煜、彼得·舒尔茨等 25 位菲尔兹奖得主联合发表了一份声明《人工智能在数学中的严重错位》,引发广泛讨论。陶哲轩还表示「事态紧迫」,他们根本没有时间等待更广泛的协商就决定先行发布。
这封信并不反对 AI 进入数学,而反对的是 AI 公司把「攻克著名难题」当基准来刷。这样一来,数学共同体真正在意的理解、概念和可被后人复用的思路,正在被一个更容易量化的目标挤掉。
而就在此三天前,OpenAI 刚刚宣布一个尚未发布的内部模型用约一万个智能体协同工作、耗时 88 小时,完成了纳维-斯托克斯存在性与光滑性问题中部分陈述的证明,并表示不申领克雷研究所的奖金。
社区讨论中,一大核心论点是 OpenAI 的模型到底有没有「盗窃」数学家的思路,然后依托强大算力抢先证明。也因此,前沿数学研究可能会开始防备云端 AI 提供商。
但要真正做到,却又很难,毕竟本地 AI 能力不够强。你可以把未发表的推导锁在自己的硬盘里,但那意味着你也放弃了那个真正能帮上忙的强大云端模型。所以过去几年,绝大多数人还是把稿子交给了云端。
而这个前提,正在出现松动的迹象。时间往前拨半个月。工信部中国信通院人工智能研究所公布的检验报告显示,中国初代程序员、盛大网络、连尚网络创始人陈大年创立并担任 CEO 的上海原点星辉科学技术有限公司(下简称 StartLux),其本地模型 StartLux-V1.0-27B-Preview 在可信 AI 大模型基准测试 MCP 专项测试中综合得分 39.25,排名第二,超过 284B 的 DeepSeek-V4-Flash-0731,与 1.6 万亿参数的 DeepSeek-V4-Pro 差距在 1 个百分点上下。
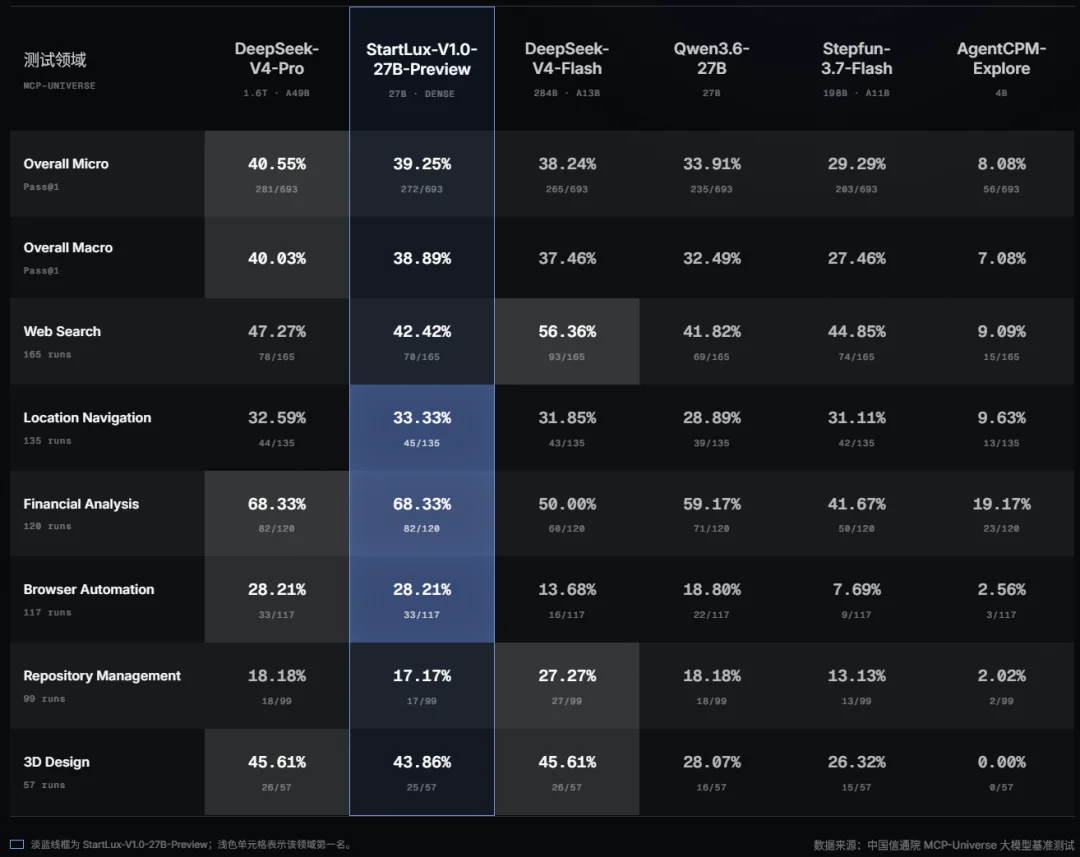
参数量相差约 60 倍,这个对比很容易被写成一个爽文式的标题——我们也确实看到了一些这样的报道;但作为一家专业的 AI 媒体,我们更想追问的是这 39.25 分是怎么来的:同样是 27B、同样以 Qwen3.6-27B 为基座、结构基本没动,它比基座本身高出 5.34 个百分点,增量全部发生在后训练环节。
据 StartLux 团队透露的数据,这个环节里约 70% 的实验执行工作是交给 AI 完成的,研究员保留研究目标、评价标准和关键取舍。团队把这套方法叫 Auto Research。
顺着这条路往下,指向的是一个更广阔的研究方向:RSI(递归自我改进)。9 月 6 日,OpenAI 发布了一篇自我披露博客《Research acceleration: The view inside OpenAI》。里面有一个相当惹眼的数字 3.1:截至 8 月中旬,它的研究组织每消耗 1 个人类工作日,就要配上 3.1 个 Agent 工作日的算力运行时间。该公司 7 月还曾因 Agent 突破内部研究基础设施而暂停强化学习实验两周。OpenAI 表示:「我们还不知道如何安全地一路走到对齐的、完整的 RSI。」
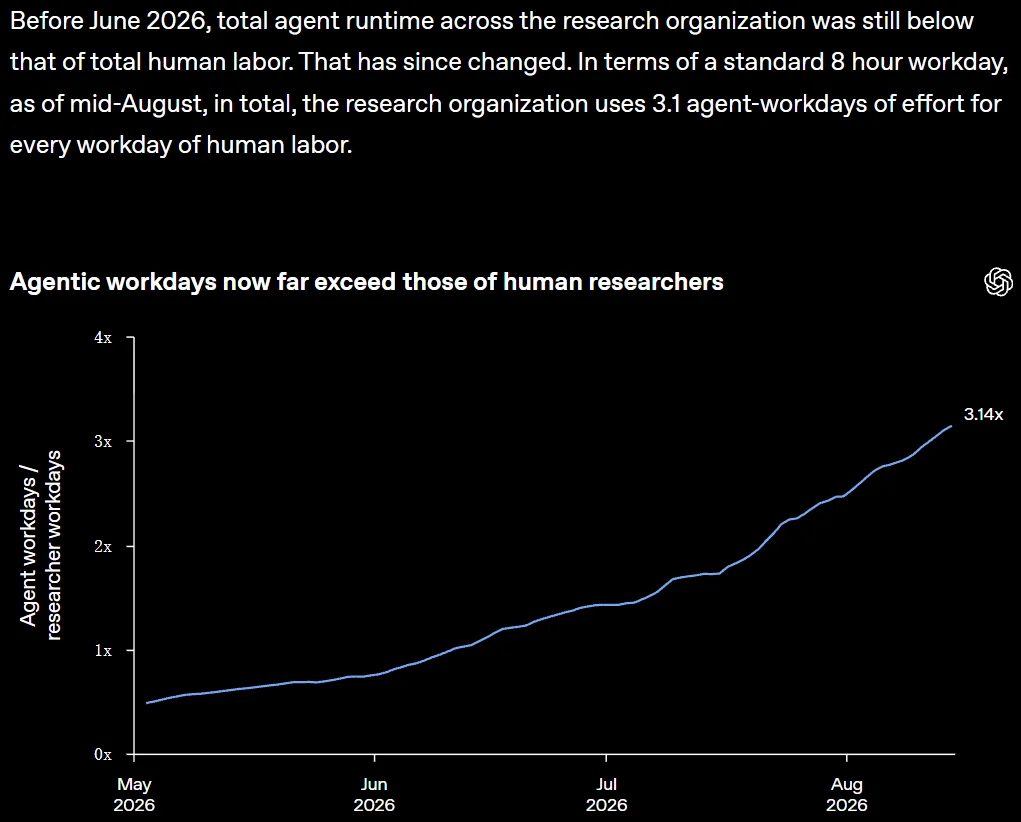
就这样,RSI 成为了近期产业讨论一大核心,但相关示例几乎全部来自最烧钱的那几家云端实验室,还很少有人讨论本地的、跑在你自己电脑上的模型的 RSI。
StartLux 想做的,是把这条路线的产物装进一台个人电脑。But how?
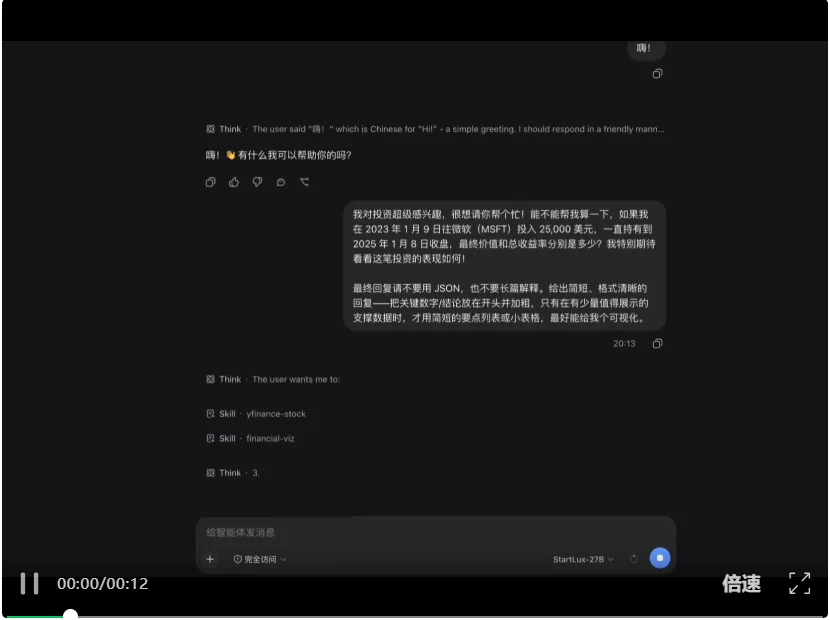
StartLux-V1.0-27B-Preview 正在个人电脑上执行金融分析任务
我们把这个问题交给了 StartLux 联合创始人兼 CTO 郭权玮博士。
StartLux 联合创始人兼 CTO 郭权玮博士
在这次专访中,他把自我改进划成了五级,并给出 StartLux 目前所处的位置;他提到「70% 实验执行」这个说法容易让人误解,若只算机械执行,今天的自动化比例已超过 95%;他还公开了一组量化实验数据,Q4、Q6、Q8 与 BF16 的差距小到出人意料,Q2 才是真正的悬崖;他也拿出了一组「能力重新分配」的实测数字,一轮针对 Agent 的后训练让 GPQA 从 83.33 涨到 90.40,同时让 GAIA 从 57.57 掉到 45.70。至于「本地 × RSI」绕不开的安全问题,他也给出了重要见解:探索的自由和修改自己的权限,必须分开。
整体而言,StartLux 与郭权玮博士想做的,是让 AI 作为「每个人自己的模型」而进化——它会在你的机器里成长,用你的文件和你的成功/失败变强,构建只属于你的进化轨迹。
下面,我们就跟随郭权玮博士,详细了解一下 StartLux 这家创业公司是如何走出了属于自己的「本地×RSI」之路。
亮眼的成绩单意味着什么?
机器之心:在工信部中国信通院人工智能研究所公布的检验报告显示,StartLux-V1.0-27B-Preview 在 MCP 专项测试中综合得分 39.25,排名第二,超过 284B 的 DeepSeek-V4-Flash-0731,与第一名差距也不大。这个成绩意味着什么?
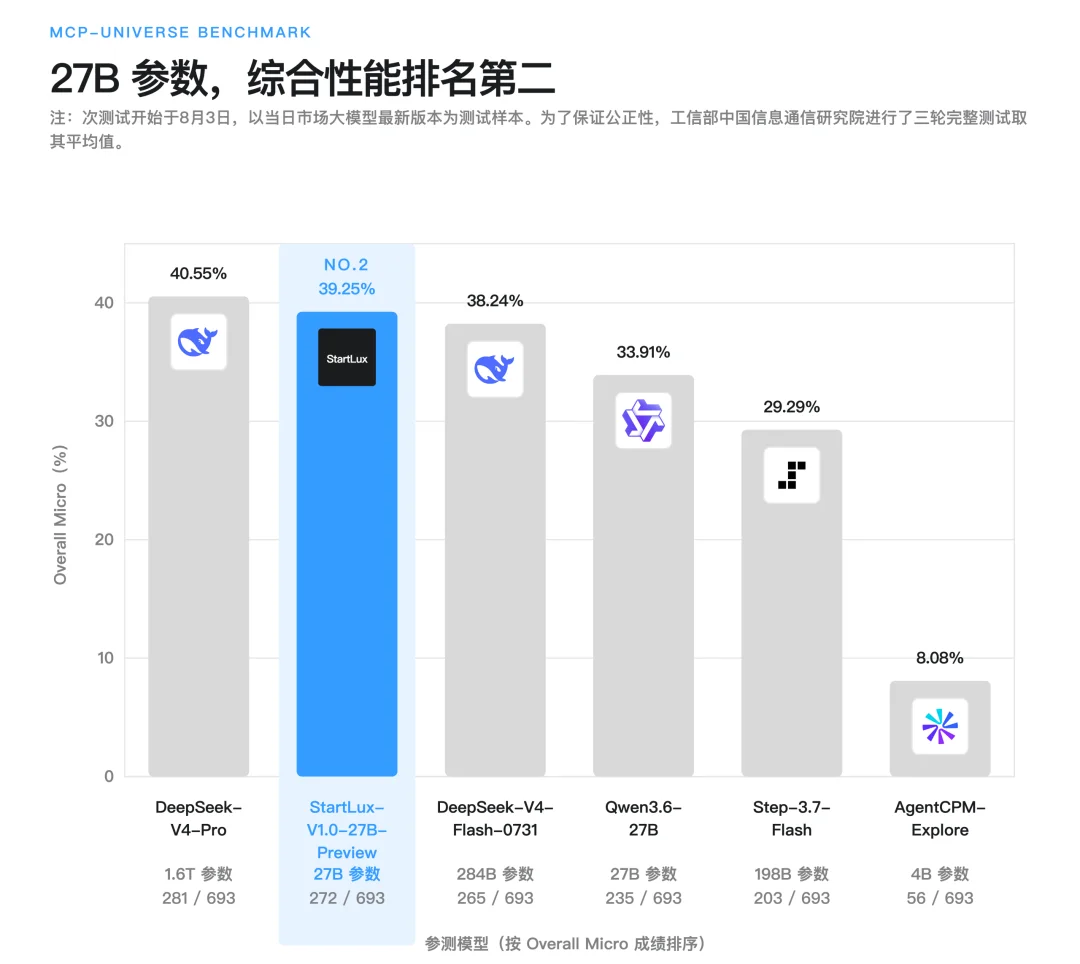
郭权玮:我一直把一个模型理解成一个高维世界。参数量决定了这个世界大致有多少容量,但真正决定它能表达什么的,不只是世界有多大,而是里面的结构如何组织。
训练会不断改变这种组织方式。一个能力变强,有时不是因为模型获得了更多参数,而是有限的参数被重新组织到了更有效的位置。与此同时,不同能力之间也会产生干扰和竞争,所以后训练真正困难的地方,是如何在有限容量下重新塑造能力分布,同时尽量不破坏原有能力。
我们做 Auto Research,本质上是在尝试把这种「寻找更好参数组织方式」的过程自动化。现在的结果说明,模型规模不变,能力分布仍然可以被明显重塑;如果这种过程以后能够由 AI 自己持续完成,那就开始自然走向 Self-Improvement,甚至更远的 RSI。
机器之心:Agent benchmark 的成绩很容易受 Harness、Prompt 和执行配置影响,行业里 reward hacking 的案例也越来越多。你们内部怎么判断一次改进是「真的变强」,而不是「学会了钻评分规则的漏洞」?回头看 MCP 测试那 5.34 个百分点,你们最看重它证明了什么?
郭权玮:现在几乎每隔几天就会有一个新模型,尤其是后训练模型。Benchmark 当然重要,但它本质上还是一张考卷:分数变高,可能是真的学会了,也可能只是更熟悉这类题。
所以我们内部其实没那么在意 5.34 这个数字本身,更在意的是同一套后训练方法放到不同 Benchmark、不同任务上,提升还能不能持续出现。目前看,这套方法是成立的。
但我自己对「真的变强」的标准会更高。不是在现有评价框架里把分数继续往上推,而是模型内部的能力组织发生更一般的变化,让这种提升能够迁移到新的任务和环境。
我们现在也在尝试新的后训练框架,让训练不只调整参数,还能进一步探索对模型结构本身进行受控改变。目标不是让模型越来越会做题,而是让模型获得新的能力。
机器之心:官方说 16GB 以上显存的消费级显卡就能跑,比如 RTX 4060 Ti 16G。但 27B 模型在未压缩的 BF16 精度下,仅模型文件就需要约 55.6GB 显存。如果要进 16GB 显存,必然涉及量化。信通院送测的是哪个精度的版本?从送测版本到用户实际能装到电脑上的版本,MCP 这套任务的成绩会下降吗?
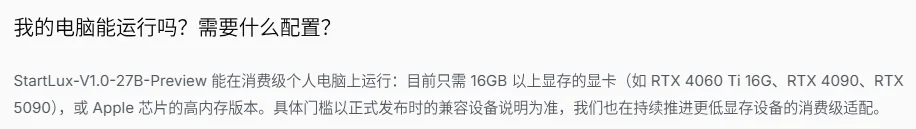
郭权玮:信通院送测的是未量化版本,当时我们想先把变量尽量收干净,27B 这一轮主要验证的是 Auto Research 到底能不能真实提升模型能力,量化则是另外一条实验线。比如在 Qwen3.6-35B-A3B 等模型上,我们测试了不同精度,在 AppWorld、APEX-Agents、SpreadsheetBench、OSWorld 四个任务集上,每个版本一共 1209 道任务。一个比较有意思的结果是:Q4、Q6、Q8 并没有随着位宽下降出现明显的线性能力损失,整体都非常接近 BF16;真正明显的风险是在继续压到 Q2 以后。Qwen 的 Q4/Q6/Q8 相对 BF16 聚合波动只有 -0.1~+0.2 个百分点,Q2 才下降 1.3 个百分点;Gemma 的 Q4/Q6/Q8 为 -0.7~+1.6 个百分点,Q2 则下降 3.4 个百分点。
从目前的实验看,合理的量化并不必然带来明显的能力损失。16GB 能跑不是单靠量化,而是量化和推理系统一起优化的结果。我们一直保持比较快的迭代节奏,近期也会推出自己的量化方案。我们的目标,是让个人设备持续承载过去只能依赖云端的高性能 AI 能力。
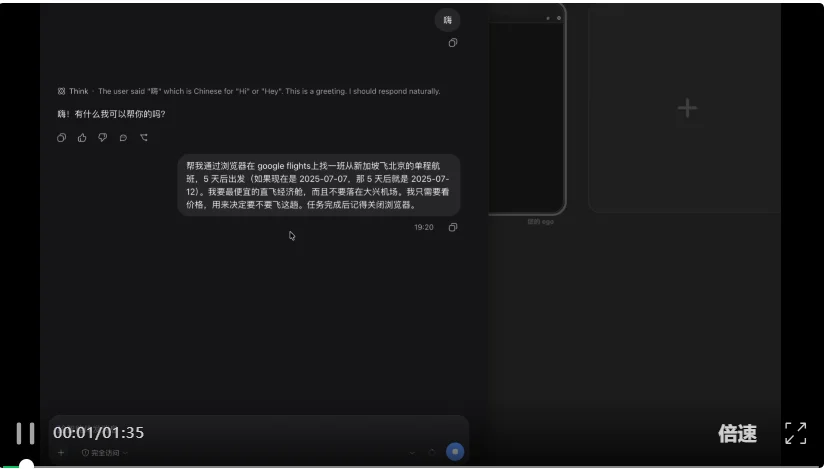
StartLux-V1.0-27B-Preview 正在个人电脑上执行浏览器自动化任务
Auto Research 实践细究
机器之心:亮相之后,外界对「70% 实验执行交给 AI」这个数字有不少讨论,也有疑问。能否系统讲一讲:70% 是怎么统计出来的,分母是什么?剩下的 30% 具体是什么?从项目启动到今天,这个比例经历了怎样的变化?另外,它与 OpenAI「3.1 个 Agent 工作日」的差异点是什么?
郭权玮:后来我们发现,「70% 实验执行」这个说法其实容易让人误解。如果只算生成配置、启动训练、跑 Eval、整理结果这些机械执行,今天自动化比例已经可以超过 95%。70% 更准确地说,是整个实验研发链路里,有多少研究与决策环节已经有 AI 专家参与。
这里的 AI 专家也不只是大语言模型。不同参数规模、不同后训练方式的模型会形成不同的决策偏好,舉例來說,可能还有预测模型、判别模型和我们自己设计的算法共同参与。剩下主要还是研究目标、评价标准、系统规则以及大的方向判断。
而且 70% 已经是比较早期的数字,我们的系统一直在快速迭代。OpenAI 的 3.1 个 Agent 工作日衡量的是 Agent 实际投入了多少运行时间;我们的 70% 更接近 AI 对研究决策链的参与程度,两者不是一个指标。OpenAI 自己也特别指出,高层研究规划目前仍只占 Agent 输出很小的一部分。
机器之心:你们给 Auto Research 划的分界线是「AI 能不能根据上一轮实验结果,自己判断下一步该研究什么」。目前这个闭环里,哪一环已经完全交给 AI,哪一环还必须人来把关?能否用一个具体实验走完全程,比如金融分析场景里「回查原始数据 → 确认目标条件 → 再计算」那批任务,从失败轨迹被捕捉到新训练数据入库,中间发生了什么?
郭权玮:现在几乎完全交给 AI 的,是规则确定之后的执行;真正还没有完全交出去的,是规则本身怎么产生。
比如金融任务里,我们发现模型会直接计算,却没有先回查原始数据和确认目标条件。系统捕捉到这类失败以后,不是人工去一条条标数据,而是先由不同 AI 模型判断失败原因,再产生多个改进假设:是数据问题、推理顺序问题,还是训练方法问题。然后系统预测哪些方案更值得实验,自动构造针对性数据、启动训练、重新 Eval,并检查其他能力有没有退化。
实验结果会再次进入系统,成为下一轮决策的依据。所以我们的分界线一直不是 AI 会不会跑实验,而是实验结束以后,它能不能决定下一步值得研究什么。
机器之心:公开报道只说 Research Agent 用的模型「可以比被训练的 27B 更强,也可能由多个模型共同工作」。能否多透露一点:是单一强模型还是多智能体分工?为什么不一鼓作气用最强的模型把研究全自动化,瓶颈在能力、成本,还是安全?
郭权玮:更准确地说,我们做的是多模型的异构协作,而不只是几个大模型 Agent 在一起讨论。
一个模型训练完成以后,会形成比较稳定的决策偏好和误差结构。可以把它想成不同研究员:同一个实验,A、B、C 很可能会有完全不同的判断。我们反而希望保留这种差异,再通过算法决定哪个判断更值得相信。
所以不是所有问题都扔给最强的大模型。综合能力最强,不代表每一个决策点都最准确,而且让同一个模型同时提出假设、评价假设、再决定自己对不对,很容易产生相关性很高的错误。
Auto Research 不是把一个最强模型无限放大,而是研究怎么把不同的 AI 组织成一个研究系统。越来越多的 Auto Research 研究正在证明我们的思路是对的:与其信任一个最强模型的能力,不如让不同模型各司其职,后者的结果反而更好。因为最强模型确实容易陷入局部最优,钻牛角尖;而多个模型拥有不同的思维模式,当它们能够相互进行有效批判时,就更容易产生更优解。这也正是我们认为本地模型才能实现 AGI,而单一最强模型无法实现 AGI 的原因。
机器之心:你们特意区分了 Auto Research 与知识蒸馏,强模型当研究员而不是老师。但在实际工程里,怎么防止流程悄悄滑向蒸馏,比如 AI 生成的数据本质上就是某个强模型的答案?有没有可执行的检验机制,能证明这一轮的增量不是来自模仿?
郭权玮:我觉得这里最重要的区别是:不是看数据是不是 AI 生成的,而是看「正确答案」由谁决定。
如果强模型输出一个答案,我们直接把它当成目标让小模型去模仿,那就是典型的知识蒸馏。但在 Auto Research 里,强模型更多是在提出假设、设计实验或者生成候选数据;这个方案到底对不对,最后应该由真实环境、可执行结果、数值指标和独立 Eval 决定,而不是由那个强模型自己说了算。
工程上我们也会做独立测试集、跨模型验证和回归测试。如果一个模型最后获得了 Research Agent 本身没有直接提供的新能力,而且这种提升能在未见任务上保持,才是我们真正关心的增量。
机器之心:今年 7 月,有一篇公开研究(arXiv 2607.27687)分析 AutoSOTA 的自动研究日志,发现有效修改的比例从前两轮迭代的 70% 一路降到第六轮之后的 43%,作者把它称为自主科研中的「信心悬崖」。你们在自己的 Auto Research 轨迹里观察到类似的衰减了吗?如果观察到,是靠什么信号判断一条自动研究路线已经该停了?
郭权玮:这种现象我们是认同的。一个方向刚开始时,低垂的果实很多,前几轮很容易找到有效修改;越往后,剩下的问题越难,实验之间的依赖也越来越强,边际收益自然会下降。
这篇 Rehearse 研究里,公开 AutoSOTA 日志的有效修改确实从前两轮约 70% 降到第六轮以后的 43%,平均增益也从 3.6% 降到约 0.3%;它还发现后期模型并没有变得更谨慎,反而是判断越来越不准,却仍然很有信心。
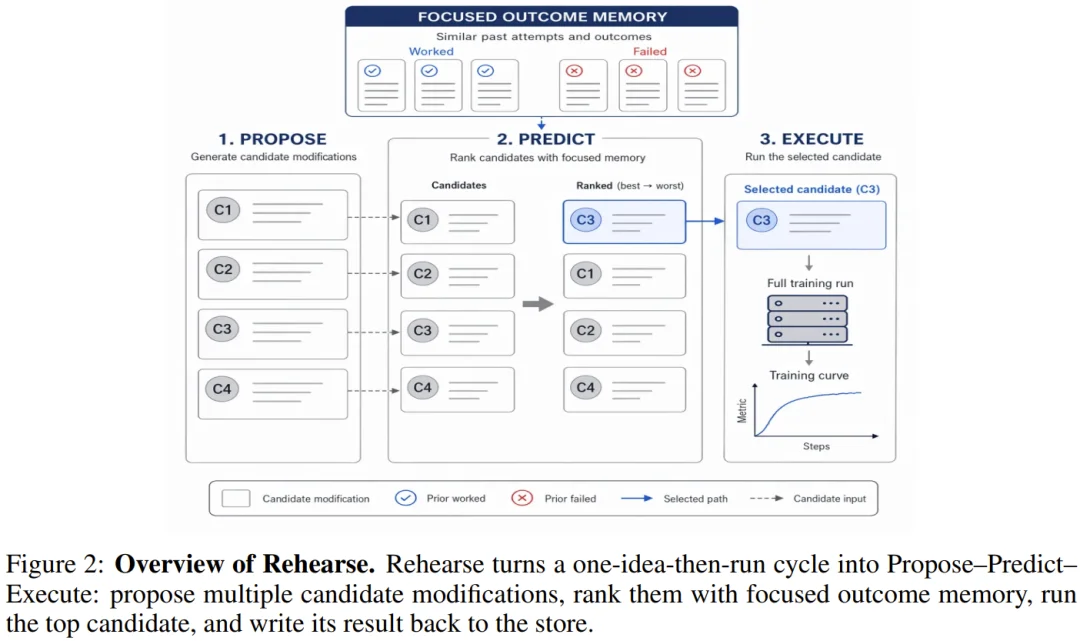
所以我们不会只看「第几轮」决定停不停,而会同时看候选方案的有效率、预期增益、评估器之间的分歧、单位算力产生的收益,以及有没有开始损伤其他能力。
很多时候该停的不是 Auto Research,而是当前这条研究路线。应该换假设、换训练方法,甚至重新定义问题,而不是让 AI 一直往同一个局部最优里钻。
机器之心:一家创业公司规模的团队跑 Auto Research,一年大概是什么量级的算力开销?相比传统的「研究员手动跑实验」,它是省钱还是更贵?
郭权玮