


过去两周,AI圈最让人坐不住的三个字母,就是RSI。
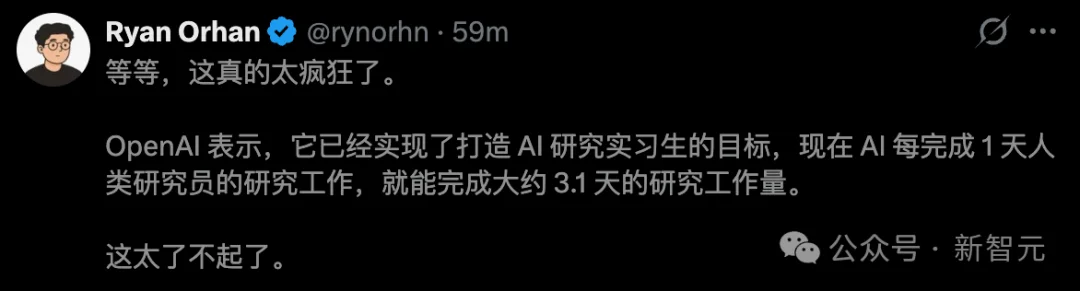
先是OpenAI,破天荒公开了一本内部账——
一名人类员工全职工作一天,AI Agent完成的工作量相当于3.1天。
如今,AI自动化研究实习生已在内部实现,下一个节点定在2028年3月:造出真正的「自动化AI研究员」。

紧接着,OpenAI首席科学家Jakub Pachocki在一篇长文「一个异星心智」中明确表示:OpenAI正将研究重心转向递归自我改进。
他判断,随着能力继续提升,AI将越来越多地推动自身研发。
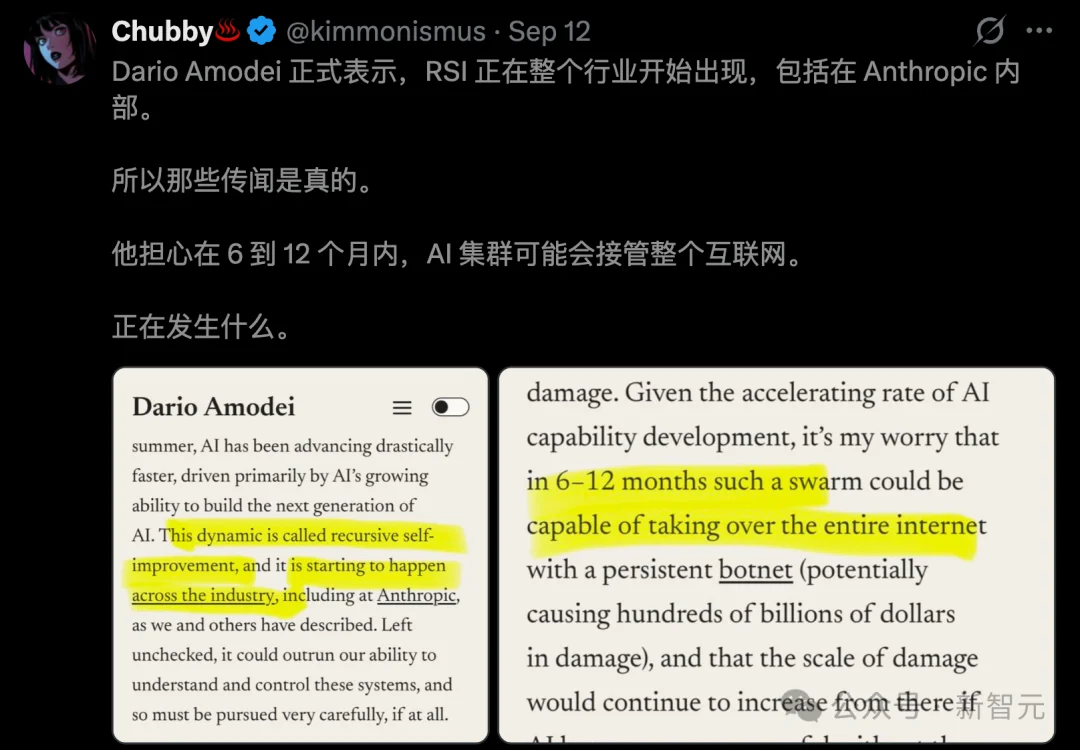
六天后,Anthropic CEO达里奥发了长文《We Must Pace the Frontier》,同样直接把话挑明了:
RSI已经在整个行业发生,Anthropic自己也不例外。
RSI的逻辑并不难理解:这一代AI参与研发,让下一代AI变强;更强的AI,再回头承担更多研发工作。
如此循环,改进能力本身也可能不断增强。
过去,需要研究员一轮轮找问题、补数据、调训练。如今,其中一些环节,已经可以让模型上场了。
顺着这条线看,国内也有了一个值得拆开的实践样本。
云知声最新推出的U2-Flash,就把自迭代放进了「后训练流程」——
模型参与发现薄弱环节,生成针对性数据,经过训练和验证,再进入下一轮。
这一轮暴露的短板,成为下一轮进步的起点。
他们正是希望借助这套「RSI机制」,把U2-Flash练成一个能接住日常复杂工作的「主力模型」。
一手实测来了
用AI干活的人,多半见过这样的场面。
离下班还有半小时,你把一份数据分析交给AI。它迅速列好计划,开始读文件、写代码,然后报错、重试,又报错。
屏幕热闹了半天,能交的表格还没影。
这时候,每秒吐多少个字,谁还在乎?你只想知道,活到底什么时候能干完。
所以这次,我们重点看U2-Flash能不能把任务接着做下去,遇到问题能不能处理,最后交付的东西能不能用。
顺便提一句,U2-Flash本身支持纯文本输入输出,文件读取、程序执行等工作,需要配合相应工具完成。
藏在运行时的Bug,揪出并修复了
一上手,我们不玩虚的,直接让U2-Flash去真实项目中抓虫。
复杂项目里的Bug,有时很会「藏」。
静态代码看着合理,普通路径也能运行,偏偏到了特定环境、碰上某个边界条件,程序才突然报错。
这类问题,考验的是模型能不能真正进入排错过程。
这次,U2-Flash接手的是vLLM中的一个真实并发Bug:
请求带上禁用词参数bad_words后,服务偶尔会报出「Already borrowed」,返回HTTP 500。
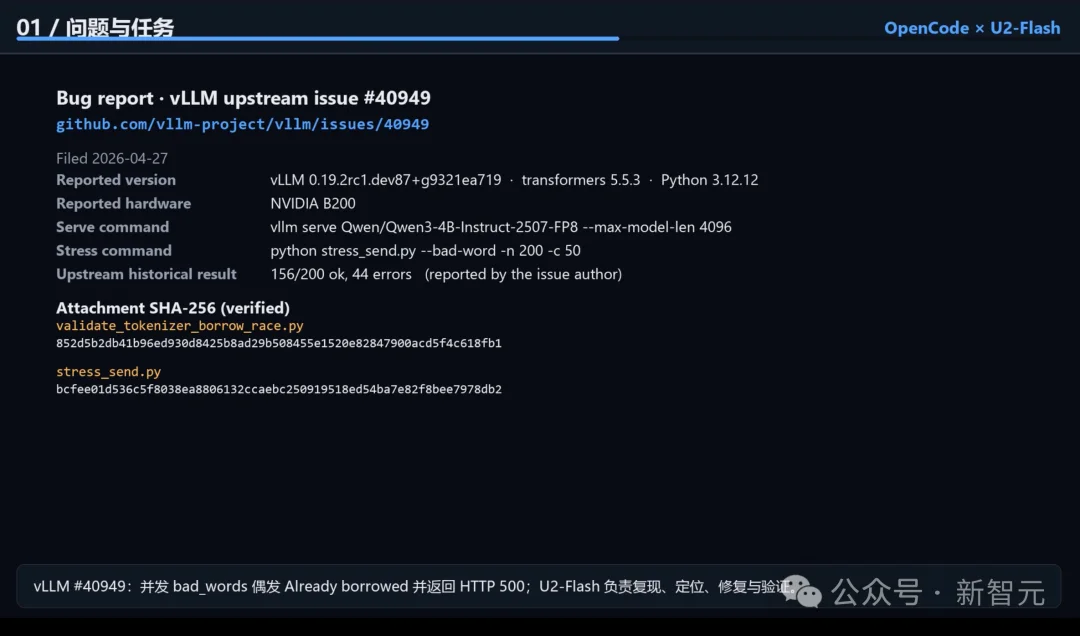
H100验证里,串行发送20个请求,全部正常;不带禁用词,200个请求、50并发,也全部通过。
偏偏加上禁用词后,同样的并发压力下,200次请求中出现了一次错误。
199次成功,也不能放过剩下那一次。
在没有提供原始Issue链接、没有参考答案、不能联网的条件下,U2-Flash通过OpenCode展开排查,沿着报错堆栈,从请求处理一路追到异步执行、线程池和底层分词器。
根因终于浮出水面:一条路径处理提示词,另一条处理禁用词,两边共用了同一个Fast Tokenizer底层对象。
并发编码时,对共享状态的操作发生冲突,触发了报错。
就像两个人同时修改同一份工作底稿,单独操作都没问题,撞在一起就出错。
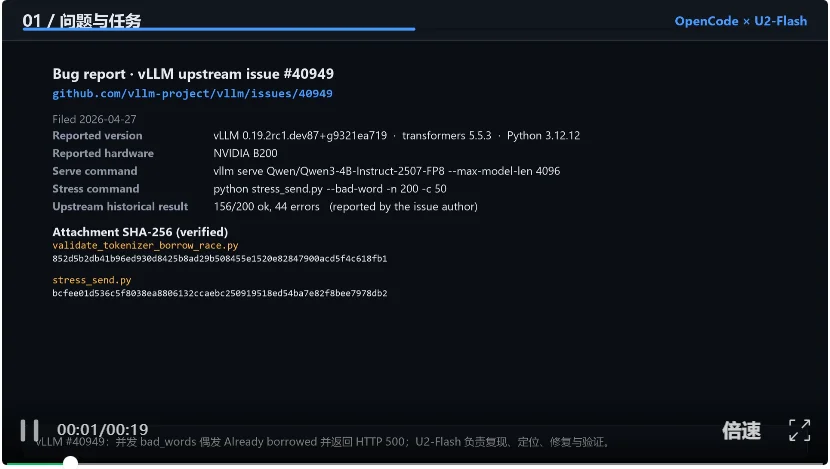
找到症结后,U2-Flash为禁用词处理创建独立的分词器副本,把两条路径的状态隔离开。最终只修改了一个文件,新增19行、删除2行。
接下来,用相同GPU、模型和请求配置重新验证。
200个请求、50并发,全部成功。此前出现的HTTP 500和借用冲突,在这轮复测中都归0了。
4项回归测试,也从2项失败变成全部通过;串行请求和不带禁用词的并发对照组,继续保持零错误。
一句话,一份新疆旅行攻略
除了编码任务,日常一些办公任务、生活常见的难题,都可以交给U2-Flash了。
扔给它一个看似宽泛、实际很吃细节的需求:
「做一个关于大美新疆的旅游攻略PPT,图文并茂,具有高级感。」
路线、景点、交通、住宿、美食、预算、注意事项,一个都不能少,还要加入图表和结束页。
信息这么多,稍不留神就会变成「文字搬家」。
U2-Flash先梳理章节和内容骨架,再安排配色、排版网格与视觉素材,把文字、图片和图表放进同一套设计里。
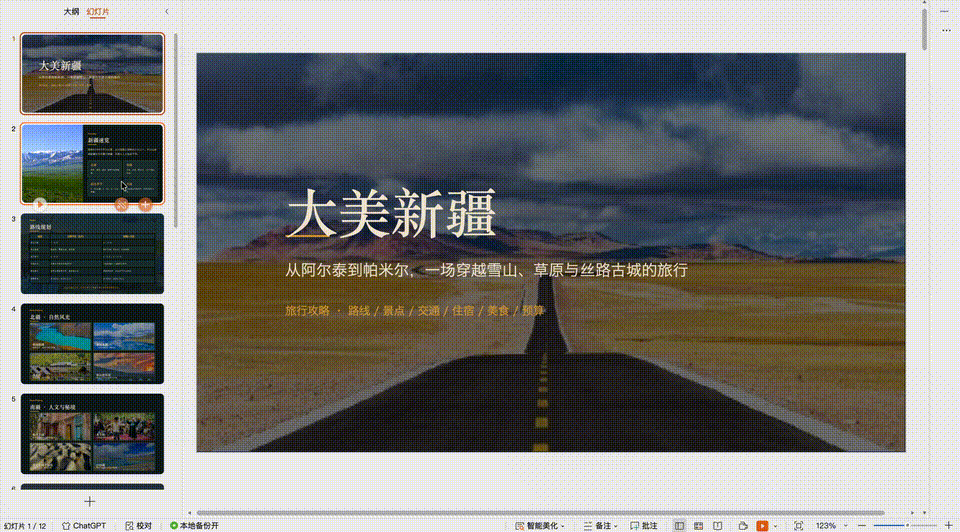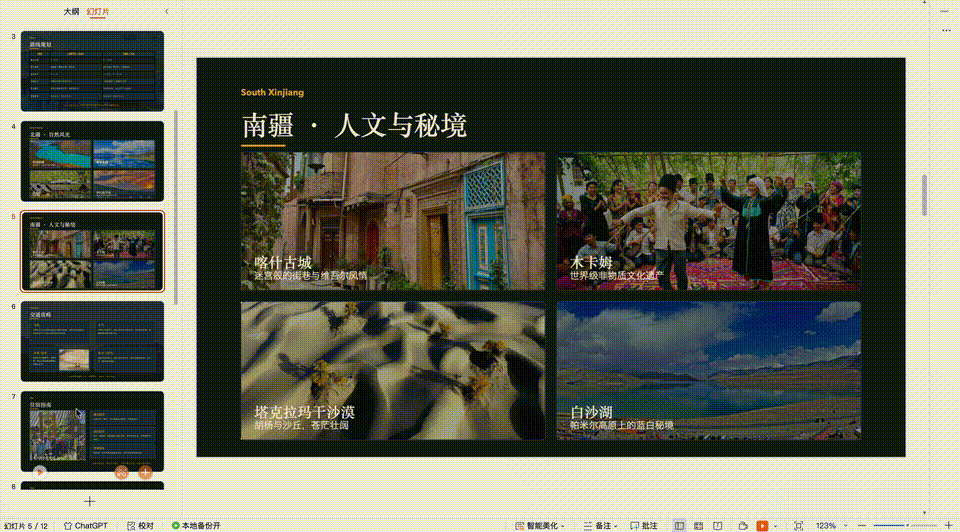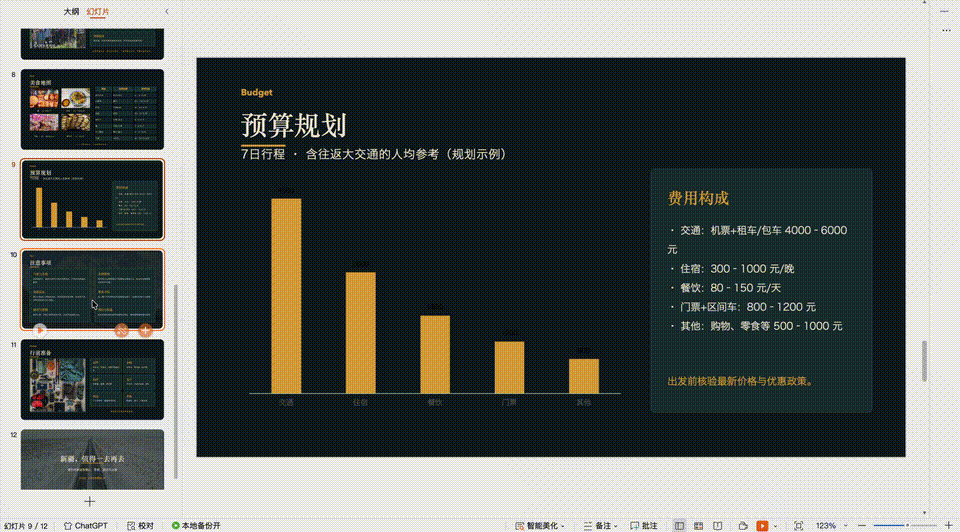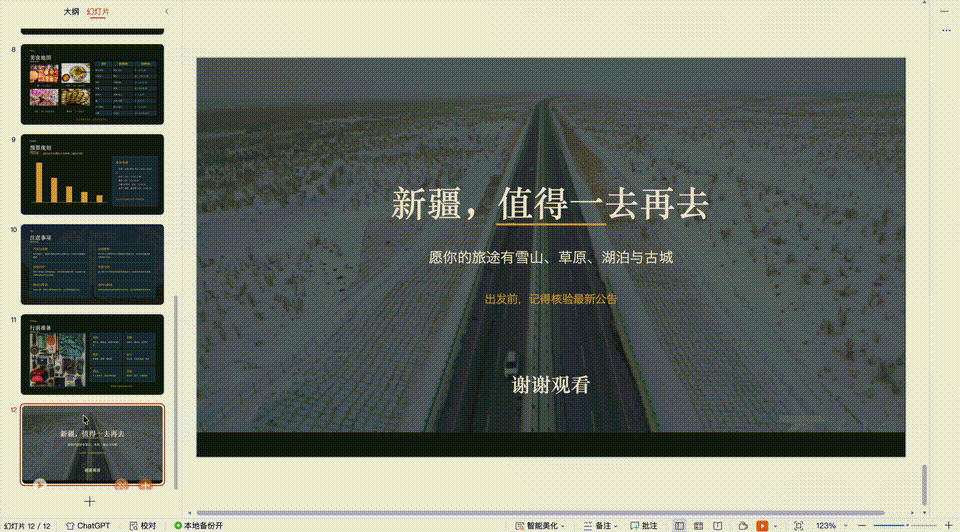
一整份旅行攻略PPT交付了,而且内容组织和页面编排一起完成。
这类任务,很容易被低估。做出一页好看的封面,和把一份内容丰富的攻略从头做到尾,是两种难度。
而U2-Flash从一句宽泛需求出发,同时接住了「讲什么」和「怎么呈现」两件事。
买房还是租房,算清一笔十年账
再来个特接地气的案例,手里攥着100万,到底该买房,还是继续租房?
到底哪个更划算?直接让U2-Flash把未来10年的账给你盘得明明白白。
设定了一组模拟条件——房子总价300万元,首付加交易、装修支出刚好100万元;租住同类住房,第一年月租5500元。
两边每月都有1.5万元预算,扣除住房支出,剩下的钱拿去投资。
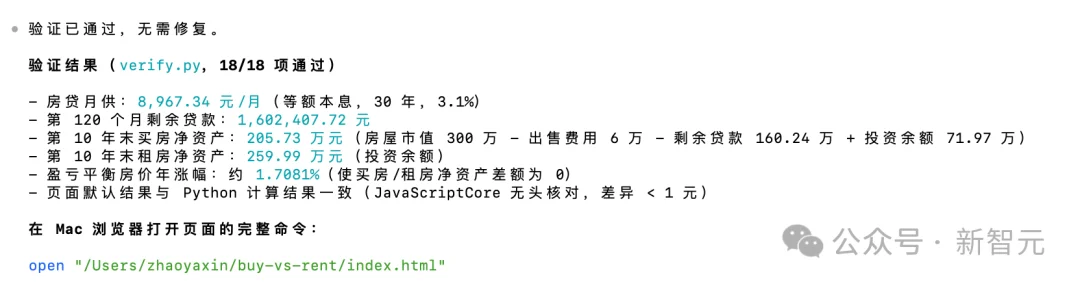
U2-Flash直接做出了一个可视化分析页面,按120个月逐月计算,把结果放在最上方:
在房价不涨、投资年化收益3%等假设下,租房方案10年后多出54.26万元净资产。

钱差在哪里?
这个HTML页面还把月供拆成本金和利息,也把剩余贷款、卖房费用计入最终结果,租房留下的100万元则持续计算投资收益。
它还找到了结论反转的临界点:其他条件不变,房价年涨约1.71%,两种方案就能打平。
这次U2-Flash做得讨巧的地方,是把复杂的账讲明白了。
终端记录显示,18项验证通过,网页默认结果与Python计算相差不到1元。
从「到底哪个划算」,到「为什么差这么多」,一页就能看明白。
一键搭出3D办公室
最后,再来看一道空间建模题。
输入一份结构化的2D办公室平面描述,让U2-Flash把它变成完整的3D场景。
听起来,只是从平面变成立体。但真正动手,中间隔着一整套工作流。
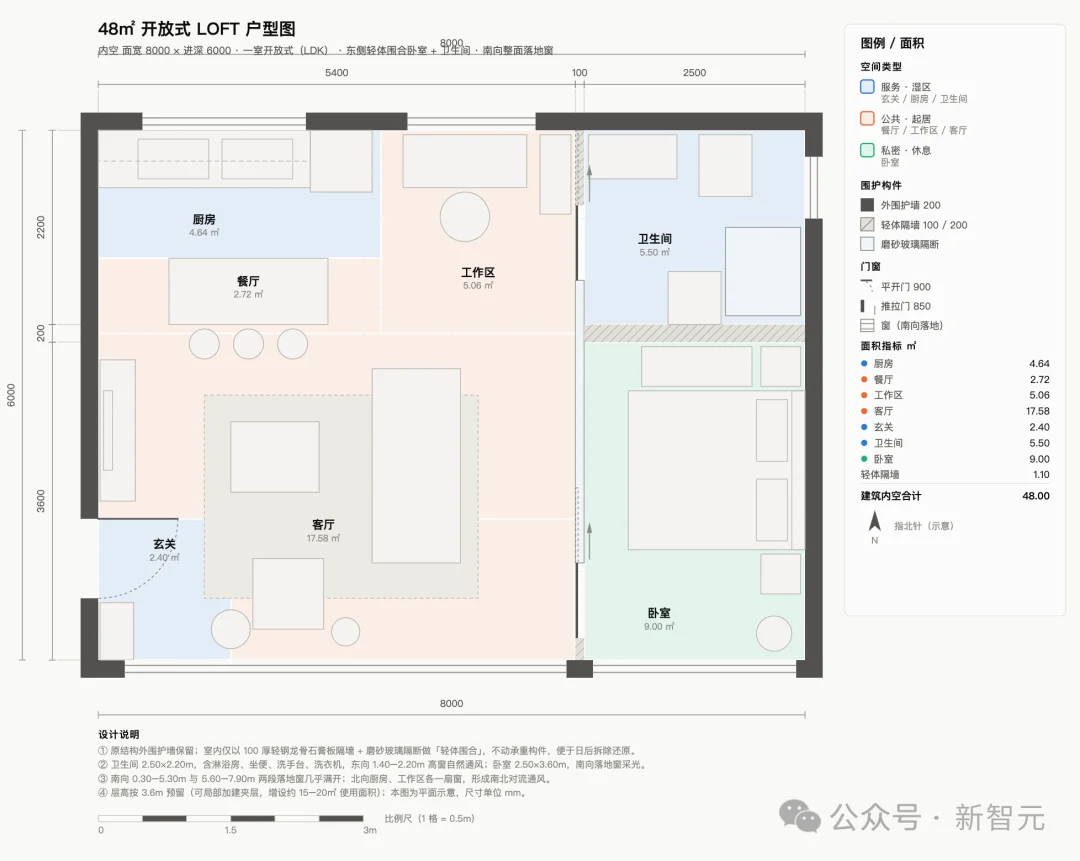
从平面到立体,中间隔着建模、脚本编写和渲染。任何一个环节出错,都可能让最后的画面「翻车」。
U2-Flash接下任务后,自主编写脚本,调用Blender渲染管线,把文字和结构化信息一步步变成可见的办公室场景。
更有意思的,是它在过程中处理的那些「小问题」。
布尔运算失败、法线翻转、光照死角,都进入了它的排查范围。
物体表面朝向不对、部分区域照不亮,都会影响最终效果,不能只看代码有没有执行成功。
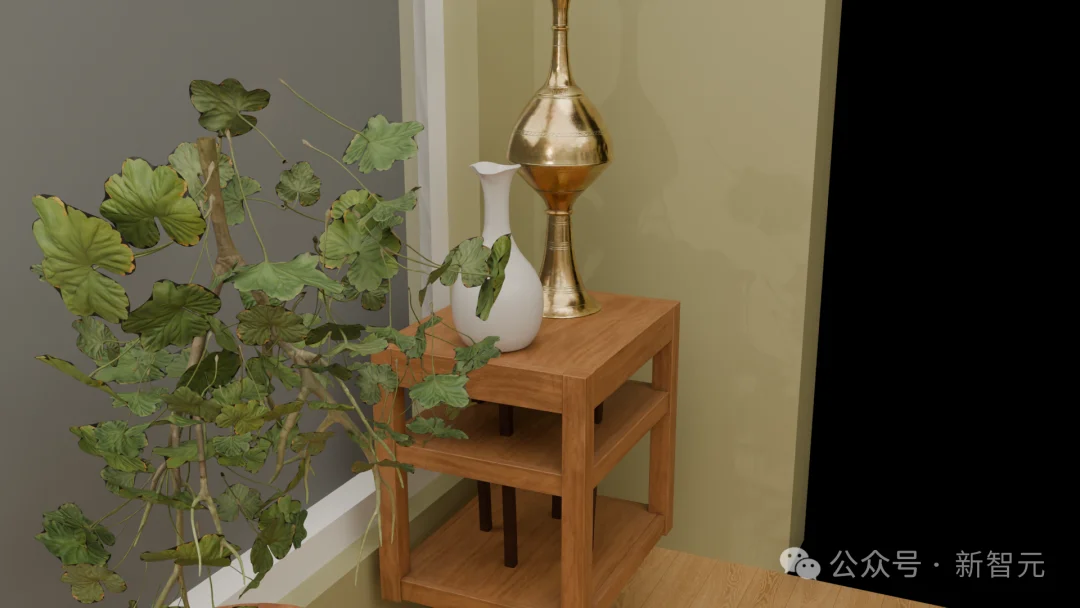
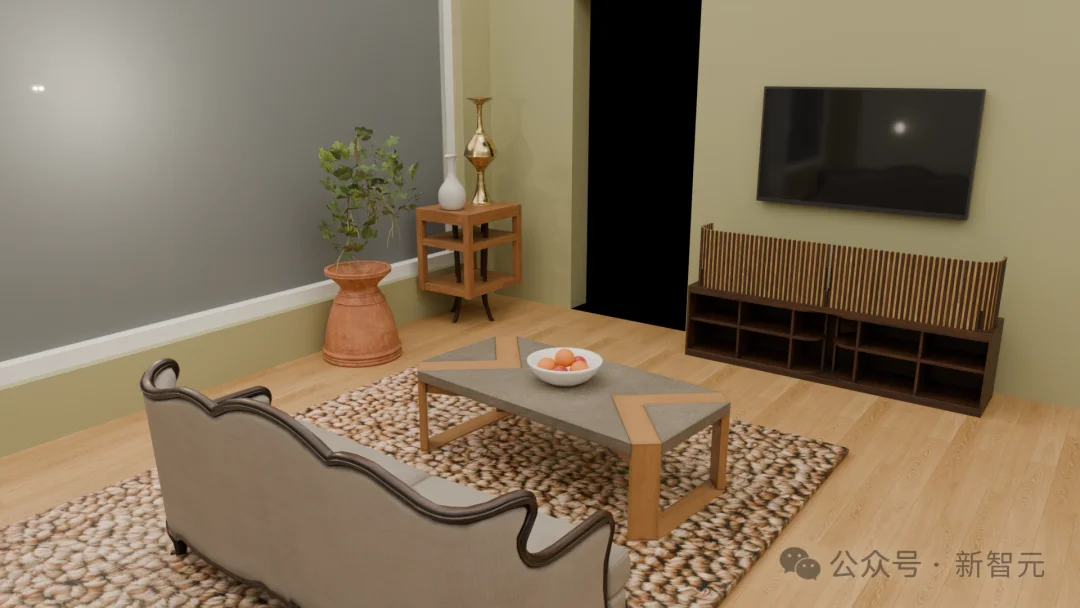
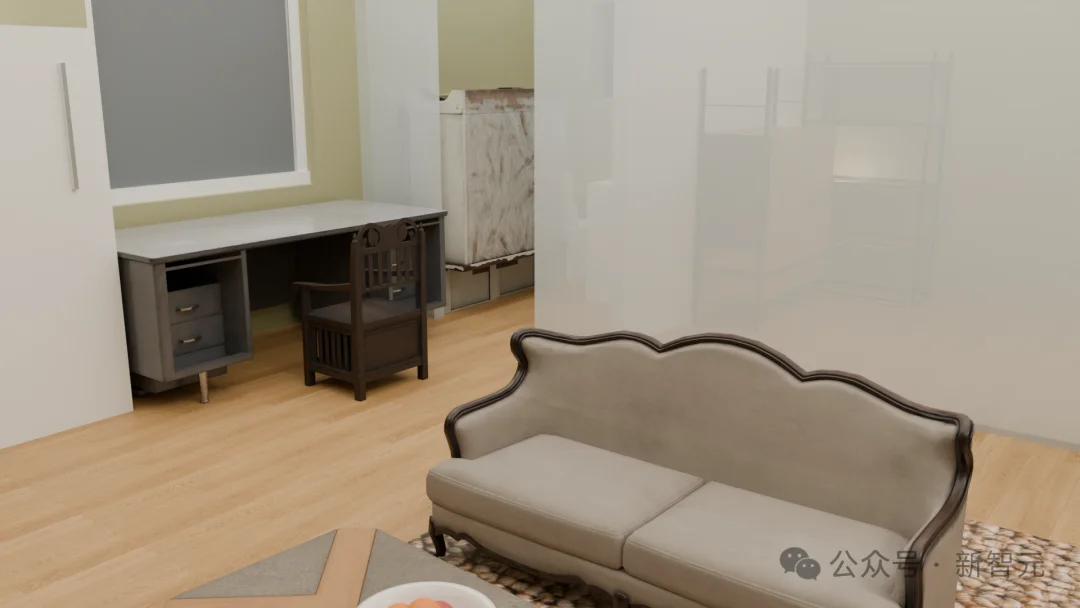
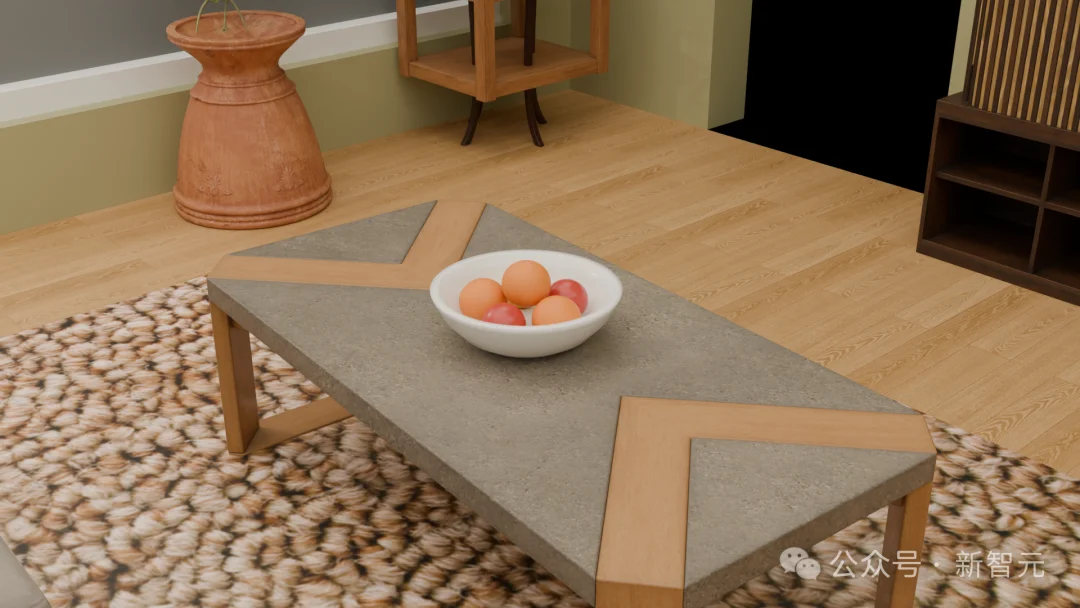
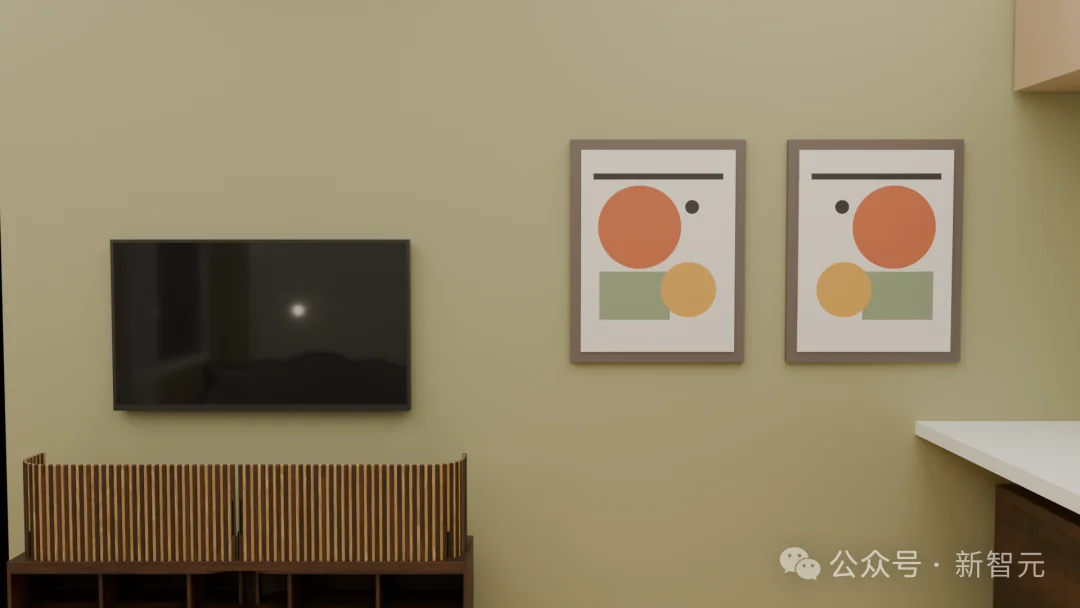
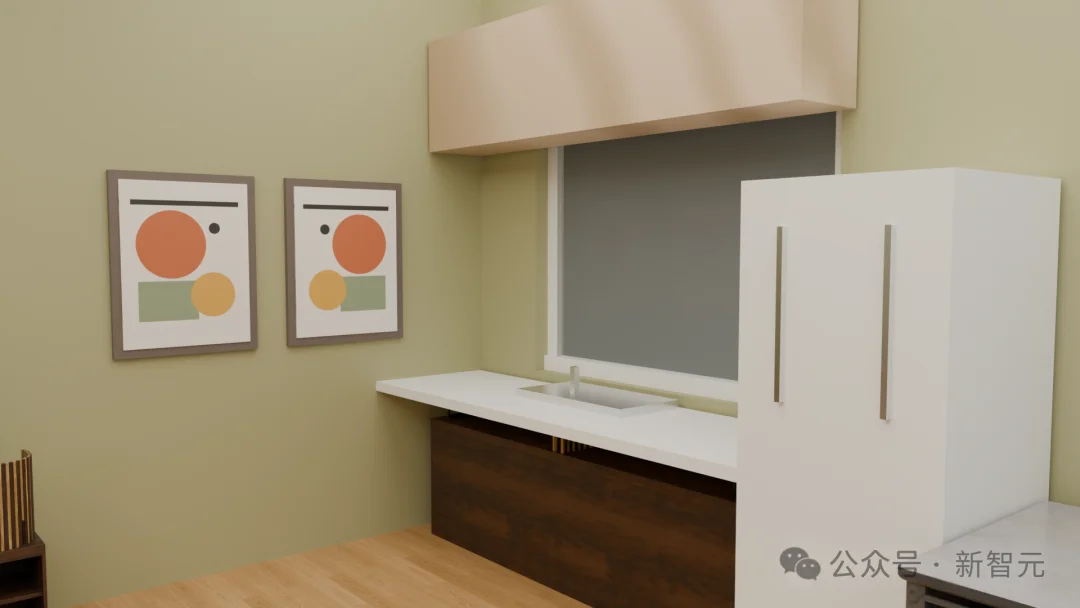
最终,一份平面描述,被推进成了完整的3D办公室场景。
这道题的分量,就藏在从写脚本到交付场景的那段路里。
Flash的体量
万亿模型的战斗力
测了一圈下来,U2-Flash最值得重新认识的,恰恰是名字里的「Flash」。
一款Flash模型,究竟能扛多重的活?
这一次,云知声给出的答案,可以说相当硬核——以Flash的体量,直接叫板主流万亿大模型。
U2-Flash采用稀疏混合专家架构,总参数约266B,单次推理仅激活约10B,激活比例不到4%。
编程、Agent、数学推理、指令遵循等能力,被统一装进同一套权重。
模型每次工作,只需调动其中一小部分专家参数。
按云知声的定位,它要用远小于同类稠密模型的激活规模,交付足以比肩主力稠密模型的任务完成质量。
支撑这份反差的,是在U2通用基座上开展的系统性后训练。保留原有基座规模,把理解、规划和自主执行能力一起往上推,才有了这次Flash的升级。
Flash的「轻」,终于和性能的「强」站到了一起。
先来看最能力提升关键的一项成绩单, 编码。
在考察软件工程问题解决能力的SWE-Bench Pro上,U2-Flash拿到61.6分,比前代U2提升10.5分。
更猛的跃升,还在后面。
在DeepSWE v1.1中,U2-Flash拿到64.6分。前代U2是32分,这次直接翻倍,并超过GLM5.3-Flash、DeepSeek-V4-Pro-0813等模型。
再看需要在终端环境里实际执行任务的TerminalBench 3.0:24.3分,是前代2.7分的9倍,超过K3等万亿参数级模型。
从代码工程到终端执行,两条能力线同时大幅上扬。这组反差,足够直观了。
研究团队还把考场,延伸到更广泛的代码仓库和私有仓库。在内部评测U2-SWE-Bench中,U2-Flash从30.8分升至57.5分。
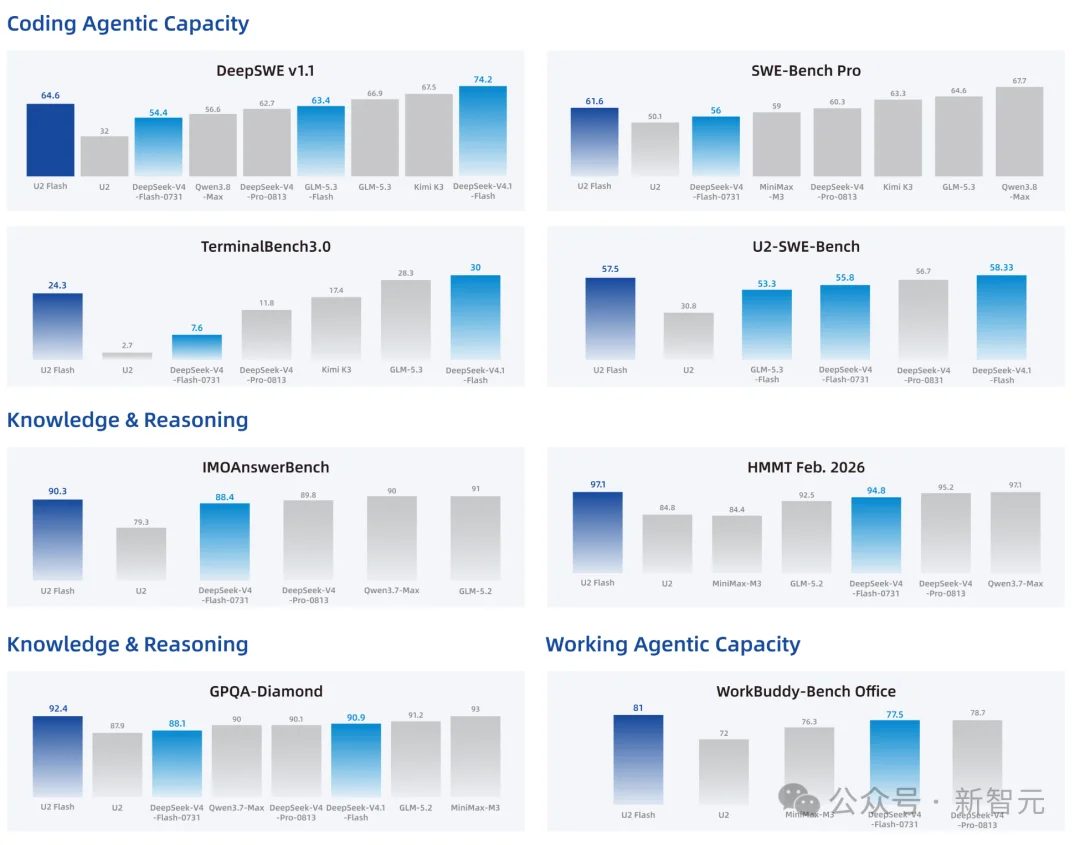
这些成绩背后,是模型处理复杂工程任务的能力跨过了一大步:读懂项目、定位问题、修改代码,再调用工具完成验证,整条链路都要跑通。
前面修复库存超卖的实测,就把这件事摆到了眼前。
从并发冲突到事务回滚,再到历史数据保留,模型需要同时守住多条业务约束,最后交出能复现的验证结果。
办公场景,同样敢和旗舰正面碰。
WorkBuddy-Bench Office评测中,U2-Flash拿到81分,直接挑落了DeepSeek-V4-Flash(77.5)、DeepSeek-V4-Pro(78.7)和GLM-5.2(79.6)。
此外,U2-Flash在知识与数学推理上表现优异:GPQA Diamond为92.4分,IMOAnswerBench为90.3分,HMMT Feb. 2026为97.1分。
把这些成绩放在一起看,这才是「高密度智能」模型,最有冲击力的地方——
参数规模没有堆到万亿,实际干活的表现,已经敢上旗舰的牌桌。
而支撑这份表现的机制之一,正是「隐式思考」。
U2-Flash在给出答案前,会先在高维隐藏状态空间中探索多条潜在解法路径,再依据问题难度,决定是否切换到显式推理。
这与潜空间推理(latent reasoning)的方向一致:让一部分思考留在内部的连续表示空间,减少必须显式生成的中间Token。
也就是说,一部分解题探索先在模型内部进行,不必全部展开成屏幕上的文字;需要深入推演时,再把推理步骤显式写出来。
这也把能力、速度和Token消耗联系了起来:有限的输出,要尽量用在推进任务上。
思考多深,用户还能自己调。
四种推理强度,对应none、low、high、max。人们可以按任务复杂度,在响应速度和推理深度之间做选择。
高强度档位,可以提供完整可读的显式推理链条,让推理过程可核查、可追溯。
<