


过去一年半,Tabbit 一直在尝试让 Agent 像人一样使用浏览器:看截图、读 DOM、找按钮,再一步步点击。他们花了大量精力优化工具和 Harness,但始终没等来「好用」的临界点。
直到 Codex 用一个循环完成 200 多条后台配置,Tabbit 意识到,浏览器操作也可以被抽象成编程问题。模型直接写代码、组织循环、保留状态,复杂任务变得更快、更稳定。
这篇文章完整复盘了 Tabbit 对 Browser Use 的探索,为何推翻原来的 GUI 路线、转向 Coding-first,又如何重新搭建 Tabbit CLI。这是一个做产品很难回避的「苦涩教训」:模型能力跨过临界点后,过去精心搭建的脚手架,反而可能成为限制。
以下为原文内容,Founder Park 授权转载自「潦草学者」。
在计算机科学长达七十年的演进史上,存在一个近乎宿命般的规律:
- AI researchers have often tried to build knowledge into their agents 人工智能研究者常常试图将知识直接嵌入其智能体中;
- this always helps in the short term, and is personally satisfying to the researcher 这种方法短期内总能见效,且令研究者个人感到满足;
- but in the long run it plateaus and even inhibits further progress, 但从长远来看,它终将遭遇瓶颈,甚至阻碍进一步发展;
- breakthrough progress eventually arrives by an opposing approach based on scaling computation by search and learning. 真正的突破性进展最终源于一种截然相反的方法——即通过扩大搜索与学习所需的计算规模来实现。
这就是强化学习之父理查德·萨顿(Richard Sutton)在 2019 年写下的著名论断:《The Bitter Lesson》(苦涩的教训)。
过去一年半里,Tabbit 团队一直在研究 Browser Use。
- 为了让模型能够从实验室走向用户的真实场景,我们围绕用户真实使用的网站,构建了内部的测评集。
- 从 Harness 架构设计到浏览器内核的底层,小到一个工具的设计,大到模型训练;
- 为了让模型「看懂」页面,我们把 DOM 树压缩成上百种标签,裁剪不可见元素,把榨干到极致;
- 为了让模型能够点的更准,我们测试了超过几百种模型+harness 的组合
但直到大模型的能力跨过某个临界点,模型的进步几乎在一夜之间,颠覆了我们原来的架构。我们又不得不及时转向,拥抱最前沿的架构设计。
一直迭代到今天,Tabbit 的 Browser Use 已经具备了领先的 SOTA 级别能力。
越是走到最后,我们越是深刻地体会到计算机领域那句名言的分量——The Bitter Lesson(苦涩的教训)。
今天我们就来聊聊 Tabbit 上到的这场 Browser Use 的苦涩的教训。
这是一篇用真实的工程血泪、无数次深夜推翻重来、以及击败次 Benchmark 跑出来的完整实录。
01
让 Agent 像人类一样操控浏览器
从自动化测试到 Browser-Use 开源
浏览器的本质是把各种远程或本地的资源,变成一个可以交互的「运行中的页面」。
你访问一个网址,服务器返回的只是一段文本,比如 <h1>Hello</h1>。浏览器拿到后,要经过这些步骤:
HTML 文本 → 解析成 DOM tree → 结合 CSS 样式 → 计算布局 → 绘制页面
在浏览器内部都是 DOM 里的一个个节点。想让程序操控网页,本质上就是从外部去读取和修改这些节点,再模拟点击和输入。
在大模型进入浏览器之前,这件事就已经有很多人在做,目的主要是开发者的自动化测试。当时的做法是,人把每一步提前写成脚本,比如打开哪个网址、等哪个元素出现、点哪个按钮,程序只负责照做。
- 2004 · Selenium:最早的主流方案,后来的 WebDriver 成为 W3C 标准。
- 2011 · PhantomJS:没有界面的「隐形浏览器」。
- 2017 · Puppeteer:Chrome 团队推出,基于 CDP(Chrome 开发者工具底层通道)。
- 2020 · Playwright:微软推出,支持多种浏览器,自带自动等待与深入的控制通道。
CDP 几乎能碰到浏览器里的一切,但写起来很繁琐。
Puppeteer 和 Playwright 把它包装成了易用的接口,比如点一个按钮只要一行:
await
page.getByRole('button', { name: '保存' }).click();
这套工具本来是给程序员用的。
但后来他们成为 Browser Use 的关键,不过,这是后话了。
Browser-Use 0.1 开源与 GUI 仿真循环
2024 年 11 月,Browser Use 正式开源。
当时默认接入的模型是 GPT-4o,但 GPT-4o 并没有专门针对 Computer Use 进行过定向训练,无法可靠地理解自己在复杂网页上究竟能做什么。
Browser Use 为了让模型可以完成浏览器操控任务,给 Agent 提供了十个工具:
- search_google:用 Google 搜索关键词
- go_to_url:在当前标签页打开指定网址
- go_back:返回上一页
- click_element:根据页面元素编号点击按钮、链接等
- input_text:根据元素编号向输入框输入文字
- extract_page_content:提取当前页面正文,返回 Markdown
- switch_tab:切换到指定浏览器标签页
- open_tab:新建标签页并打开网址
- nothing:新建标签页并打开网址
- done:结束任务并向用户返回结果
每一步执行的时候,browser 还自动执行了
- take_screenshot():截图,每步在启用视觉时截图,随状态返回
- get_current_state():读取页面元素、URL、标题、元素选择器映射及标签页信息
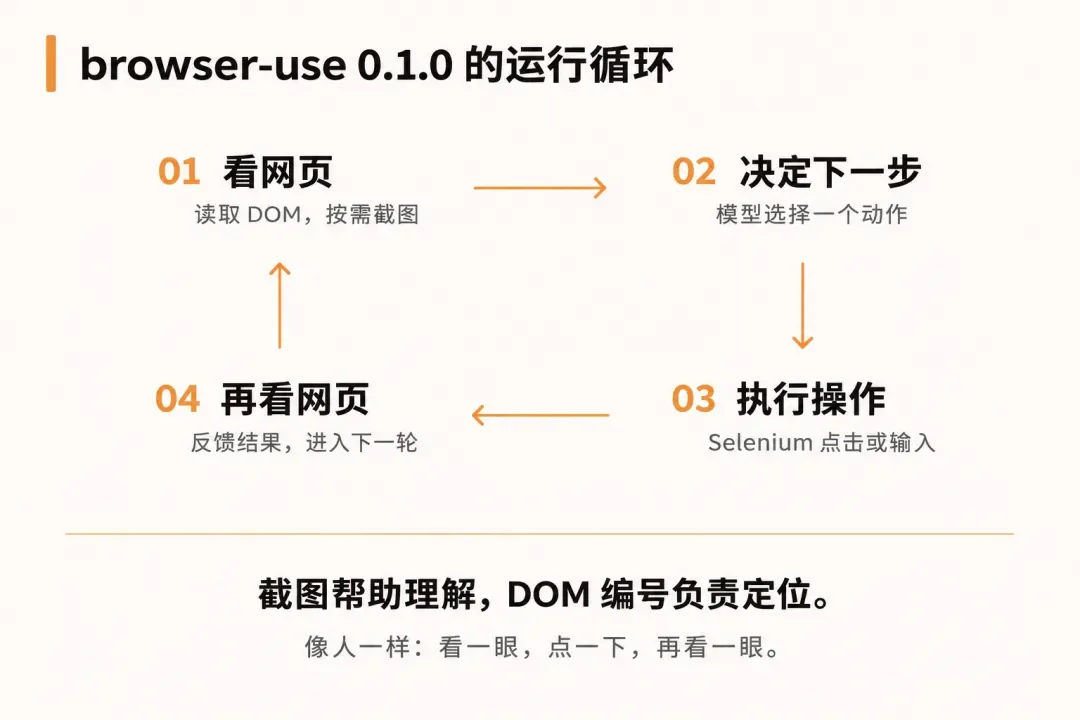
browser-use 0.1.0 的运行方式,就是典型的 GUI 的思路。
「看网页 → 模型决定下一步 → 执行操作 → 再看网页」的循环。
- 用户发出任务:例如「搜索某个产品,整理价格」。
- 程序会读取当前浏览器状态:程序会读取当前网址、标签页信息,并从 DOM 中整理页面元素,给可交互元素分配编号,例如「12:搜索框」「18:搜索按钮」。开启视觉时,同时截一张图。
- 把页面信息和截图交给 Agent:模型收到任务、历史记录、当前元素列表、标签页信息和截图,判断下一步该做什么。
- 模型一次选择一个动作:它返回结构化结果,包含对上一步的评价、任务记忆、下一步目标,以及一个动作。例如:input_text(id=12, text="browser-use")。
- browser-use 执行动作:控制器把元素编号映射到实际元素的 XPath,再通过 Selenium 点击或输入;导航、切换标签页等也由 Selenium 执行。执行结果或错误会反馈给模型。
- 不断重复,直到结束:循环这个过程。在需要完整正文时也会调用 extract_page_content;遇到缺失信息可以 ask_human 来询问用户;完成后调用 done 返回结果。默认最多运行 100 步。
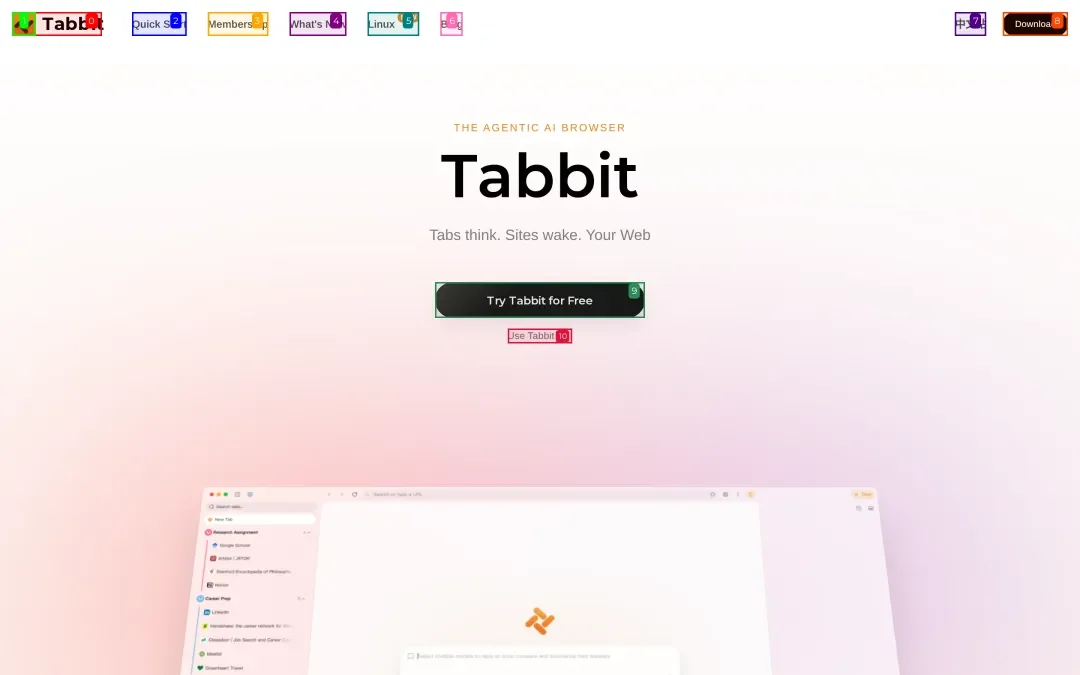
为了让当时的模型更好地理解页面信息。他们还在页面上面给网页打上了标签。
通过 dom 信息和截图结合,让模型更好地理解页面内容。(比如下面的图)
这个流程的设计的美妙之处在于:
人不也是这样使用浏览器的吗?看一眼,点一下,再看一眼。
只是人类的 React(观察-思考-行动循环)的速度要快得多。
除了 Browser-Use 这个开源项目外,围绕怎样让 Agent 操作浏览器,业界也做了很多了不同的尝试。
一是 Browserbase 的 Stagehand,把自然语言意图和代码执行结合起来,让开发者可以用「点击登录」「提取列表」等高层描述完成交互;
二是微软的Playwright MCP,通过 MCP 协议把页面的结构化信息和浏览器底层操作能力交付给模型;
Vercel Labs 的 agent-browser也把这套能力包装成了轻量命令行工具。Agent 可以先获取一份精简的页面快照,再通过元素编号执行点击与输入,更低门槛地接入现成的 Coding Agent。
这些方案都是和 Browser-Use 类似的思路。通过提供各种 tools 来让 Agent 像人类一样操控浏览器。
就这样,看起来多了很多 Browser Use 的工具和框架。
但整整一年多过去,一直到 2026 年,这些 Browser Use 的工具迭代了很多版本,增加了很多细节。却一直没有迎来从「可用」到「好用」的临界点。
速度慢,点不准,失败率高是用户最经常诟病的问题。模型能力似乎就是还不能很好地完成浏览器操控的任务。
沿着让 Agent 像人类一样操控浏览器的方向,Tabbit 第一版本的 Browser Use 同样走这样的 GUI 路线。
在当时的模型能力下,Browser Use 的任务对于模型来说非常困难。举例来说,模型在输出 click_element 点击事件时,很多网页复杂组件(如飞书多维表格、各类云文档画布)的内部元素根本没有合法的 DOM 节点,无法通过选择器定位,只能退而求其次让模型输出 click_coordinates,去预测精准的 (x, y) 坐标。
即便有了 Dom 信息的加持,给网页加上了框框。但在一些复杂的页面,例如 google sheets 或者飞书多为表格这样,把页面交互都嵌套在 canva 里面的页面,DOM 信息根本无法提供判断,甚至还会干扰模型的选择。
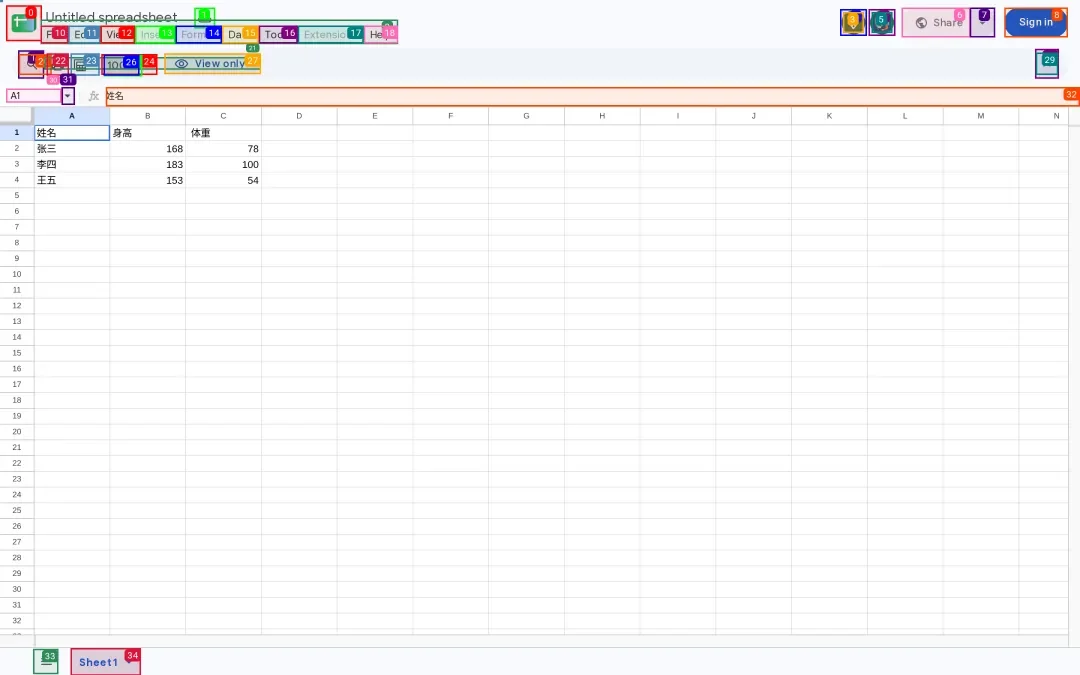
在当时,即便是像 Claude 3.5 Sonnet 或 Opus 这类顶级模型,在真实网页截图上也经常出现几十像素的坐标漂移;换到当时大部分尚未支持原生多模态的国产模型上,让它在千奇百怪的分辨率下盲猜坐标,简直是一场灾难。
所以当时,模型执行成功一个 Browser Use 任务的成功率只有可怜的 60% 左右。
Seed 1.8 让人看到了曙光
直到字节跳动发布 Seed 1.8 模型,似乎让我们又看到了一丝希望。当时豆包手机内测版亮相,官方公布在 Seed 1.8 的训练过程中融入了大量真实的移动端与 GUI 操作轨迹。
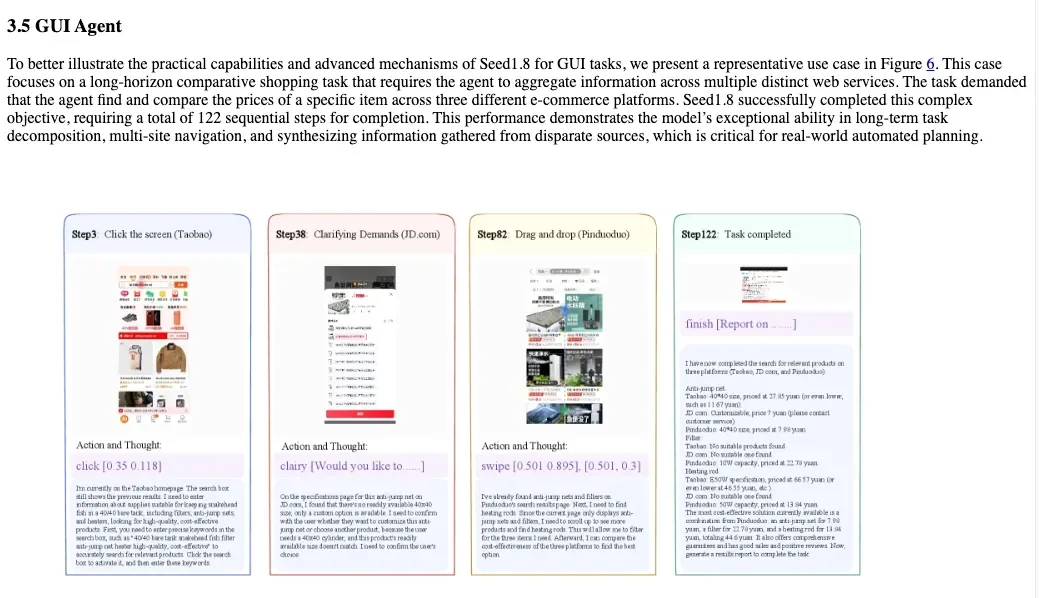
当时我看到这个消息的时候,很兴奋,想着这不正是我们想要的能力嘛,说不定 Browser Use 100% 的成功率就差这神之一手!
于是第一时间进行了测试...
果然!Seed 1.8 的 GUI 操作能力是史无前例的强大的。他在这需要点击任务上面的准确率非常高。在一些 GUi 点击为主的任务上,Seed 1.8 在我们内部的 benchmark 成绩甚至完爆了 claude 的模型。
比较有趣的发现是 Seed 1.8 在操作一些手机上面没有的组件时,显得比较笨拙,譬如点击下拉框,滑动或输入来找到选项,再选中选项。这种下拉框选择在 PC 端产品上面是常见的交互,手机上却比较少。在进行这种交互时,Seed 1.8 还是经常会犯错误。
但另一方面,缺点是,Seed 1.8 的模型参数量不大,智力比较差,在一些需要智能的任务上,表现欠佳。
我们一直很期待 Seed 2.0 系列的模型可以将 Seed 1.8 的优势放大,并提升智力。
后来,Seed 2.0 确实如期发布...
结果谁想到 Seed 2.0 系列模型的表现得比 Seed 1.8 还差。
Seed 1.8 上面强大的 GUI 能力,甚至在 Seed 2.0 系列上面还退步了。。。
想来,并没有加入相关的数据训练,实在是让人感到惋惜。
Google 也重度下注:APC 与 GLIC 架构
无独有偶,Google 也选择了 GUI 的路线。它甚至把感知和执行做进了 Chromium 内部。
在 Chromium 源码里,这套集成层叫 GLIC。它的页面感知能力依赖 APC(Annotated Page Content),动作则交给 Actor 框架。
APC 更像是 Google 为了 Browser Use 设计的一套新的网页的内容格式。区别于 DOM 信息,APC 是遍历网页 Blink 的 layout tree,把渲染后的页面整理成结构化内容。一个节点可以包含文本、角色、位置、样式、链接、表单状态,以及是否可点击、可编辑、可聚焦等信息。
APC 的内容非常全,但内容也大的可怕。甚至可以理解为,APC 就是把网页的图片信息,硬生生用文本的方式塞给了模型。
或许也因为上下文的压力,Google 尝试着将一次读取信息以后,输出多个动作。
2026 年 6 月,Google 宣布将 Computer Use 原生集成进 Gemini 3.5 Flash。从 Google 的官方文档 (10) 可以看出,它支持一轮返回多个动作并在执行后再回传新截图,这与我们在 GLIC 框架下的观察相吻合。
而且经过我的实测,甚至我一度怀疑,google 在这个方向方向上面训练了 Gemini-3.5-flash 和 Gemini-3.6-flash 两代模型。
在我们内部的测评中,发现了 Gemini 3.5/3.6 Flash 在 GLIC 这套框架的表现下,Gemini 3.5/3.6 Flash 两代模型,倾向于在看完一张截图以后,就连续地触发几个动作进行操作,再进行下一步的观察和行动的循环。在一次响应里给出多个工具调用,也就是 batch tools,可以说是 google 独特的 taste。
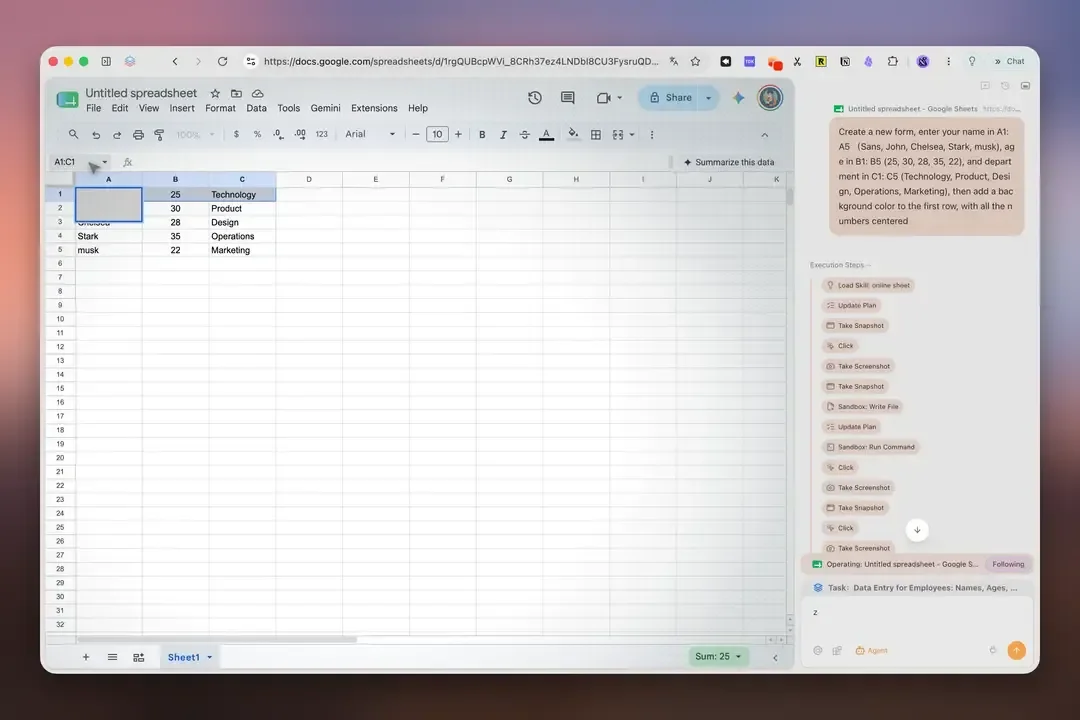
当然,这里只是我的基于测试和观察的猜测,并非 Google 公开的训练机制。
后来有一点也可以佐证,Google 的模型对执行动作的偏好比其他模型强大很多。
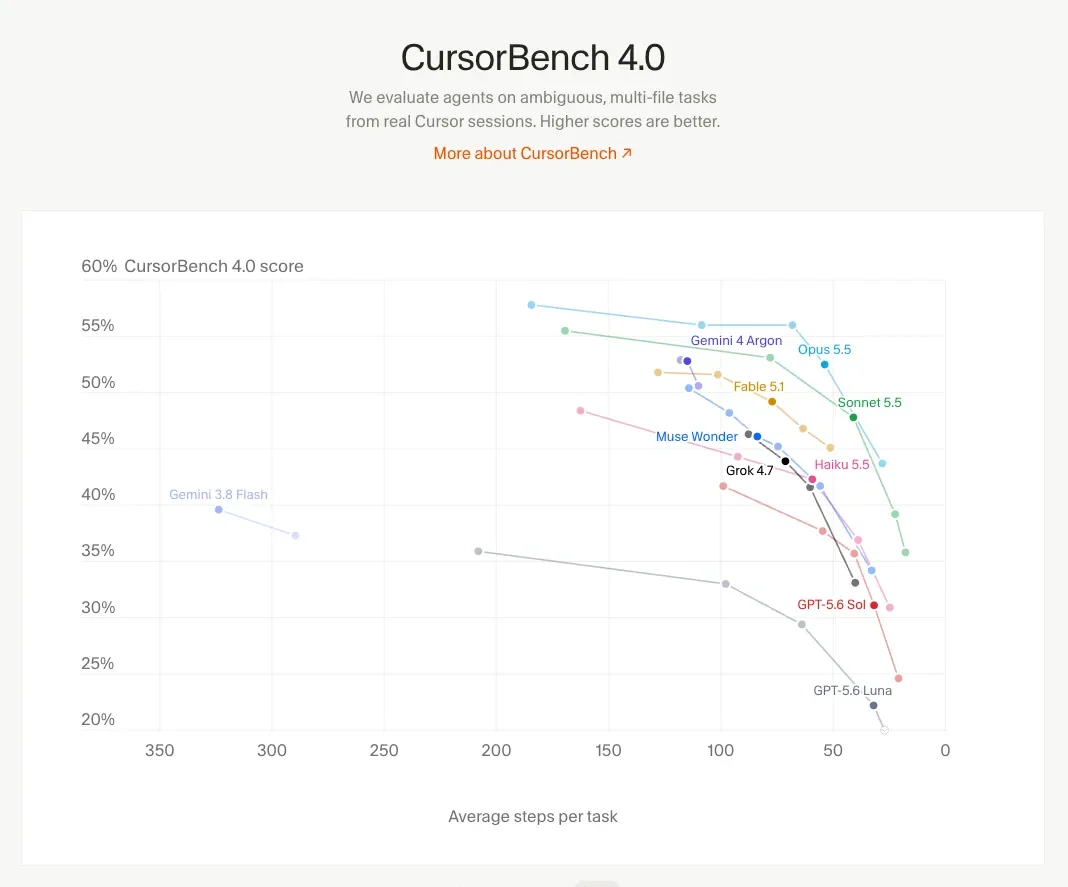
在 CursorBench 4.0 的基准测试中,Gemini Flash 系列平均每个任务的步骤数,远远超过其他的模型。Gemini Flash 系列的模型,就像一个精力过剩的「多动症小孩」,不怎么喜欢深度思考,但格外喜欢快速执行动作。
但这样的特点,很明显并没有被继承到 Gemini 4 系列上面。
Google 有浏览器,有数据,有模型,他完全有能力定义这样一套新的方式。
但从浏览器底层,到接口层,到模型训练,全部都投入精力以后。Google 拿出的成绩也并没有取得很好的效果。
Google 选择的方向也并没有带来很大的突破。
在我们内部的测评集中,Gem