


回顾9月,AI圈的重磅新闻一个接一个。
9月4日,OpenAI发布GPT-6 Astra。这个发布报告里只字未提机器人的通用模型,转身就空降了机器人评测榜首,甚至让一批机器人Benchmark直接失效。有人半开玩笑地说:机器人领域等了这么多年的“GPT时刻”,居然是GPT自己。
Meta Muse给每个用户配了一台云端电脑,两周就冲上美区App Store榜首;竞争对手Instinct一个月内估值从25亿涨到100亿美元。个人Agent掀起了新一轮烧钱获客大战,可它们能打开的网页,正在一个一个被关上。
AI for Science方面,Claude只用了21小时就找到一种结构像CRISPR的新酶系统ART,AI圈很兴奋,因为AI开始做科学发现了,生物圈的反应则相对平淡,大家想在实验室里验证了再说,为什么会有这种反差现象?
当模型进化到普通人难以感受到它的进化,研究者的感受是什么样的?本期《硅谷101》,我们请来三位分别站在Agent、机器人和AI制药一线的研究者——Pokee.ai创始人兼CEO朱哲清,破壳机器人创始人、清华大学交叉信息研究院助理教授许华哲,华盛顿大学计算机学院助理教授王晟,一起聊清楚三件事:个人Agent商业化卡在哪?机器人怎么被Astra这样的底层模型冲击?AI制药真正的瓶颈是什么?
欢迎关注《硅谷101视频号》或音频栏目直接收听本期播客。如果你喜欢我们的节目,更推荐大家使用音频客户端来收听,《硅谷101》已覆盖各大主流音频平台(渠道见文末),欢迎订阅!
以下是这次对话内容的精选:
泓君:Astra发布后,你们有没有使用过这个产品?或者说我们来看网上的demo,大家觉得最让你惊艳的一个demo是什么?
许华哲:因为我是做机器人的,我们测了很多Astra在做机器人任务上面的一些能力。我们看到的第一个点就是,它的适应能力非常强。比如说给它某一个机器人本体,让它去做相应的事情,那它很快会发现,这个机器人的运动速度比较快,或者这个机器人的运动空间是怎样的,比如它撞到桌子了,它会说,这个桌子蛮高的,那我是不是应该把手抬得更高一点?这其实是把CoT(思维链)这种反思过程的能力,变成一个它实际的动作的能力,这是过去的很多机器人的模型和大模型都不具备的。
另一个是它自我更新、自我升级的能力。因为它有这样的反思,它可以一次一次做同样的事情,每一次做得更好。这个其实在网上大家也看到了,有人拿Astra去操作一个机器人机械臂去画金门大桥,那它第一次画的还是比较差的,但是它画完了以后,它会再想怎么样能画的更好,经过几轮的迭代,它就可以画的非常逼真。
我们试了非常多其他的,比如插花,这是一个经典的机器人任务。我们给它加了一些额外难度,那朵花的茎被劈开两半,有点分叉。这个时候它会知道,因为它分叉了,所以我要捏住这个分叉,把它捏窄一点,再往里塞。这样的能力其实还是比较惊艳的。
泓君:它其实已经理解了一些物理世界操作的规范。
许华哲:我觉得本质上还是理解3D,因为这件事情它还是从三维尺寸层面就可以做出一些理解,但是确实这样的理解已经能够帮助到非常多的非动态的物理世界操作任务了。
泓君:我看网上还有一些很有意思的demo是,他们在用Astra做生成3D的视频,非常的快,然后渲染也很好。
许华哲:这是另一个Astra在机器人方面很令人震惊的能力,就是给它几张图片,它可以很快把图片仿真生成出来。学术圈可能把它叫做Real-to-Sim。这件事过去是需要拍大量的视频照片,需要很多人的手工标定修改。但现在你给Astra这样一个指令,它很快就把整个实验室或者办公室的环境给你复现出来了。那你拿着这样的仿真,可以去训你的机器人,那也会有一个在仿真上面的提升。
朱哲清:我们是做模型公司的,Astra在发布的时候,非常强调他们在后训练、模型开发等等上面的一些迭代能力。试下来以后,并没有那么惊艳,但是它确实在长程任务上面和迭代上面,比之前的几版模型有一个比较稳定的提升。与原来的模型相比,它能够对上下文以及之前完成的任务有更稳定的认知,不会出现太多的幻觉的情况。所以从我们的目前的体验来说还是比较好的。
但可能有几个问题:速度相对来说会慢一些,也有可能跟现在用量很高有关系。同时在更加长程的任务上,比如说让它跑一个晚上,幻觉还是会发生。所以它并没有根本上解决,但总体来说还是提升了不少。
我有朋友同测了一些前端以及设计的任务。从前端的审美跟认知上面,我觉得还是有比较大的提升的。可能是在训练的时候,对于设计和审美方向有特殊的训练有关系。
泓君:Bill,这轮Astra的发布,你觉得从模型对行业的影响来看,它跟当年opus 4.6、4.7的发布,从Coding能力的进化来比,它是一个大的节点吗?
朱哲清:单纯Coding来说,可能没有那么大的一个节点。4.5到4.6,当时我们的体感是一个几乎范式式的转变,原来只能依赖它做短程Coding,几个file的改动,做一些简单的小项目,到4.6那一次模型以后,基本上你会感受到工具调用几乎不会出错了,它去做一些长程的Coding任务,可以自主进行了。
而现在Astra只是说可以做到更长程的任务,幻觉是可以降更低,审美变得更好。但它没有做到说,我能够解决一个完全以前完全解决不了的问题。
王晟:我觉得是一个大的节点。我们现在已经都从之前Claude等系列模型切换到GPT-6 Astra来做我们的biomedical内部的任务了。我主要是做AI for Science,里面核心的就是AI for一些biomedical的应用。
我们用Astra有两个特别好用的地方,一个是Computer Use,一个是一些长程的任务。
Computer Use这方面,我们会用Astra来操作一些生物医学领域很多年前编写的那些软件,这些软件在领域内默认要使用,但它们其实都非常难用,界面设计的也不好,还有很多的术语,所以对一些跨领域的人来说,使用成本是非常高的。
但是Astra它的Computer Use功能,可以直接根据一些简单的prompt,就可以操作得比较好。并且我还可以跟它学习怎么用这个软件,毕竟在生物医学领域,很多人对AI工具的接受度比较低。Astra可能把这些软件对应的在网上的一些教程,别人之前用过的一些用户日志,一些反馈全部都以文字的形式学进去了,所以它真的理解怎么用这些软件。
另一方面就是长程的任务,我们生物医学这块,任务会比较复杂,这些任务有时候会持续8至24小时,Astra会做得比较好。它比起其他的一些模型,做得比较慢,但挺让我放心的,说明它可能会更深思熟虑一点。
我们现在一般切换着用,白天用一些反馈比较快的模型,到了准备让模型跑一晚上的时候,就用Astra来设计一个比较长程的pipeline或者prompt。这也是它比较值得信赖的一点,在AI for Science这个领域里面的一些表现。
泓君:我没有想到Computer Use的这个功能居然在AI for Science领域能帮助到大家这么多。
王晟:Astra在这次发布时候做了两个生物医学的demo。其中一个就是Computer Use demo,这个demo在我们圈子内是出圈了,大家发现,原来可以直接用Astra来操作一个生物医学的tool。它当时操作的一个tool叫MultiQC,是一个挺常用的网页工具。我们开始用这个功能,发现它比想象的要好用很多。其实Computer Use这个功能我觉得之前的模型也具备,只是大家没有开始真的思考怎么把它融入我们科研中的pipeline里面。
泓君:Bill,你可不可以一句话解释一下,什么是Computer Use?
朱哲清:Computer Use是通过模型对于视觉的理解,来决定这个agent下一步要在屏幕上点击哪个部分,或者输入哪些文字,来完成一系列的任务。当它可以串联这么几十个动作的时候,可以完成一个最终人类想要达到的一个目的。
泓君:就它跟API的区别是,你不用给接口,不用给密码,它直接像人一样去操作跟使用电脑。
朱哲清:就是它看到的是人类看到的屏幕,看到人类看到的UI,看到人类看到的所有的视觉和可以交互的界面。通过人类可以使用的电脑的输入输出设备来完成这些任务。
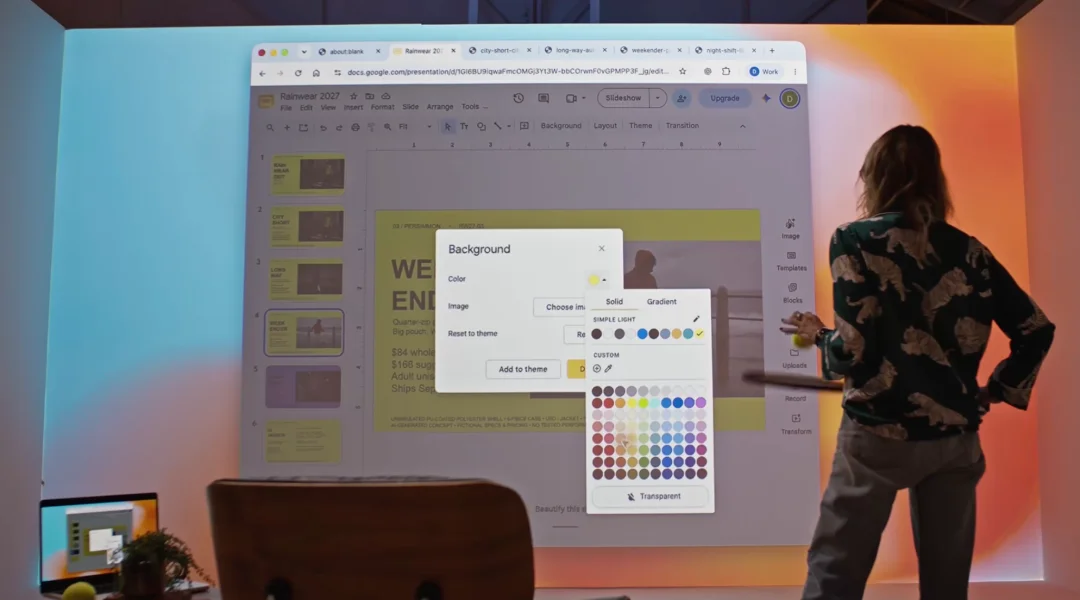
Astra宣传片中展示的Computer Use场景 图片来源:OpenAI
泓君:我觉得Computer Use之前好像也有,为什么Astra的发布,又重新把Computer Use带火了?
朱哲清:感觉Computer Use现在比原来又火了一波。之前大家觉得所有的工具都会开API,所有的工具都会有agent access(访问权限)的接口,很多的APP也好,系统也好,都在做agent native(原生智能体)的set up。
但是最近,不管是Instinct也好,还是Meta Muse也好,背后其实都接了浏览器。有一个比较大的问题就是有很多第三方的APP或者Amazon也好,比如说一些shopping的APP也好,travel的一些APP也好,他们其实是不愿意开放API的。
我觉得这又回到了当年Manus的情况,就是Manus最开始做了Browser Use(浏览器操作),后面很多别家也跟上,后面大家发现这个不是很高效。大家都回到Coding和API调用,现在好像有些东西避不开,又回到了Computer Use,所以我觉得最后有可能还是个mixture的状态。
我这边有一个比较有意思的看法,因为我们目前是focus on相对比较小的一些模型,比如说我们基本上现在发布的model都30B左右的模型,是可以在端侧和私有算力上面去进行的。比如说我有一台小的AI box,或者说我有一个AI PC,它就可以跑这个模型了。
未来如果说这个Browser Use本身发生在你的机器上面,而不是发生在云端,那就会改变Browser Use本身可能会给你带来的一个瓶颈。因为现在的远程的Browser Use都是通过商用机器,最多找一个像Bright Data或者说IP代理,假装是消费者用户,去绕开IP校验。像Amazon、Expedia这些网站一般都说,如果是商用的IP,我不会让你进去。
泓君:商家会屏蔽一些AI机器人,不希望它们接入。
朱哲清:奢侈品网站很早以前就会都屏蔽掉。如果用的你们家的网,就是你自己的IP,那就不会再被block了。所以这个有可能会是未来一个破局的趋势,而这件事情有可能会推动很多的app厂商去改变他们的Browser Use机制,也就是说这个browser sandbox(浏览器沙箱)可能是在本地发生,而不是在云端发生。
泓君:你这个观察非常有意思,最近非常火的一个toC的消费级应用,就是Meta Muse,他们的定位是做一个个人的AI助手,它相当于给每个人做了一台云端的虚拟机,你的数据是存在一个在云端属于你的存储里的。根据你刚刚的理论,它其实还是商用的一个IP。它如果未来商业化的话,很有可能是会被商家卡住它这个IP的。
朱哲清:Meta Muse从背后的虚拟机设置来说,其实跟当时的Manus是很像的,它也主打一个Browser Use,因为它很多的使用场景跟旅行和购物有关,在这些use case之下,你是没有办法通过API的调用,来完成这个任务的,基本上都得最后靠浏览器。当时Manus其实走了一模一样的路,被全部block掉了,所以Manus到后期的时候,现在跟Genspark很像,都主打白领工作那一套。
你去看Claude Code、Claude Cowork、ChatGPT Work,最后都往白领工作效率这方面去偏移,核心原因就是因为很多东西一开始能做,但后面很快就被巨头们给全部block掉了。
泓君:比如说亚马逊现在就把Meta Muse给屏蔽掉了,如果有更多的网站去加入进来,它可能能访问的网页跟能操作的东西就越少。
朱哲清:但是他不可能把你电脑上的IP给屏蔽掉,那你自己也上不了亚马逊了,所以这个可能会是一个破局的机会。但是我怀疑这个事情会来回拉扯,在C端的这个agent,目前可能还是不是特别ready。因为做Browser Use,对模型的需求其实挺高的。它很难在短期内拉出一个现象级的体量。
泓君:那你会看好像Meta Muse长远的一个发展吗?
朱哲清:我觉得这波消费者最后一定会land到软硬件结合的状态。我觉得Meta如果能够把wearable(可穿戴设备)做很大,有可能有机会。就是为什么我觉得最后要land到软硬件结合的原因,是因为云端这件事情不能代表这个用户本身,这也是为什么browser把他们给完全block掉的原因,因为一旦换了个云端的虚拟机,它不能够验证说这个人本身就是用户本身。
我觉得用户的ID或者使用agent的那个用户的identity(身份)本身会是这一波toC的一个关键。如果说商家能够去确认这个agent就代表这一个人去做的这么一个操作。有可能很多商家会愿意做这件事情。
但是现在如果用云端的虚拟机,云端的browser,他很有可能是没有办法去验证这件事情,他会觉得说我的流量入口被人剥夺了。比如说我有一个用户,他本来就要访问我,他现在通过agent还是访问我,那其实对于我来说可能是OK的。但如果说原本一个用户,现在搞了20个agent,这20个agent的消费能力跟原来是一样的,这20个agent还不停地比价,不停地在我这边刷流量,把我这边的所有的流量全都弄乱了,对我来说是得不偿失的。
所以我觉得软硬件结合可能会是一个机会,如果说这个硬件本身属于这个用户,他就可以直接确认说这个agent就是这个用户,是一个代表行为,我就会愿意把这个access开给你。
泓君:大家在toB的工作流中会用xAI的Grok Bot吗?
朱哲清:我自己身边用Grok Bot的人更多是在尝鲜,因为它相对比较主动一点。但是你用Codex或者用Claude Code,其实都可以解决这些问题。就真的把它接进工作流的,可能相对少一些。我自己身边好多真正在B端,比如法律、医疗,真正在那些传统的企业里面在工作的人,现在还纠结于怎么能够逃出Microsoft Copilot的泥潭。甚至都不能freely使用Codex和Claude Code,就更别说要到Grok Bot这个级别了。所以我觉得整个行业现在分差非常大,走在前面的人什么都可以随便用,走在后面的人现在还在泥潭里挣扎。
泓君:我最近跟比较前沿的模型的研究员聊啊,听到一个很有意思的观点,他们认为现在在toC跟消费级的agent上,token的使用量其实是花不了多少钱的。现在真正最烧钱的地方,是在OpenAI、Anthropic、DeepMind这几家公司在竞争的核心领域——AI for Science。就是那些未被解决、未被定义的科学问题,他们要去解那些数学题,或者需要跑像王教授这样的一些生物实验,这个是非常非常烧token,而且是内部消耗量最大的一个方向。
那比如说,OpenAI解纳维-斯托克斯方程这一个问题,它内部调用了一个更强的模型,大概用了1万个子agent,发了大概有270万条信息,消耗了约1300亿输出的token。第三方按照零售价给它算了一下,这部分消耗大概是在2200万美元。
因为现在整个模型的进化,我觉得这个对普通人的感知来说已经不大了。但是对前沿的科学家来说,他们对模型能力的提升,感知是非常大的。
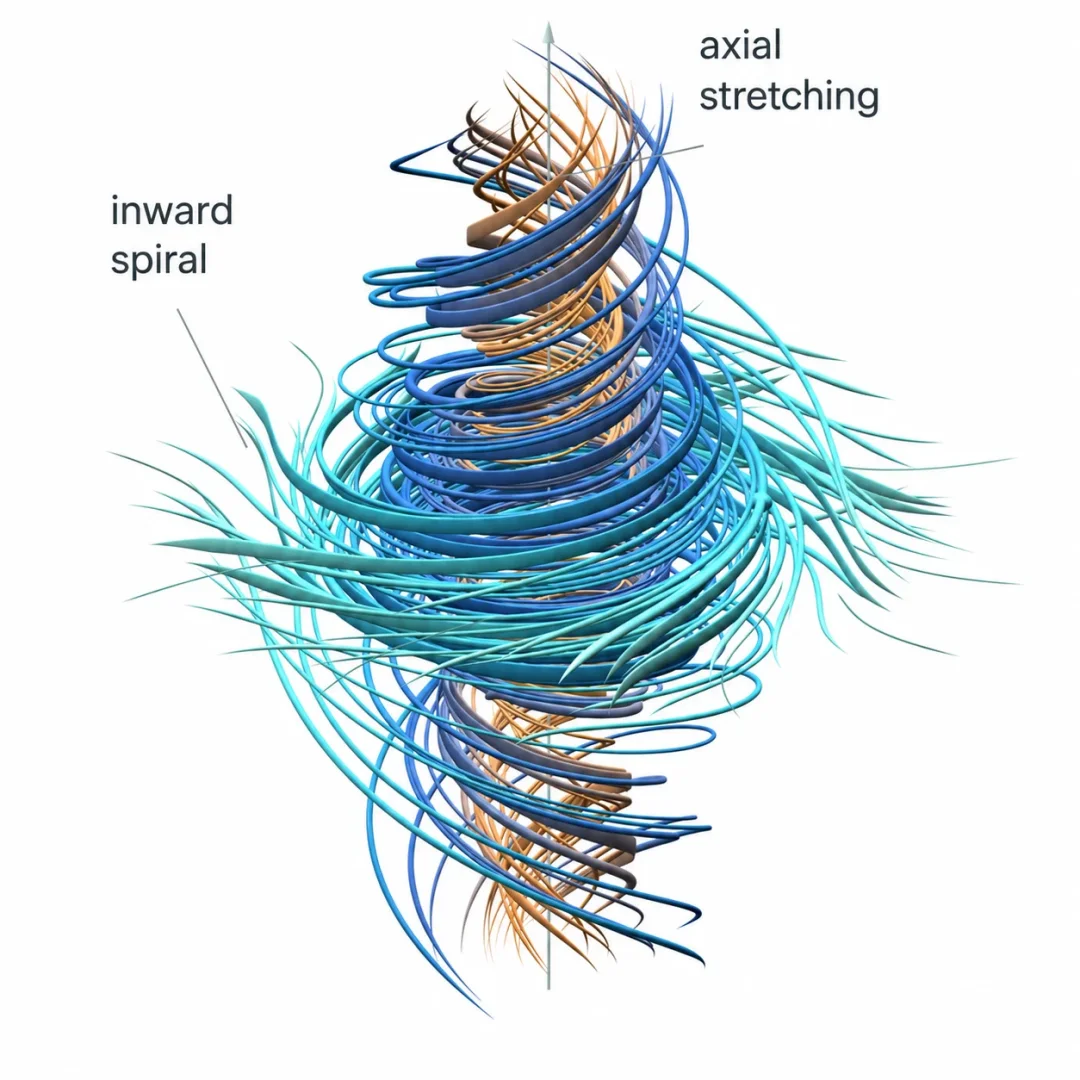
OpenAI宣布解决了纳维–斯托克斯千禧年大奖难题,该解是一个涡旋。图片来源:OpenAI
朱哲清:这个地方有点想问许教授跟王教授。我自己主要做post training(后训练),focus on小模型多一些,因为我们想做本地私有化的模型。我们能看到的就是,这个层次的模型,在我们优化之后,和frontier model的差距越来越小。
从AI for Science角度,或者说从robotics角度,frontier model在每一代的迭代当中,你们觉得会有多大的提升?
比如说我们从Opus 4.5到4.6的区别,对比4.8到Fable之间的区别,或者说5.6到Astra之间的区别,这个差距可比吗?
王晟:我的观点是,在生物医学领域,它的AI for Science能力确实是有一个很大的提升。但是这个提升主要来自于它的coding能力,这种一般的coding查文献,做长程任务的能力,并不是它对这种生物医学知识能力的提升。有一些benchmark是专门测Biomedical knowledge知识层面的,Astra并没有提升。
我们现在实际用的时候,其实很难去使用Astra,或者Opus、Fable,因为它们对生物医学的任务都会防范的越来越严,它都会refuse to answer,这个是非常严重的问题。所以我们其实内部用的时候都是用Kimi K3或者Muse Spark 1.3。当如果要用Astra的时候,都要用一些比较特殊的方式来跟Astra说,我这不是在做一个危险的任务,我只是在设计一个benchmark等等。所以实际这种大模型的使用体验,随着能力的增强,其实是越来越差的。
还有一个点就是,刚才Bill说的很有道理,其实我也认可,就在各种已经定义的很明确的AI for Science benchmark上,小模型确实是可以和大模型的差距越来越小。但是我个人觉得这些benchmark本身就不是定义的那么好,所以大家追赶的方向,包括大模型进步的方向,都可能不是完全正确的。
这些benchmark定义的时候,大家都会定义一个更好