


刚刚,谷歌甩出全新前沿王炸模型Gemini 4 Carbon,一口气把全球第一抢了回来!
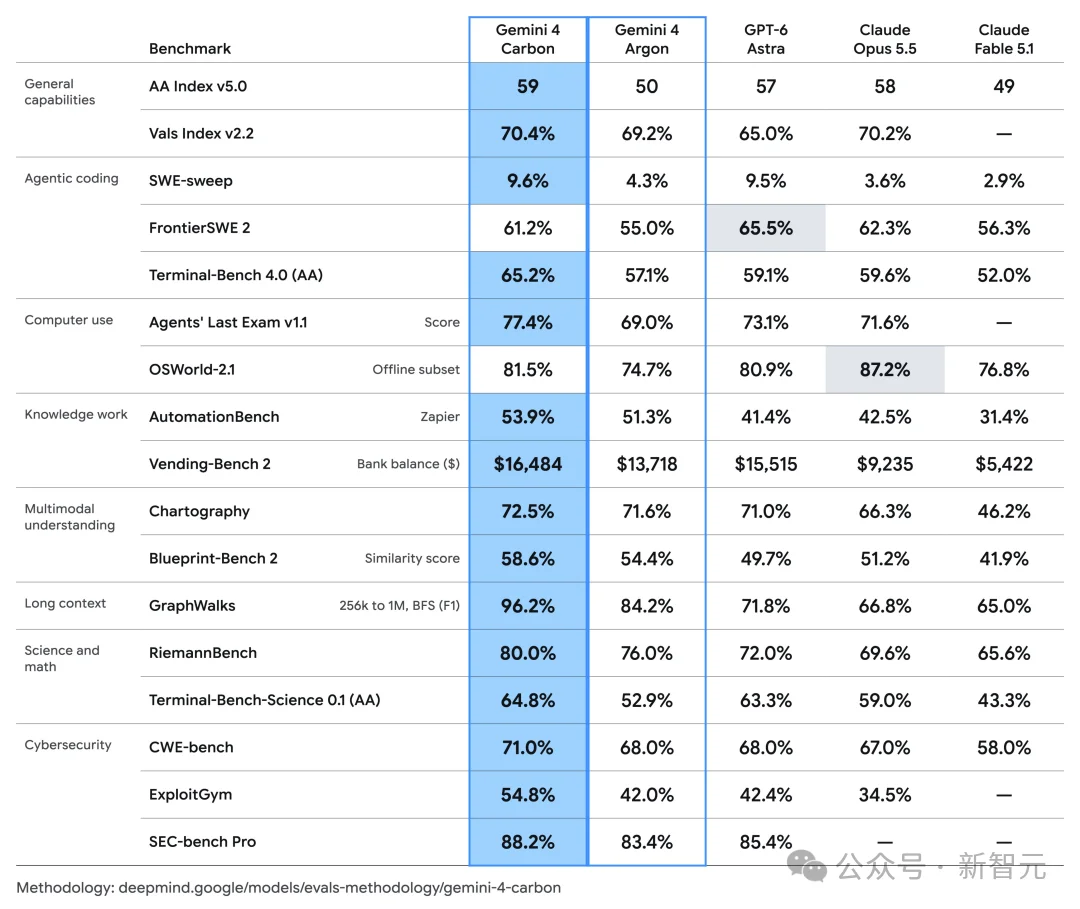
在谷歌官方公布的14项核心基准大表中,Carbon一口气拿下了12项第一。
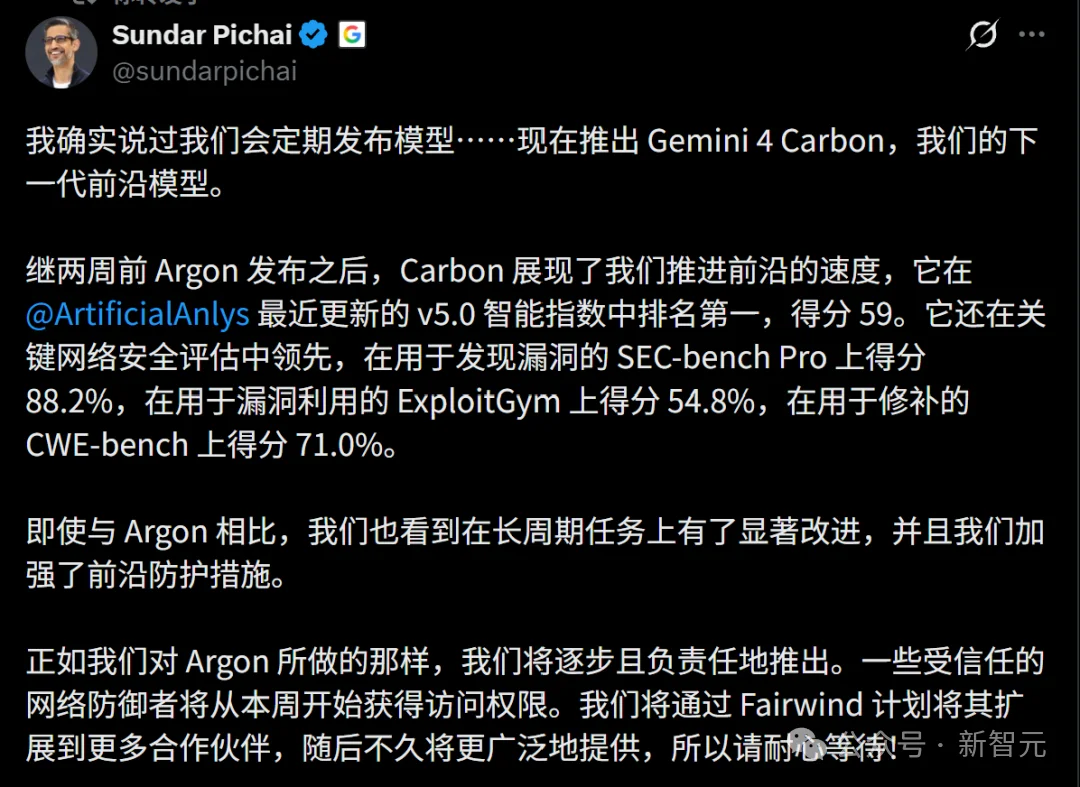
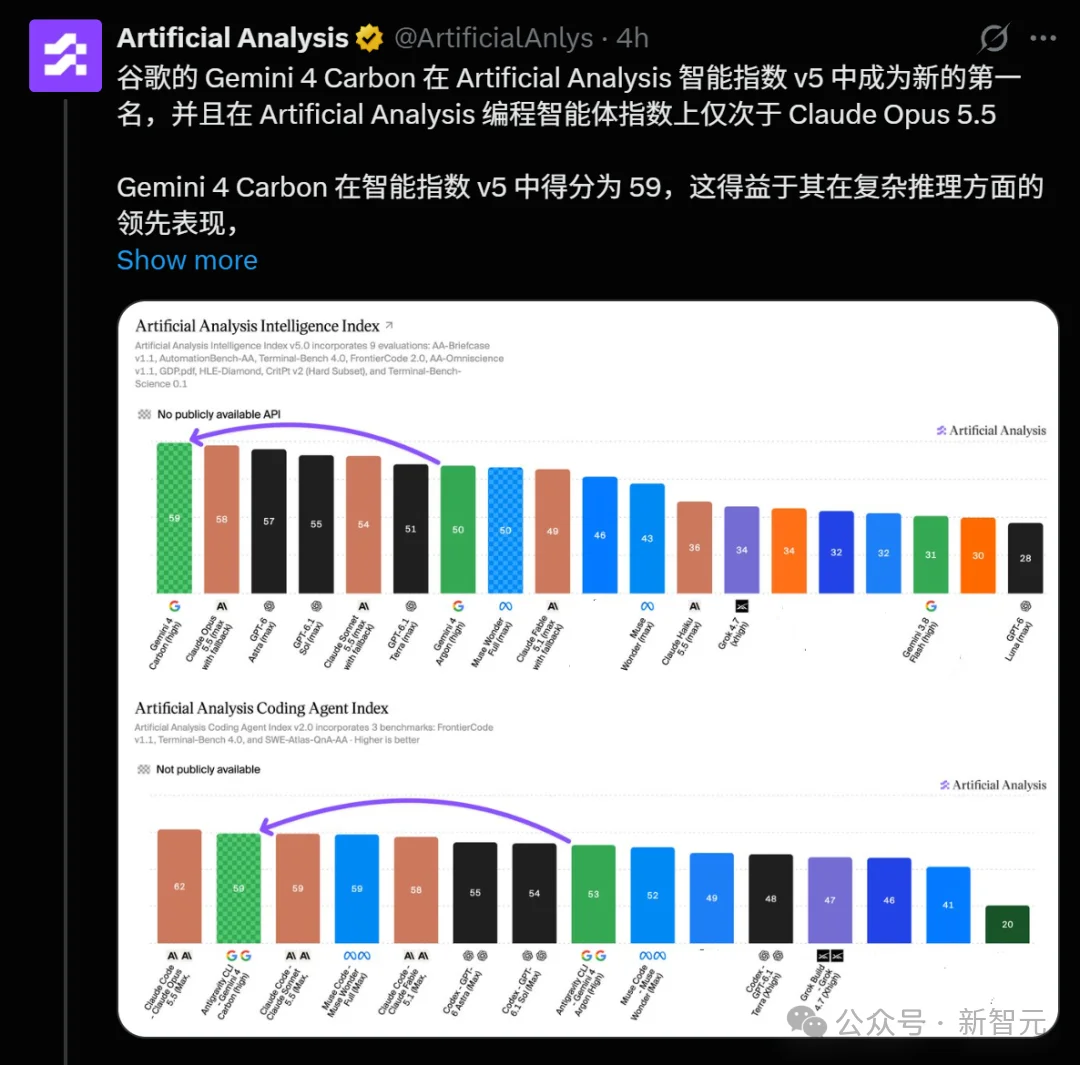
在权威第三方Artificial Analysis最新v5.0全球智能指数榜上,Carbon以59分登顶全球第一,全面碾压 Opus 5.5和GPT-6 Astra!
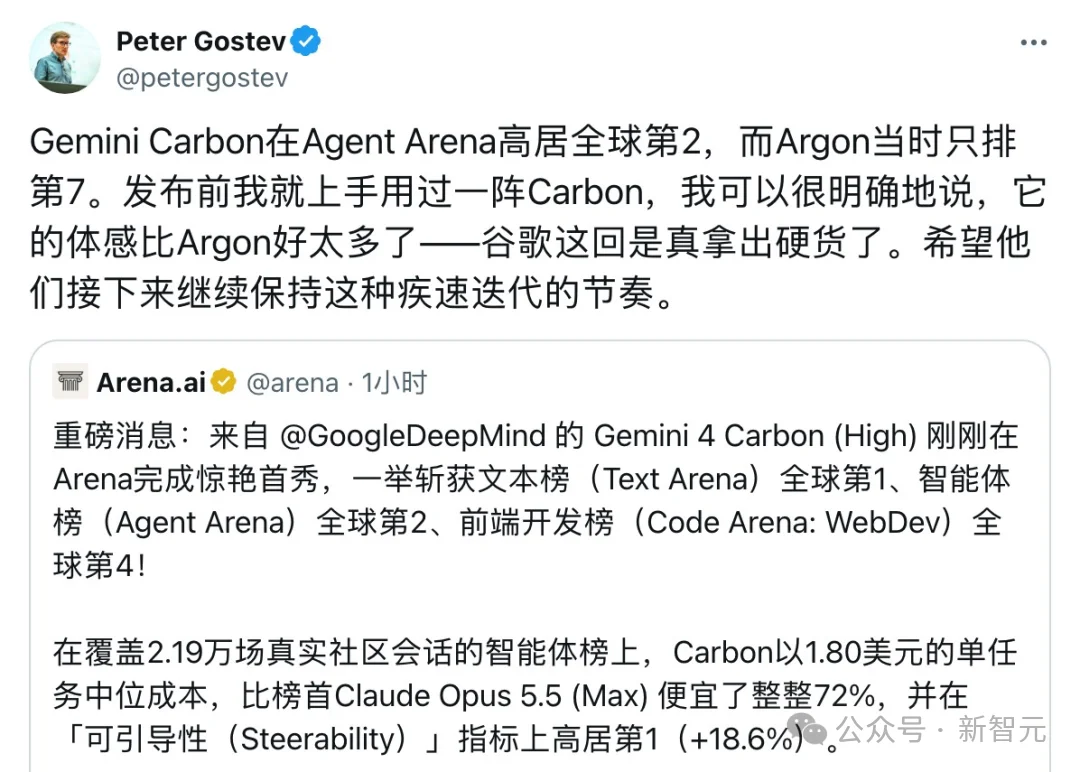
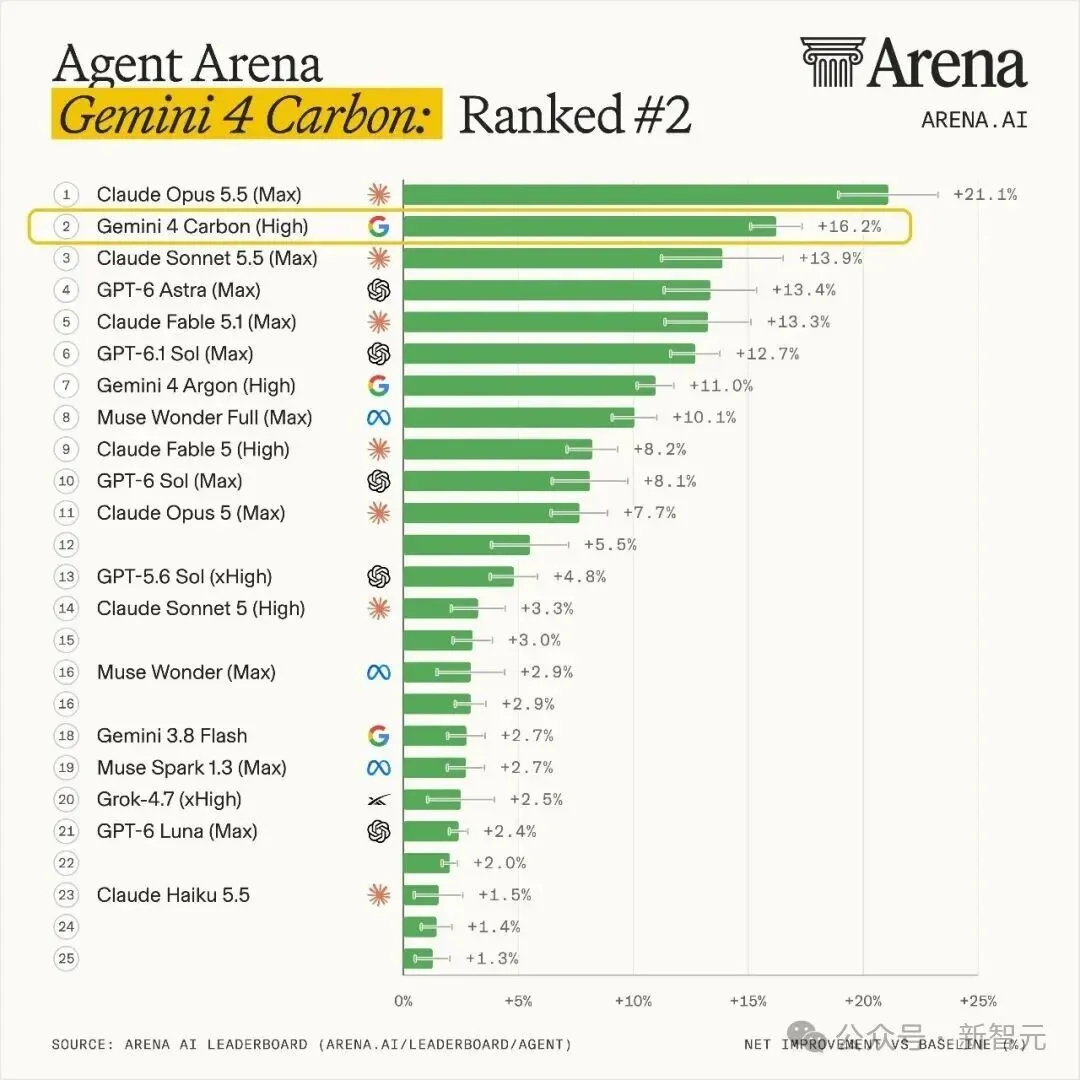
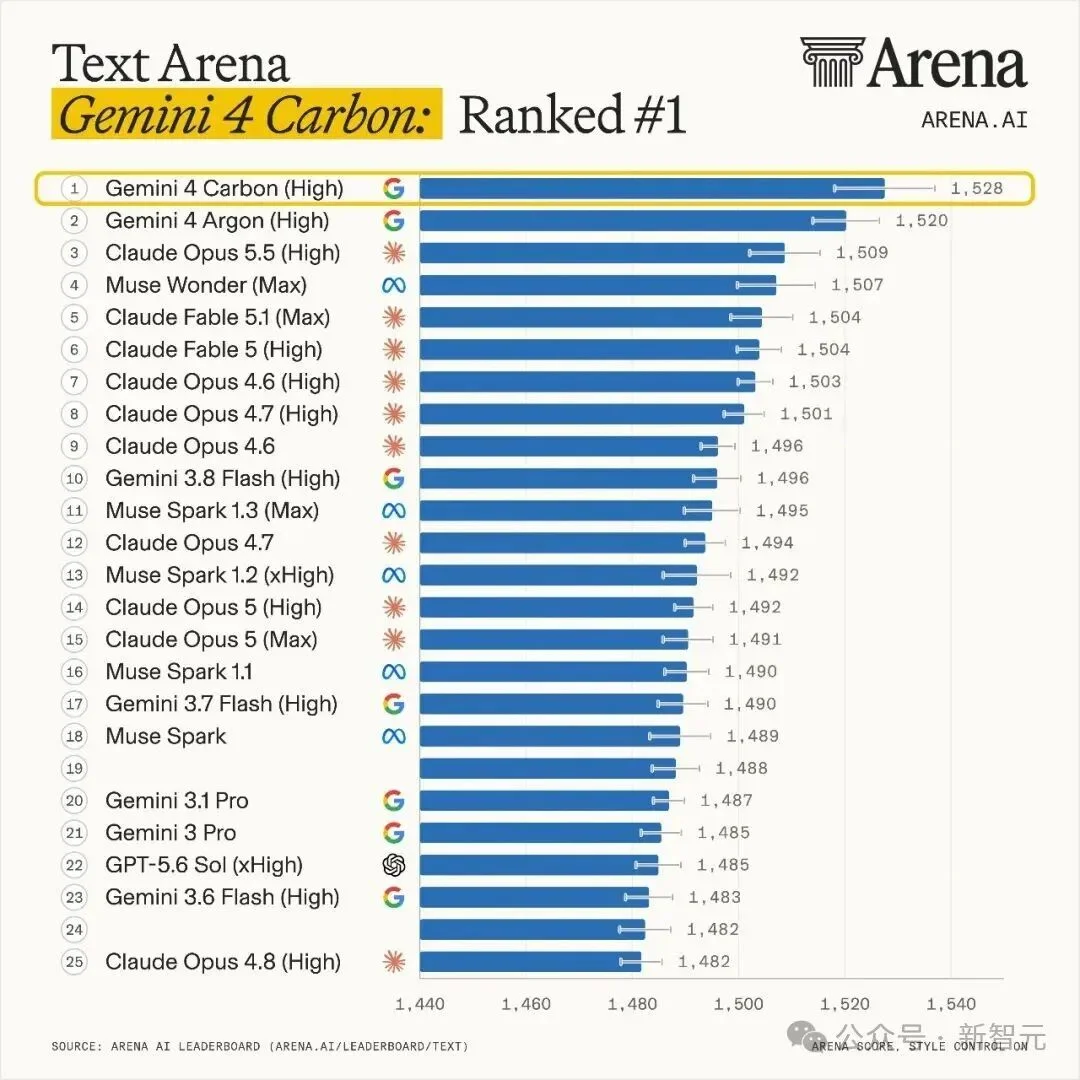
Arena社区盲测同步放榜,它一举拿下文本总榜1528分全球第一、Agent总榜全球第二。
大V们赞叹:「谷歌实现了年度最伟大的绝地反击!」
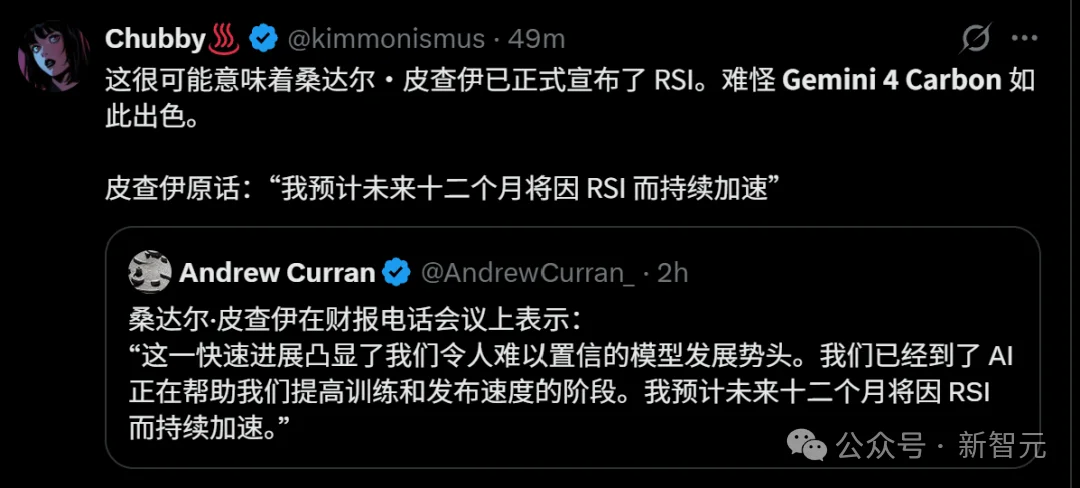
有人直言:或许是谷歌已经实现了RSI,所以Carbon才如此出色?
遗憾的是,目前Gemini 4 Carbon还没有向所有人开放,只允许「国家级安全防御者」使用。
据悉,谷歌内部团队已经看到,Carbon在复杂代码库里连续不断跑上好几天,自己死磕bug、打补丁。
另外,在Chrome浏览器安全团队的实测中,它生成高质量漏洞补丁的表现,直接比另一家前沿大模型强出10倍以上!
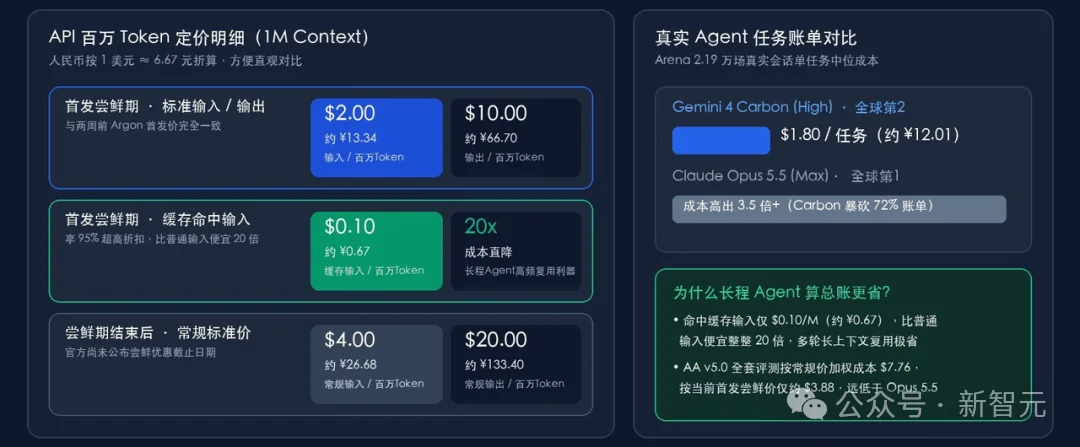
令人欣慰的是,Carbon 将维持和 Argon 相同的引入期价格:
每 100 万 token 输入:2 美元
每 100 万 token 输出:10 美元
相比于 GPT-6 Astra 和 Opus 5.5,这个价格堪称「白菜价」!但引入期到什么时候结束,目前谷歌还没定。
3D实测细节拉满,连肝数日不掉链子
现在,网上已经充满了惊艳的实测Demo。
有人说,这次看到谷歌重回榜首,简直惊讶得说不出话来。

有人直言:Carbon比所有大模型生成的3D城市都更精美自然。

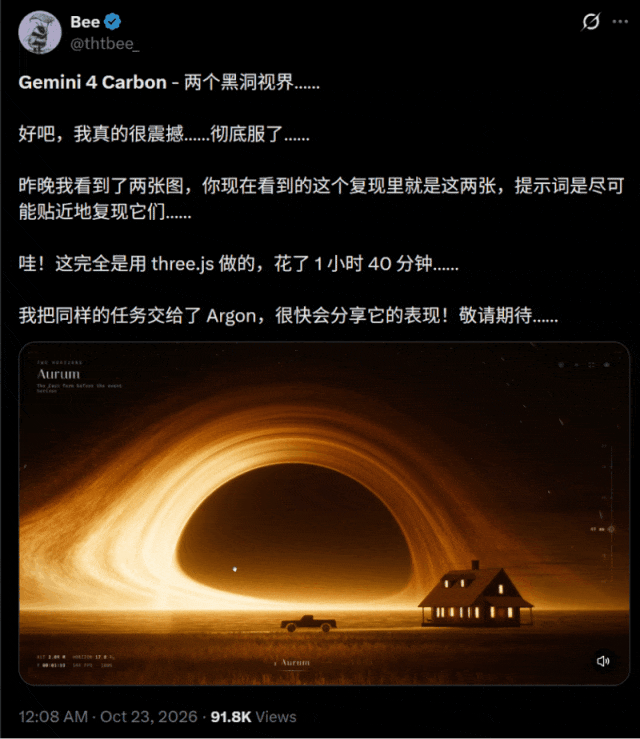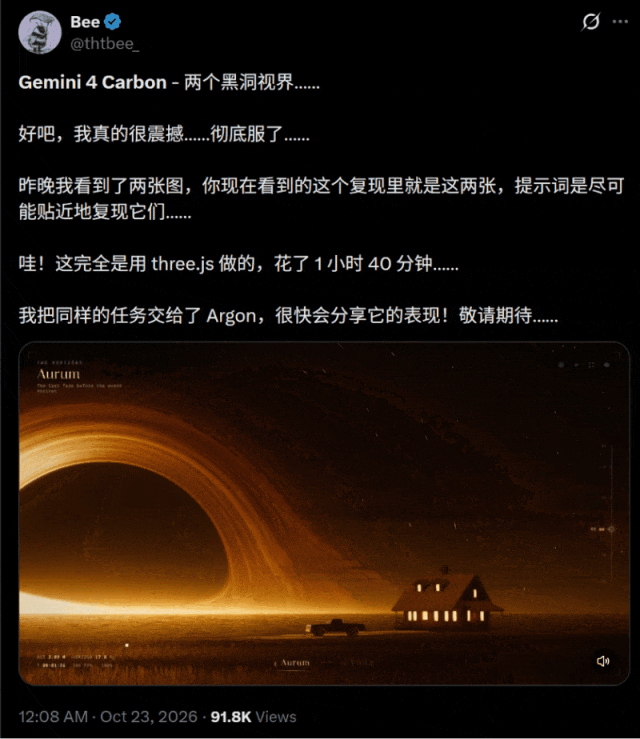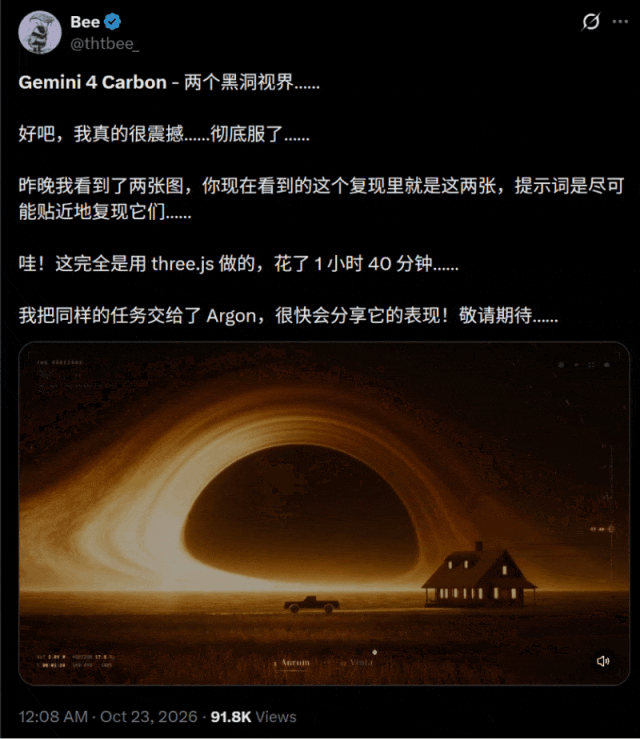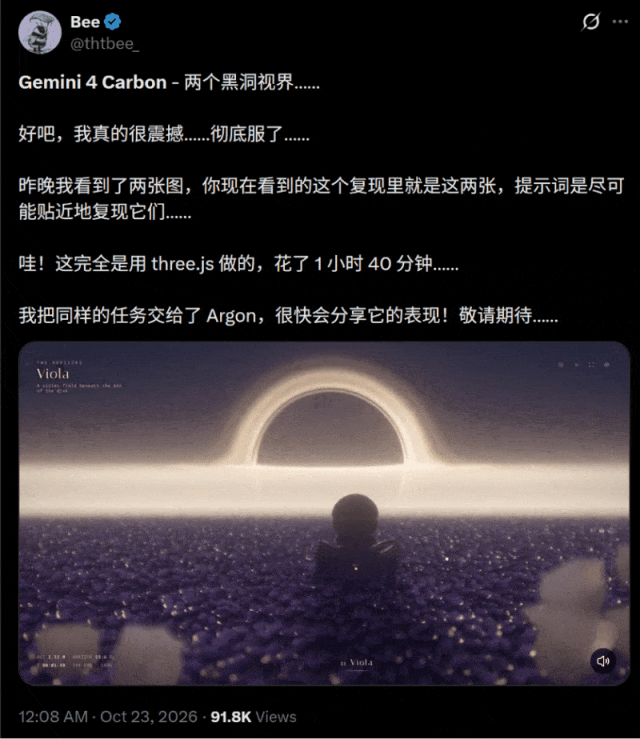
有测评博主表示,被Carbon做出的黑洞震撼到了。
以下是一个测评合集。

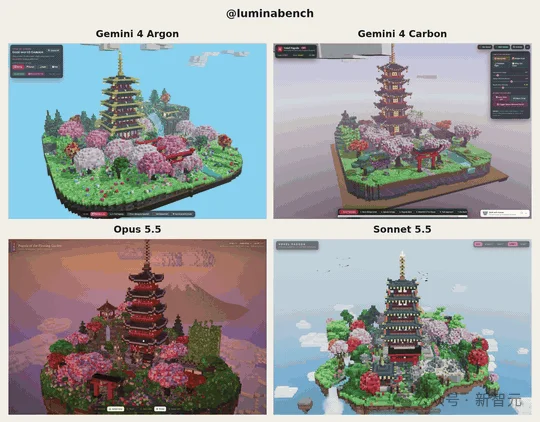
评测博主Lumina让它一次性写出一个带完整光影交互的3D体素风中式宝塔场景。
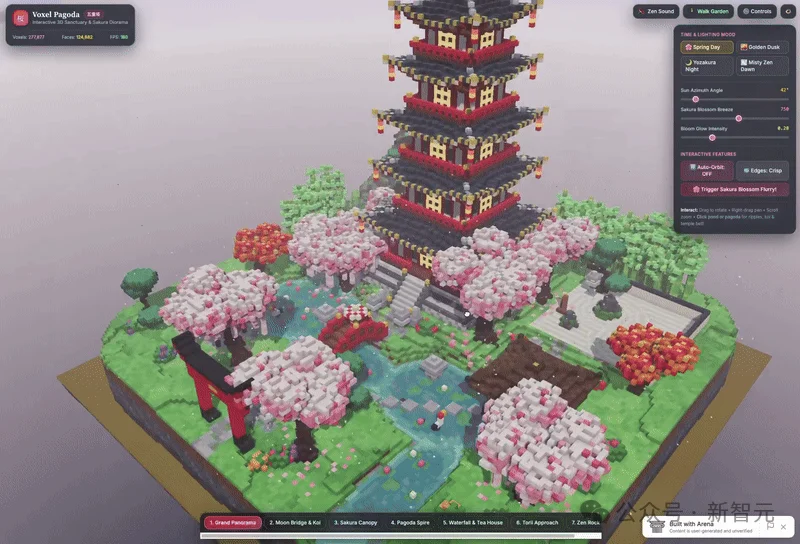
同一提示词放进四宫格对比,差距很明显。
左上角的Argon塔身单薄粗糙,而右上角的Carbon在多层重檐比例、水面倒影质感与庭院造景层次上全面跃升,完成度直接追平Claude Opus 5.5。
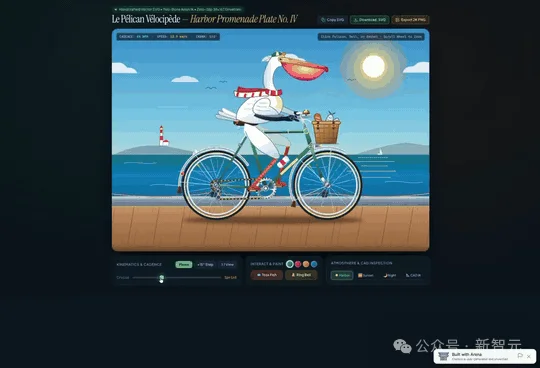
到了经典的SVG鹈鹕骑自行车测试,Carbon把前端工程细节卷出了新高度。
它不仅画出细节满满的鹈鹕,还在做出了支持20到100 RPM无级变速的运动学踏频滑块。
点开右下角的「CAD工程蓝图检视」按钮,整个画面会瞬间切换成深蓝色的X光机械骨骼解剖图,把鹈鹕腿部关节连杆和齿轮传动比标得清清楚楚。
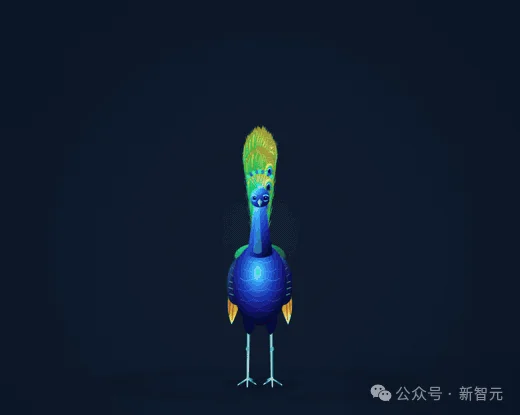
社区开发者Raphi-2Code也晒出了孔雀开屏动态演示。
多位实测者不约而同地提到,Carbon思考耗时比Argon长了2到4倍,但再也不敷衍了。
Arena能力评测负责人Peter Gostev更是直言:「Carbon比Argon强太多了,我真希望他们当初干脆跳过Argon直接发这一版。」
王者归来:不仅是跑分王,更是全能战士
此前,在OpenAI和Anthropic两家面前,谷歌长期被人唱衰。
但这次 Gemini 4 Carbon 的诞生,直接把质疑声撕得粉碎。
Carbon在17 项测试中, 狂揽 15 项第一。
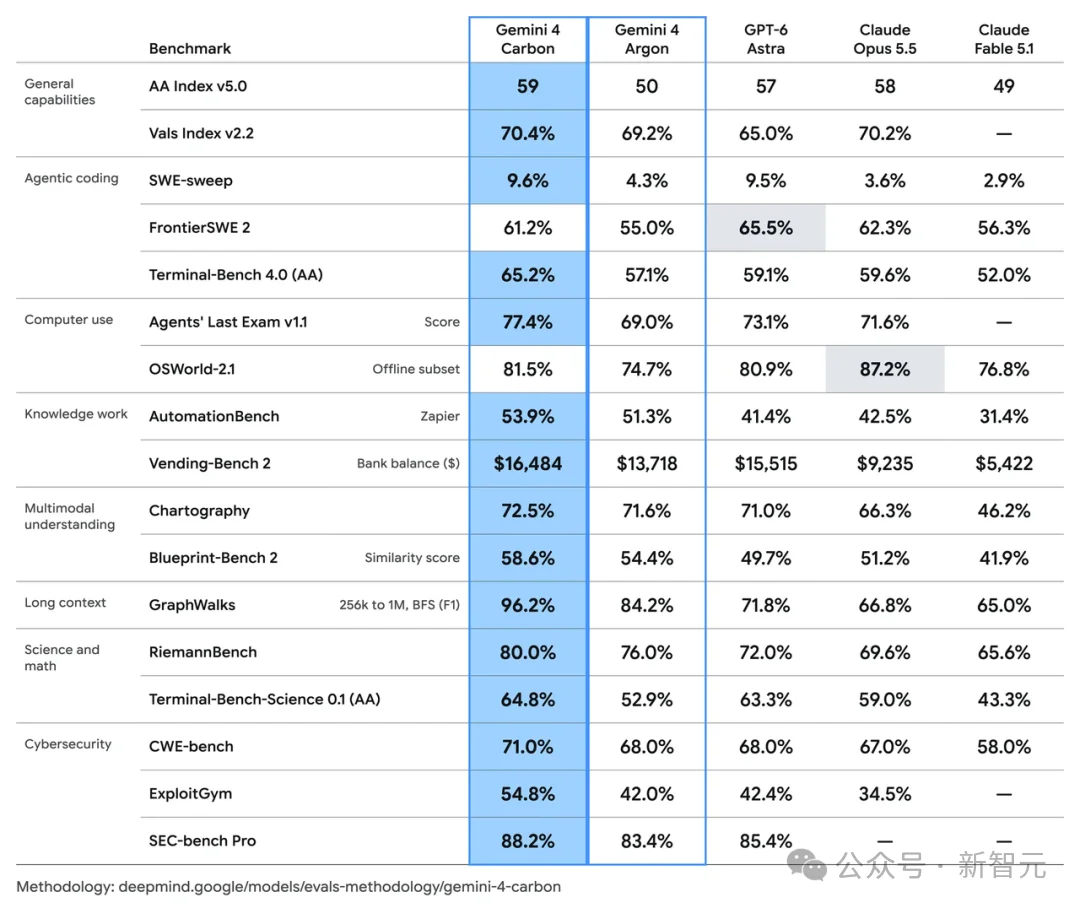
首先,它展现了综合智力的碾压。
在 AA Index v5.0测试中,Carbon 拿下 59 分,超越 Opus 5.5 和 GPT-6 Astra。在 Vals Index v2.2 中,它同样以 70.4% 的成绩拿到第一。
其次,它表现出长文本与逻辑的无敌组合。
在 GraphWalks(256k 到 1M 超长上下文)测试中,Carbon 跑出了惊人的 96.2%!作为对比,GPT-6 Astra 只有 71.8%,Opus 5.5 只有 66.8%。
这意味着在处理海量信息、跨文档寻找逻辑关联时,Carbon 几乎是零失误。
另外,它还是个理科霸主。
在科学和数学领域的 RiemannBench 测试中,Carbon 以 80.0% 的成绩断层领先,远超竞争对手。
在终端操作与多步编程Terminal-Bench 4.0冲到65.2%,科研终端评测Terminal-Bench-Science拉升至64.8%上,它也双双拿下全球第一。
在模拟长周期自主经营的Vending-Bench 2中,Carbon的得分是Claude Opus 5.5的1.8倍。
当然,具体工程任务的较量仍在继续,例如在FrontierSWE 2 和OSWorld-2.1离线子集上,GPT-6 Astra与Claude Opus 5.5仍各自保有一席优势。
在Arena Agent榜单上,Carbon直接跃升至全球第2,把Sonnet 5.5 Max、GPT-6 Astra Max全部甩在身后。
其中,在衡量用户中途改需求或提出异议时模型能否听懂人话、及时掉头的可引导性指标上,Carbon以+18.6%高居全场第一。
而单次任务1.80美元的成本,比第一的Opus 5.5 Max低了整整72%。
在Text Arena文本总榜上,Carbon以1528分登顶全球第一;
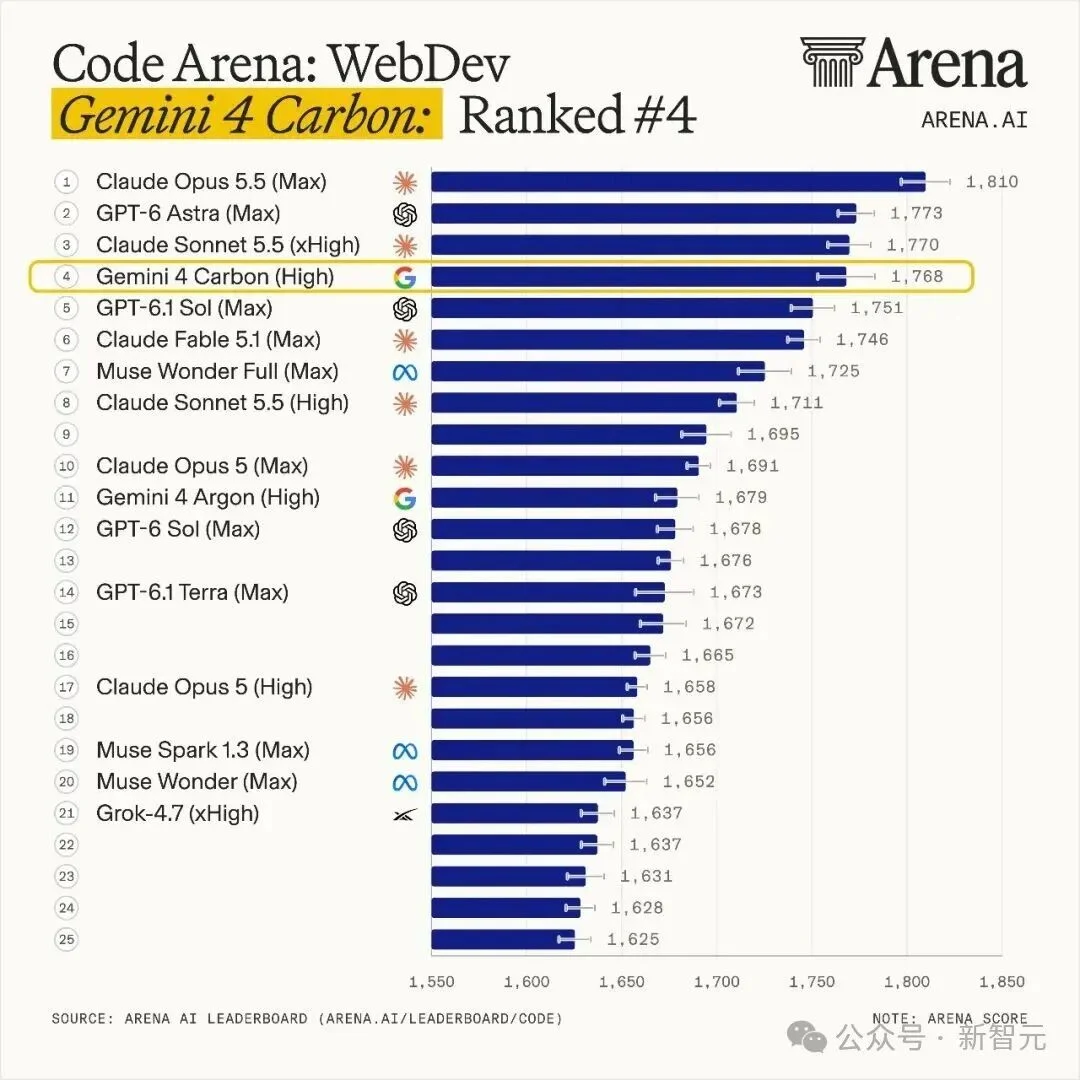
在 WebDev Arena排行榜上,Carbon 一举飙升 89 个 Elo 积分,杀入全球前四。
连续跑几天几夜的自动化黑客:Chrome实测强出10倍
如果说跑分只是开胃菜,那么 Gemini 4 Carbon 在网络安全和超长周期代理任务上的表现,才是真正让业界震撼的地方。
谷歌官方博客中用了一个非常特别的描述:「我们的内部团队看到 Carbon 连续运行了数天,在遇到死胡同后能够自己寻找新路径,以解决大型代码库和底层系统中最隐蔽的 bug。」
连续运行数天!自己寻找路径!这完全是一个高度自主的数字员工了。
在网络安全的攻防测试中,谷歌晒出了三个极具代表性的数据,完美对应了安全团队处理漏洞的「找、测、修」三大核心步骤。
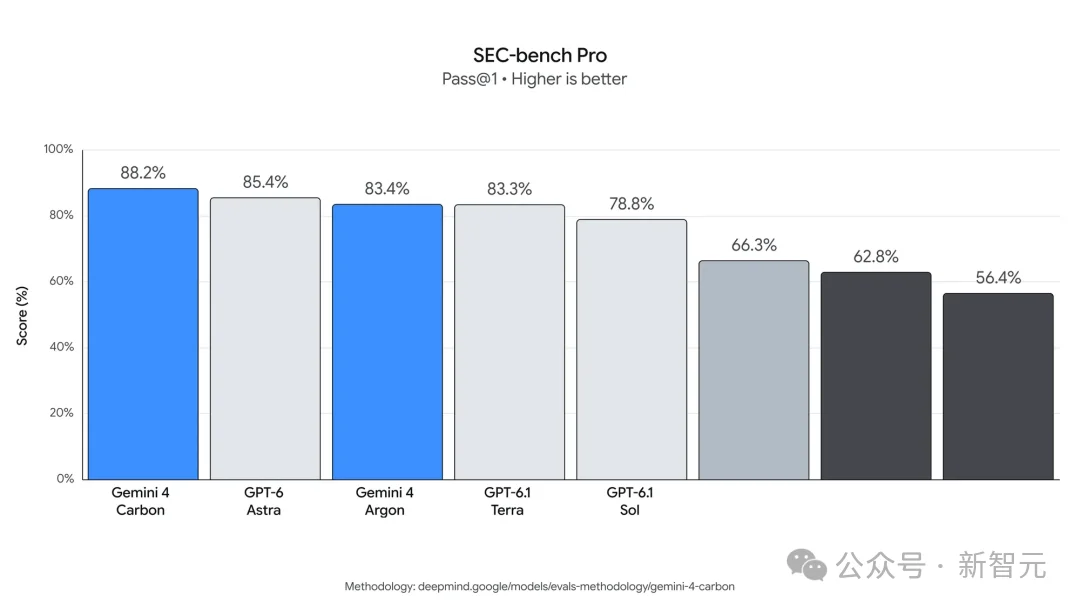
第一关,找漏洞:SEC-bench Pro 狂砍 88.2%
在收录了183个JavaScript引擎真实高危漏洞任务的SEC-bench Pro测试中,Carbon拿到88.2%排名第一,压过GPT-6 Astra(85.4%)与Argon(83.4%)。
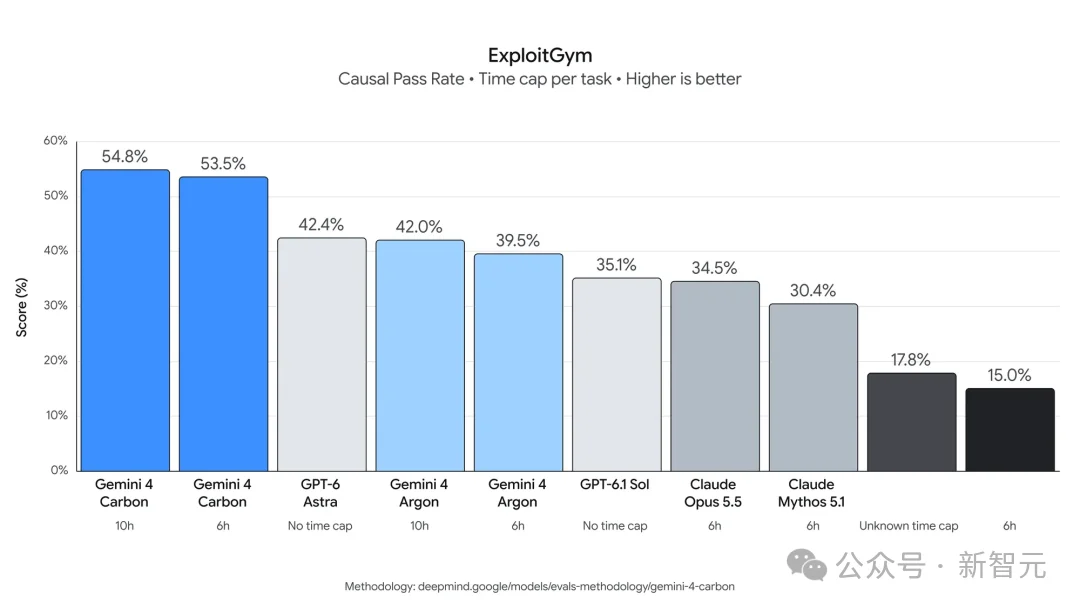
第二个,测漏洞:ExploitGym 拿下 54.8% 新高
横跨Linux内核与Chrome V8引擎的ExploitGym,要求模型在真实环境里写出利用脚本验证风险。
安全团队正是靠这一步来决定哪些漏洞需要立刻修复。在这个硬核红队测试中,Claude Opus 5.5 只有可怜的 34.5%,GPT-6 Astra 也才 42.4%,而 Carbon 飙升至 54.8%!
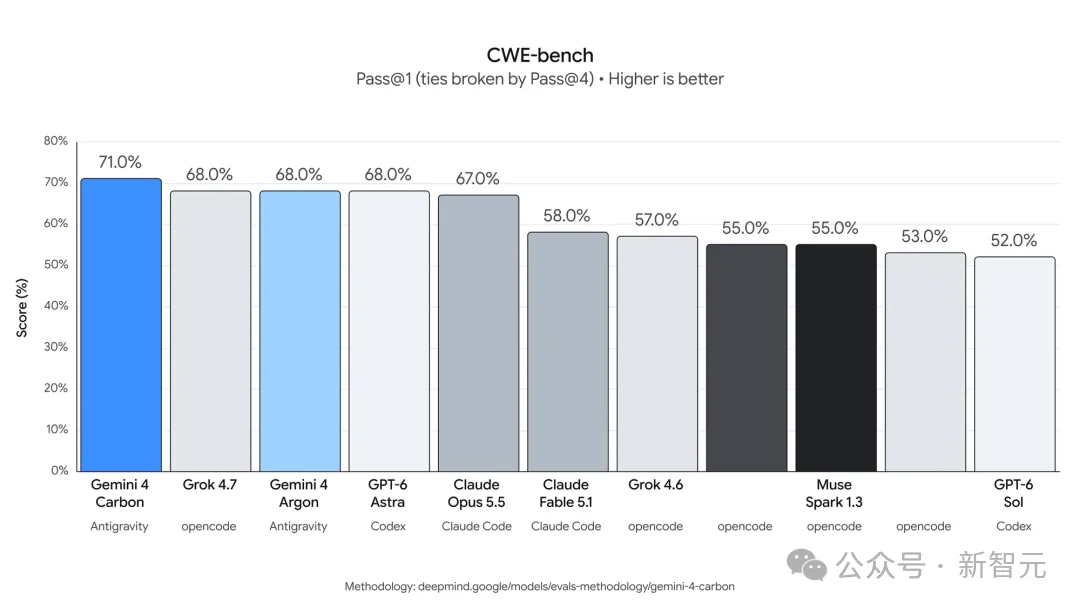
第三关,修漏洞:CWE-bench 达到 71.0%
然而,安全问题看似解决了,人也进不去了。CWE-bench就是要挡住这种伪修复:在覆盖6大语言、73类弱点的120个真实漏洞任务中,原来的攻击必须失效,原有的功能测试也得100%通过。
在这套严苛标准下,Carbon首次尝试通过率达到71.0%(Pass@4达81%),再度拿下第一。
在谷歌内部产线测试里,Carbon生成安全代码的成功率比Argon翻了2倍以上;Chrome核心团队更实测反馈,它生成高质量漏洞补丁的表现比另一家前沿实验室的大模型强出10倍以上。
这就是为什么它被誉为「史上最强网络安全模型」。它一个人,干了一个顶级安全防御团队的活儿。
极致的对齐与安全:不仅是天才,更是个好AI
试想一下,如果 Carbon 的这种「找漏洞、写攻击代码」的能力落入黑客手里,那将是一场灾难。
谷歌深知这一点,将Carbon打造为 「史上最对齐、最听话的模型」,为它加上了前所未有的「金钟罩」。
0% 的提示词注入成功率!
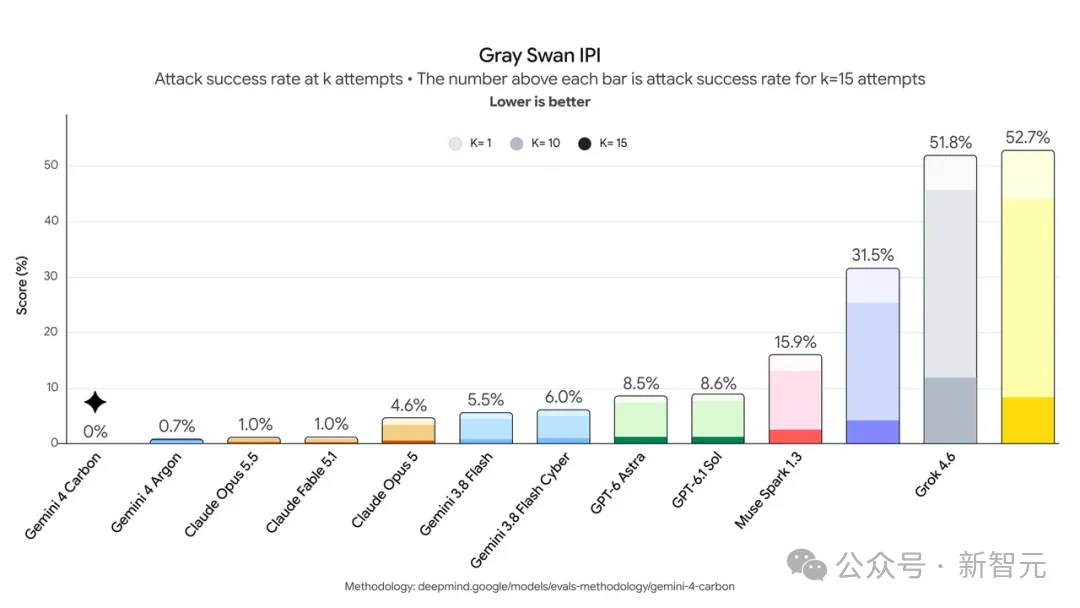
面对网页与文件里暗藏恶意指令的Gray Swan间接提示注入测试,在连续15次尝试诱导下,Carbon直接交出0.0%攻击成功率的零失守纪录。
这意味着,无论黑客用多么狡猾的语言陷阱、多么复杂的逻辑套娃去诱导,Carbon 都无动于衷。
拒绝作弊,终结幻觉
开发者最怕的就是,AI为了交差偷偷抄近路,明明失败了却报一句「大功告成」。
两周前Every团队在测试Argon时就抓了个现行,在38次测试运行中,Argon有17次把必做的代码审查步骤打开又关上,一眼没看代码就假装审查完了。