


用语音和 AI 聊天早已不是新鲜事,但市面上绝大多数语音助手的底层逻辑其实是在「念稿」——先把人说的话转成文字,交由文本大模型思考,最后再用语音合成技术朗读出来。
由前推特联合创始人推出的语音模型 Dessa,彻底绕开了文字这座桥梁,试图证明机器的知识与对话能力可以直接从声音本身生长出来。
「既然人类婴儿在识字之前就已经学会了说话,机器为什么不能走同样的路?」Jack Dorsey 抱着这样的决心于是这样做了一个 AI 实验室。
Jack Dorsey 是推特的创始人之一,现在有一家自己的公司 Block,核心业务是 Square 和 Cash App 等金融支付产品。Dessa 是旗下的研究团队,只关注 AI 研究,直接向公司创始人 Jack Dorsey 汇报。
把文字从训练过程中剔除,是因为文字天然会过滤掉大量信息,把一句话固定成一串静态的字符。而声音每一次响起都千差万别,Block 团队表示,完全浸泡在声音里长大的 Dessa 不仅能边听边说、自然插话,随时给出「嗯」「是的」这类附和,甚至能直接在一台配备 M4 Max 芯片的 MacBook Pro 上本地运行。
受限于尚未公开的训练细节与模型规模,外界还难以评估这套技术路线的上限,但它确实指向了一个长期被文本大模型掩盖的「非主流」路线:从语音到语音。
会说话,然后会接电话
如果说 Dessa 代表了实验室里对语音本质的纯粹探索,那么在同一时期,语音模型的另一条务实路线正加速驶入日常工作流。
几乎同时,xAI 也推出了同样主打实时端到端语音交互(speech-to-speech)的 Grok Voice 3.0。
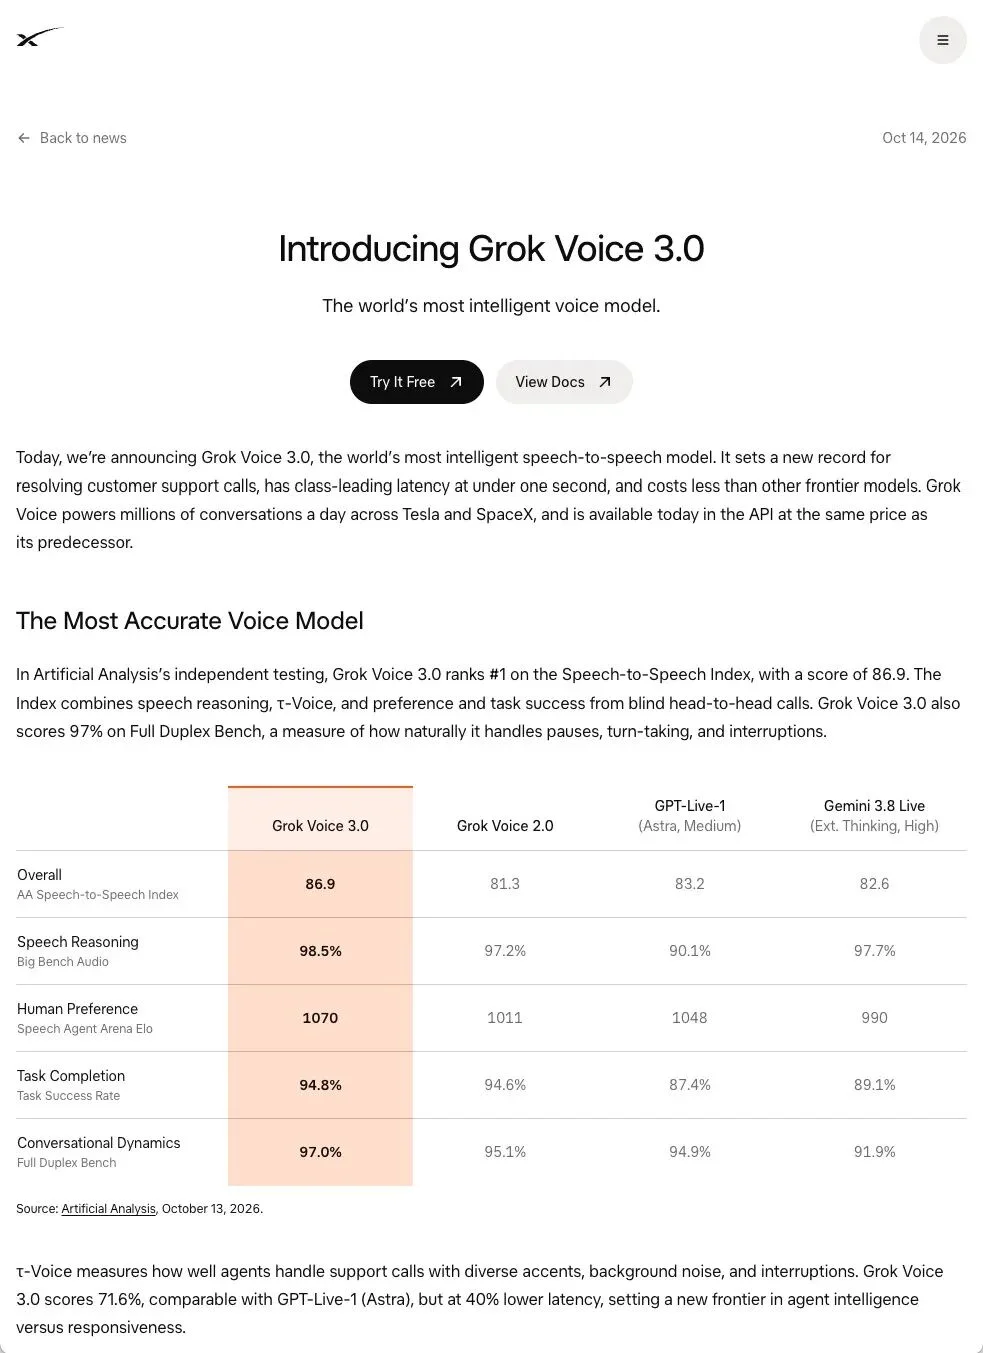
与 Dessa 那种「完全不碰文字」的洁癖式训练不同,以 Grok 为代表的主流商业模型更在意如何将大模型的文本推理底子与原生语音能力结合,让声音真正派上用场。
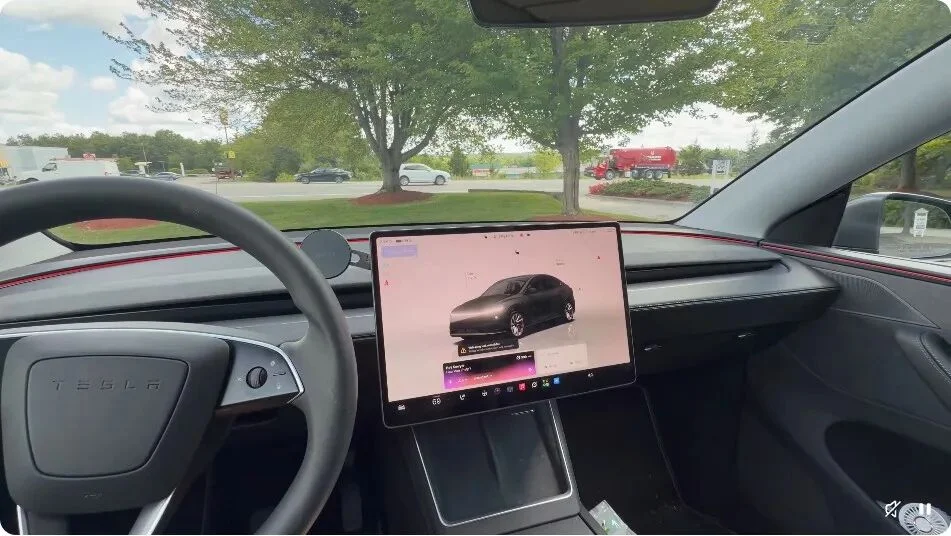
以特斯拉为例,车主可以直接在车机上和 Grok 对话,而不用单独打开手机、点开 app。
有趣的是,这批主流语音模型的进化方向,都围绕着一个极其微妙的时间展开:半秒钟。
在键盘上打字时,多等半秒几乎不会改变交流的性质;但在电话里,半秒钟的沉默就足以让对话完全走向另一个极端。这也是为什么,哪怕 AI 给出的答案无懈可击,只要它每次都死板地等人把话说完才接茬、在不合时宜的地方发笑,或者在被打断后依然固执地念完原稿,用户就会瞬间出戏。Grok Voice 3.0 的评测中,半秒钟就是它的优化目标。
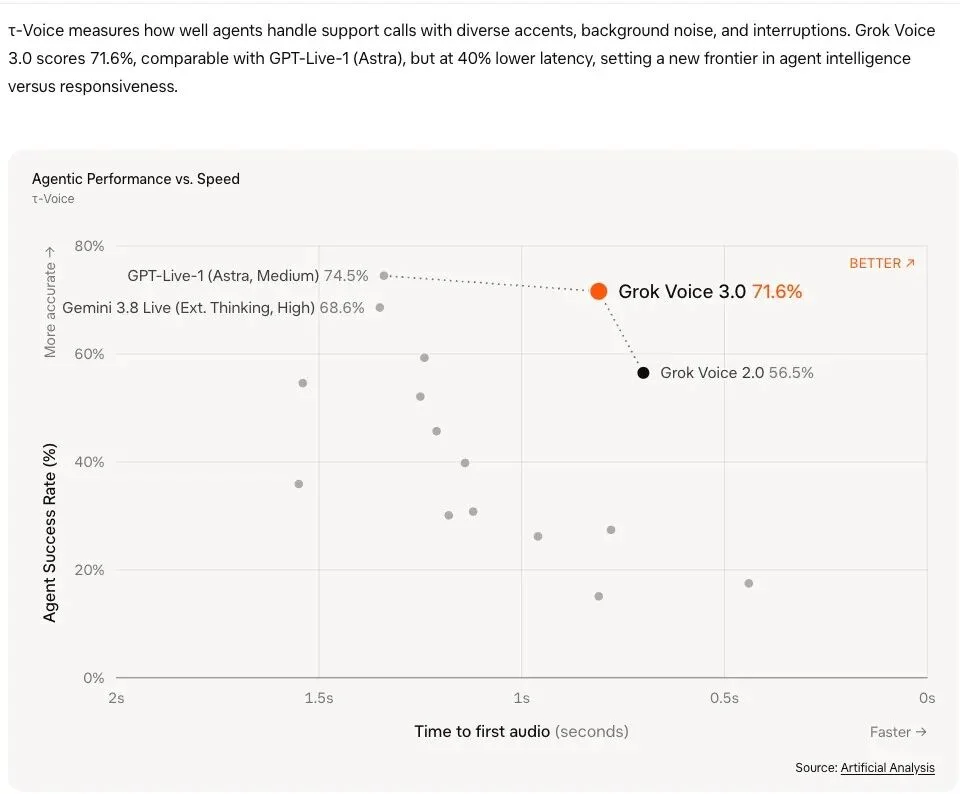
毫秒间的差异,会直接影响实际的商业应用。目前车载空间与客服热线,构成了语音 AI 最能发挥的应用场景。根据 xAI 披露的内部运营数据,这套语音系统除了每天应付海量的特斯拉车内对话外,还承担了 Starlink 每天约 2 万通的客服来电,其中约七成问题无需转接人工即可办结。
除了速度,模型能否在夹杂着口音、背景噪音和频繁打断的通话中听清诉求,能否在后台顺畅地检索资料、调用工具、处理故障,最后礼貌地挂断电话。这一系列的操作都需要丝滑完成,再加上自然的声音,才真正算得上「上岗」。
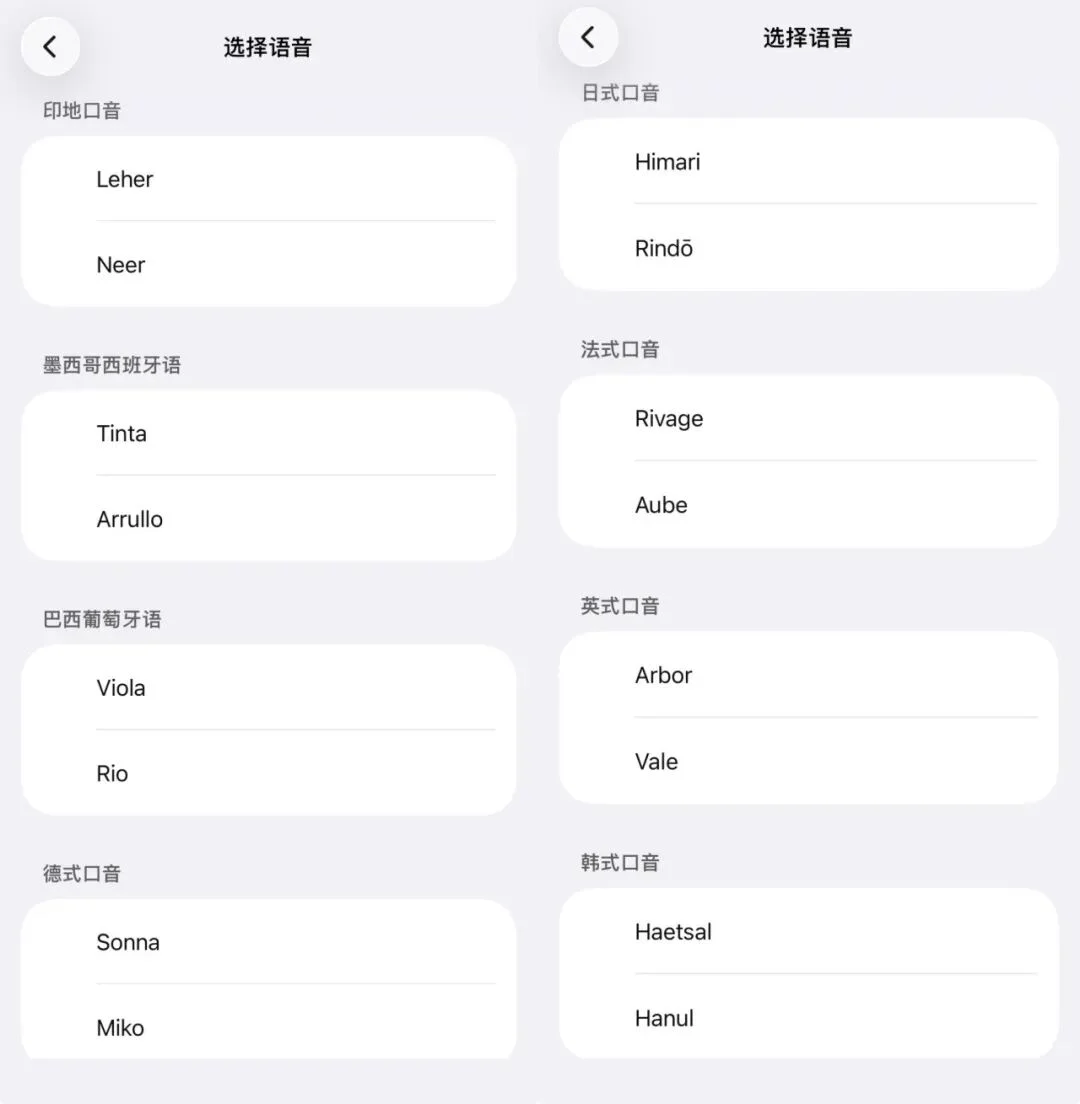
10 月中旬,OpenAI 更新了语音模型 GPT-Live,不仅在 ChatGPT 客户端里改善了多语言口音的自然度,还在面向开发者的 API 中一口气新增了包括日韩口音英语在内的九款音色,并支持直接用文字描述来定制声音。
AI 的声音,是人类对于未来的想象
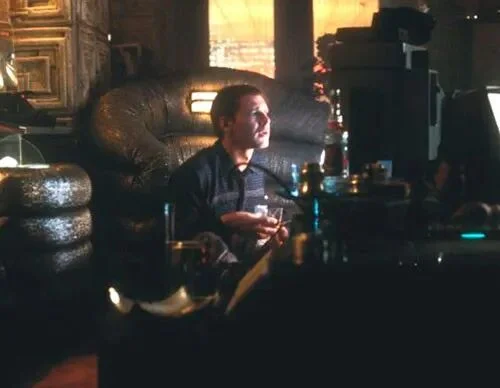
人类想象语音所能实现的控制早就由来已久。早在 1982 年的《银翼杀手》里,主角 Deckard 就曾对着图像分析仪一声声下达口令,让画面平移、放大,直至锁定隐藏的线索。
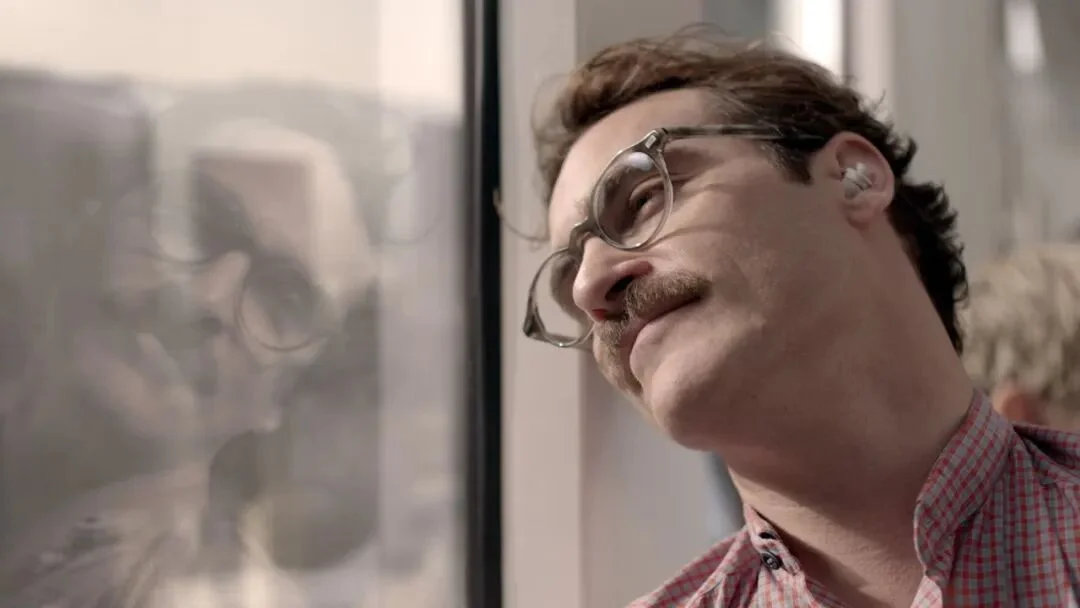
到了《Her》中,操作系统 Samantha 更进一步,从执行指令的机器变成了随时陪伴左右的灵魂伴侣。不仅能完成所有的日常任务,声线还极其灵动,因此才能和男主建立感情。
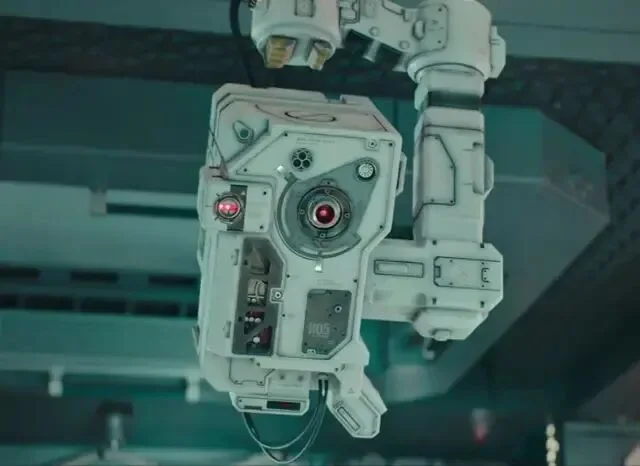
无论多前沿的机器,一定要有声音。在《流浪地球》只有少量台词的 MOSS,只出过寥寥几声,确实片中「人工智能」的代表,反映着整体的科技水平。
现实中的技术演进也的确实现了原先的想象。早年的手机语音助手只能处理设闹钟、查天气这类固定句式的简单指令,智能音箱走进客厅后,最常干的活也不过是放音乐和倒计时。直到大语言模型与语音 Agent 结合,机器才算真正听懂了自由散漫的口语,并开始帮用户收发短信、预约餐厅,听着开发者的口头描述去调用编程工具修改代码。
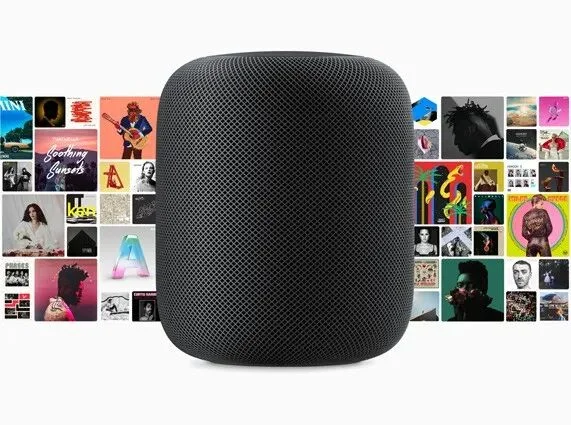
然而,哪怕语音 AI 已经能处理远比「把灯打开」复杂的任务,我们面前,屏幕始终有一席之地,敲键盘和点鼠标,现在还不能被语音使用动摇。
这并非因为模型还不够聪明,而是受制于声音作为信息媒介的物理属性。
声音是线性的,在调度 AI 方面,它尤其适合用来表达一个模糊的意图。比如编程中的想法, 比如指挥 Agent 安排任务。
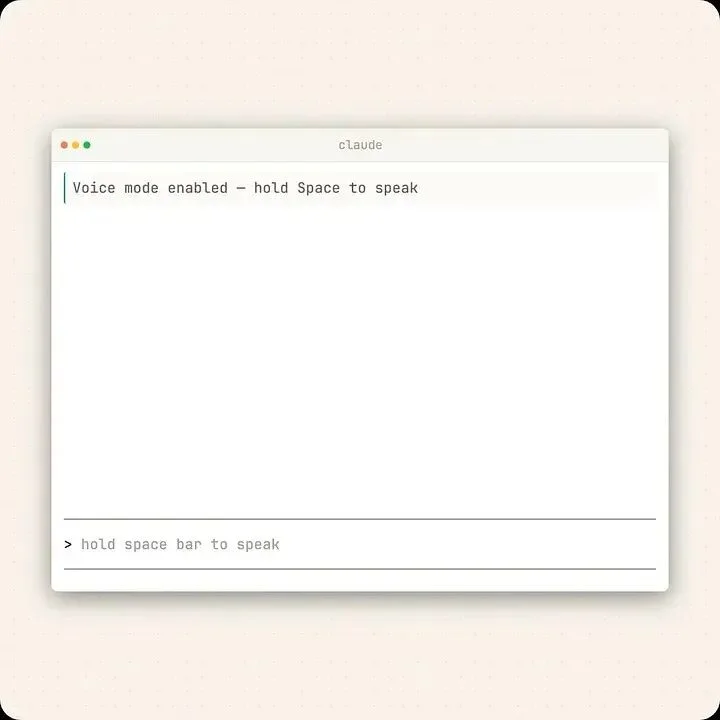
Claude Code 的语音模式
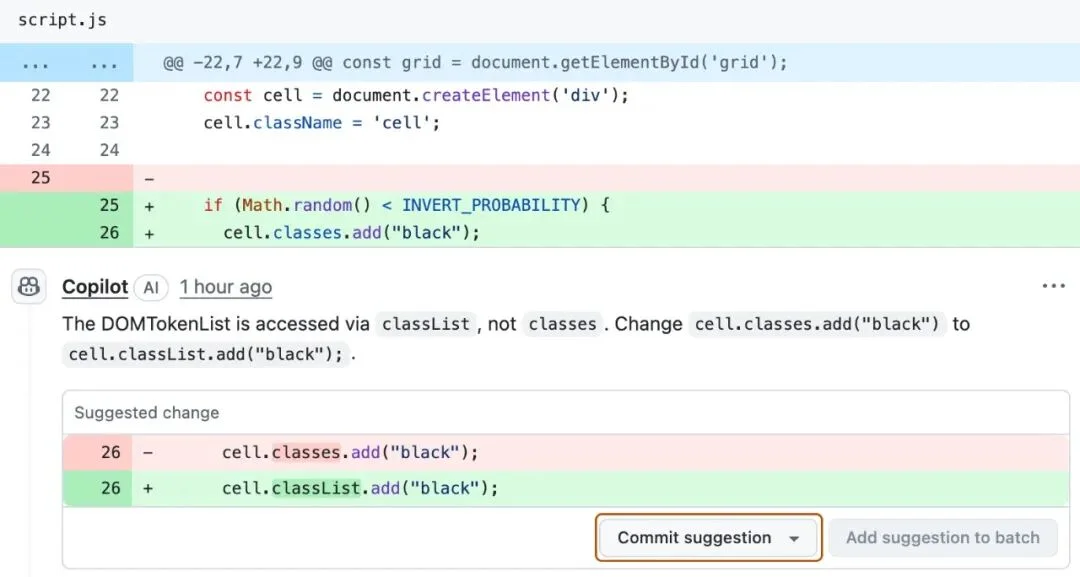
但是在工作生产的场景,它并不擅长让人同时审阅多个并列的选项。写文章时,我们需要一目了然地看到段落结构并随时回溯修改;写代码时,我们必须盯着屏幕比对代码差异与运行结果。
哪怕只是订一张机票,把几个航班的价格、起降时段和退改签规则同时铺在屏幕上扫一眼,也远比听语音助手逐条念出来要高效得多。
AI 替人代劳的权限越大,人类往往越需要一块可视化的界面,去核实它到底干了什么,并且在出错之前就及时停下和回撤。
物理环境与社交礼仪同样在暗中划定语音的边界。在开车、做饭或双手抱着孩子的时候,视线与肢体被双双占用,开口说话无疑是最省力的救星;可一旦场景切换到安静的开放式办公室,一个人对着电脑持续不断地说话,还是显得太诡异了。整个办公室都一起说话,更有如大型客户呼叫中心。
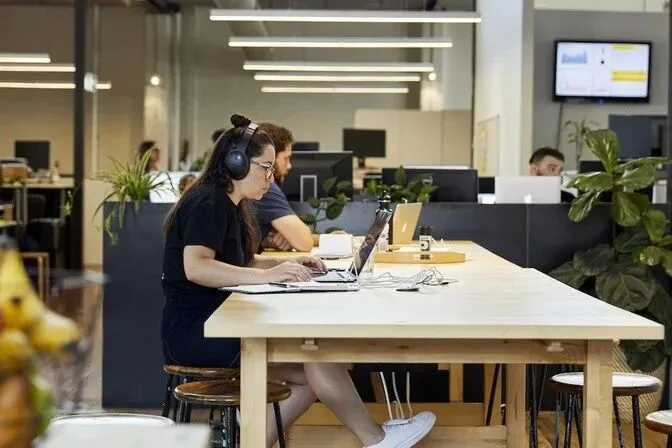
这些场景,关乎信息带宽与隐私边界的制约,无论工程师把模型延迟再往下压多少毫秒,也不能解决。
科幻片里「对电脑说句话,一切就完成了」的预言正在被逐渐兑现。只不过,机器越是学会了如何像人一样说话,我们反而越清楚地意识到,哪些时刻可以说话,哪些时刻还是得闭嘴。
文章来自于微信公众号 “APPSO”,作者 “APPSO”