


🚥本周「十字路口」的嘉宾是李磊,小米 MiMo 大模型后训练研究员、香港大学在读博士。一边参与大模型训练,一边读 PhD,他和许多同学一样,面对着 AI 带来的巨大机会,也置身于飞速变化的节奏中:既兴奋,也焦虑。
这期播客,我们聊的主题是:在 AI 时代,PhD 怎么拿到一个理想的结果?
我们聊了 PhD 路上的 10 个关键问题:慢科研,还是快科研?学校和导师怎么选?内地、香港、美国如何选?怎样争取研究机会与实习机会?论文发表之后,如何通过开源和社交媒体,让研究被更多人看见,产生真正的影响?如果本科就能进入 AI Labs,读 PhD 还值得吗?
我们也聊到了 PhD 圈里的“大粉理论”:小红书的粉丝量超过论文引用数。这个说法背后,是研究成果传播方式的变化。
最后,我们还聊了 RSI、数商、Benchmark 等近期受到关注的话题。
如果你正准备读 PhD,或正在为研究、毕业和求职感到焦虑,希望这场对话能帮你想清楚:下一步,什么值得投入,又该从哪里开始。
微信收听播客:
小宇宙收听播客:
🎬 视频播客已同步上线于 @Koji杨远骋 的视频号、小红书、哔哩哔哩、Youtube 等平台
👦🏻 Koji
我们先来快问快答,帮助大家更好的了解李磊,请问你的年龄?
🧑🏻💻 李磊
28 岁。
👦🏻 Koji
MBTI 和星座?
🧑🏻💻 李磊
ENTJ,巨蟹座。
👦🏻 Koji
求学经历可以介绍一下吗?
🧑🏻💻 李磊
我 2016 年在西安电子科技大学读本科,2020 年到北大计算语言学研究所读硕士,2023 年到香港大学 NLP Group 读 PhD。
PhD 怎么拿理想结果?
👦🏻 Koji
最近小米 MiMo 做了一件很有意思的事情,你们把 MiMo-V2.6 的 Pro 和 Flash 两款模型的后训练直播直接搬到了网上,国内外有非常多的关注和讨论,你就是幕后的推动者。
很有意思的是,你一边在参与飞速发展的 AI 行业,另一边同时还是在读的博士四年级学生。今天想聊一个很多人都很感兴趣的话题:在 AI 时代要怎么读好 PhD,才能拿到一个不错的结果?
🧑🏻💻 李磊
先说说 PhD 重要的里程碑,首先是读 PhD 这个决定。我纠结了一段时间,最后我给自己的答案是:如果 10 年以后躺在床上,可能还是会后悔没有去读 PhD。 既然这样,那就去读吧。
这一步蛮重要的,现在大家会有很多考量,机会成本很大,尤其是整个工业界的待遇和学术界之间有 gap。但我觉得钱的事情可以以后再说,这段时间你能够去专注做一些自己想做的事情。如果当时不去,回过头来我还是想要这样一段经历。
接下来的 milestone 挺戏剧的。我在北大最后的一段时间跟师弟合作,获得了 Best Paper 。入学两个月后,我参加的第一个会议,师弟的 paper 中了 Best Paper,我自己也有一篇工作。
刚入学时,我对于能不能顺利完成博士考核,其实打过退堂鼓。但 2023 年 11 月刚好入学两个月拿了奖,当时觉得属于巅峰开局,甚至害怕会不会出道即巅峰。
👦🏻 Koji
这么巅峰开局之后,后来的路一直很顺利吗?
🧑🏻💻 李磊
整体来说,可能验证了我之前的一套打法。
👦🏻 Koji
什么打法?
🧑🏻💻 李磊
总结来说,一个是快速迭代,自己要有比较专注高效的的工作节奏,及时参与到社区,向 peers 或者更 senior 的老师同学获取反馈。
第二个是技巧和心态上,选择去做难而正确的问题。 如果事情不够难,就会有非常多的竞争对手,在现在的时代很容易被干掉。
正确有两个方面:一个是大家都非常关注的问题,大概率是目前比较重要的;另一个是难。当你在解决一个重要问题的时候,即使它很难,只要 make a little bit of progress,也很有可能获得非常大的影响力。
👦🏻 Koji
难而正确意味着做起来会很慢,同时还要拿到正反馈,听起来似乎是冲突的,但你已经回答了:一个难并且重要的事情,哪怕一点点进步,大家也会认为非常 significant。
🧑🏻💻 李磊
这样的话,反倒大家对你的要求不会那么苛责,因为大家都知道很难。很多人面对困难的问题,第一步就觉得太难了不知道怎么解决,没有头绪。但是只要你能够找到一个好的切面,比较扎实地提供一部分解释,或者实验理论分析,对于后续想要研究这个问题的人来说,就是一个非常重要的 milestone。
👦🏻 Koji
你觉得这一套 PhD 打法适合所有人吗?
🧑🏻💻 李磊
不一定适合所有人,但我目前观测下来,它很大程度上可以减轻焦虑。
👦🏻 Koji
PhD 们都在焦虑什么?
🧑🏻💻 李磊
现在的 PhD 首先焦虑 publication。但又面临一个很 drama 的问题:整个顶会的系统在 AI 的冲击下,可能处在有些难以为继的状态。
再就是首先要满足毕业要求。其次是发了那么多 paper 之后还有没有用?比如 Astra 出来之后,很多做具身的会觉得整个 domain 都被颠覆了,这也是焦虑的来源。
最后是做了有意义的东西、有了 publication 之后,能不能完成从 PhD 到工作的转换。
👦🏻 Koji
在这些焦虑面前,你有什么应对建议?
🧑🏻💻 李磊
如果还要在这个游戏里面玩,心态上还是要放松。虽然竞争剧烈,但社区也在想办法稳固审稿系统。大家要相信这套系统已经运行了很久,还是有内在生命力的,能够保证好的内容被录用。
第二个是做的东西有没有意义。乍一看 Astra 很牛,但仔细看会发现它其实有很多毛刺。大家要对大模型锯齿状的智能有一定了解:它在有些地方看着非常厉害,但有些地方是完全没有的。
这很考验大家真的坐在电脑前去 coding、设计 harness、跑出来看数据和模型的表现到底怎么样,而不是被 social media 上的一些炒作震惊瘫坐。你能看到的东西容易被放大,但有非常多看不到的地方,依然值得去思考和研究。
👦🏻 Koji
比如举个具体的例子,最近你看到还值得去思考探索的、尤其像 Astra 这种 SOTA 模型的一些毛刺?
🧑🏻💻 李磊
我们也在做一些具身实验。一个值得研究的问题是:能力是从哪里来的?你可以 traceback 到很多模型到底是哪里泛化过来的。知道它从哪里来,才能更好地提升它。
👦🏻 Koji
我浅显的理解是,OpenAI 一直在采购具身的相关数据,是用这类数据训练出来的?
🧑🏻💻 李磊
我们猜测可能是这样。再具体到各个 domain,比如在 simulator 里的效果怎么样、在真机上怎么样,会不会有一些泛化的 gap,这些都是非常值得研究的问题。
AI 论文会挤垮顶会吗?
👦🏻 Koji
所有的学术顶会都被 AI 论文大水漫灌,你觉得这个系统还会好吗?
🧑🏻💻 李磊
压力确实存在。比如我做审稿人、做 Area Chair,原来可能看两三篇,现在大概是 10 篇左右的量级,审稿人的工作量受到最直接的冲击。考虑到大家都是 DDL 战士,原来留半天把最后几篇搞定,现在这种情况下,做出的判断随机性就会变大,这是最直观的冲击。
整个会场的容纳量也在变大,像 NeurIPS 就有三个会场。但社区也在通过限制投稿数量、推动更有经验的审稿人承担更大责任、引入 AI 审稿辅助决策来让结果更准确。像 AAAI 现在要求做决定时由两个 senior SPC 讨论,也是想在方便管理的情况下把录用决策做准确。
但有人的地方就会有随机性,大家不要把 accept or not 作为最终的 reward。
👦🏻 Koji
现在听起来有一条 hack 系统的路:用 SOTA 模型做 100 篇论文投出去,拼随机概率。你怎么看这种做法?
🧑🏻💻 李磊
这种做法不好,相当于对整个系统进行 DDoS 攻击,瞎猫碰死耗子总是有可能的。但 paper 本身并不是为了让它中稿,而是做了一个很有意思的研究,希望找个地方分享给大家,是 knowledge sharing。
100 篇这样的东西,背后的人真的把事情弄清楚了吗?是否有严密的论证、理论或实验去验证提出的 hypothesis?这些才重要,而不是 paper 到底中没中。
如果人加 AI 的组合能够提出 100 个有价值的问题,并且在 AI 帮助下解决得很好、提供可靠的的答案,那投不投稿都无所谓。就像 OpenAI 放出几百个数学证明,可能有些对的,有些是错的,但它有一定意义,只是同样需要耗费很多人力去验证。
👦🏻 Koji
你觉得会不会出现一些新的评价体系?
🧑🏻💻 李磊
其实现在已经开始弱化 publication 体系了。但只要存在评价体系,就一定会有 reward hacking。
比如现在筛选候选人时,paper 更像 nice to have 的东西。原先是个很好的金标准,现在大家都有,没有也变得没那么重要。
👦🏻 Koj“i
为什么 ”99 个人有而你没有” 反而不重要了?因为显得很 outlier 吗?
🧑🏻💻 李磊
对,可能意味着他知道这个游戏坏了,就不玩这个游戏,我们还蛮喜欢这样的画像。现在贡献开源项目是个很加分的项,但也存在 hacking 机制,有人用 AI 提 PR 被 merge 了,就说自己是贡献者。
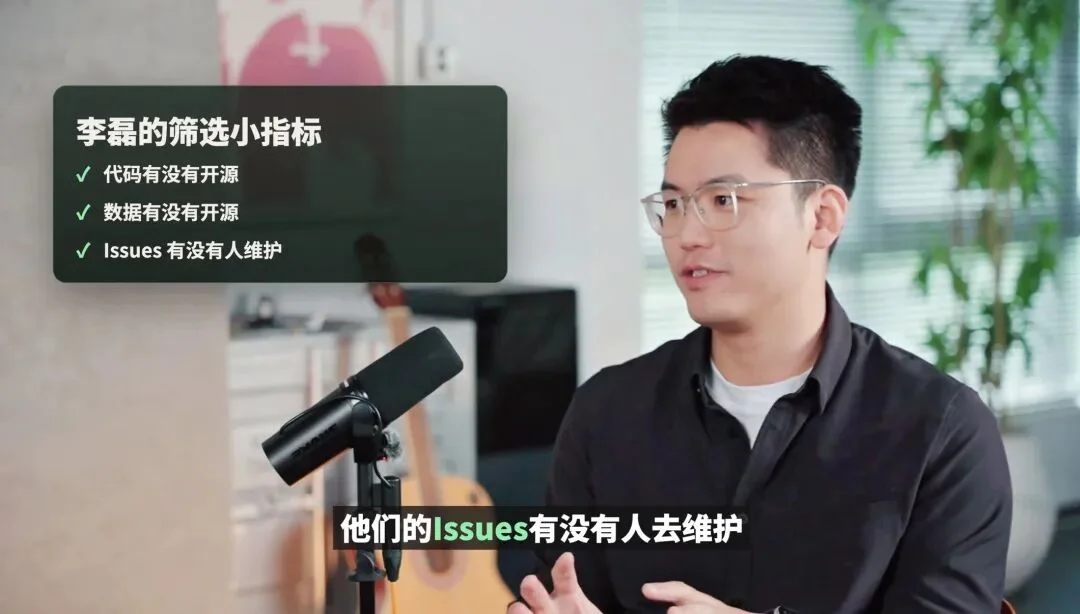
我有一个筛选的小指标,尤其是有 publication 的:看他们的代码、数据有没有开源,开源之后 issues 有没有人维护。
👦🏻 Koji
更是在真实世界里看看作品有没有产生影响力?
🧑🏻💻 李磊
对,我们现在比较关心比如 Hugging Face 的下载量。如果你做了一个模型说是 SOTA,但在 Hugging Face 上个月的下载量只有数十次,可能解决的并不是那么重要的问题。
👦🏻 Koji
Hugging Face 的下载量可以 hack 吗?
🧑🏻💻 李磊
也可以 hack,但代价蛮大的。首先要下载下来存到硬盘上,硬盘还蛮贵的。
PhD 为何要做小红书?
👦🏻 Koji
我看了一下,你的小红书粉丝数今天是 2.4 万。上次聊天你开玩笑说比论文引用数要高,为什么会去对比论文引用数和小红书粉丝数?
🧑🏻💻 李磊
这可以归到 PhD 的 must-to-do 里面:做自媒体。
Social media 是一个反馈比较快的地方,发的东西好不好,点赞和收藏是很直接的反馈。现在大家的线下交流少了,但在小红书或 Twitter 上,推荐算法能够帮你吸引到一批有相同 research taste 的同学,会有非常好的交流,这是反馈层面。
另一个层面是最近提到的“大粉理论”:PhD 学生的 Twitter 或小红书粉丝量、点赞量要超过 citation,说明在践行大粉理论。我觉得它是一个 Attention Is All You Need 的显化。
现在的 paper 很多,原先大家依赖的分发机制是看每一年 ACL accept 的几百篇 paper,根据关键词和老师挑出几篇看完。但现在一个会议四五千篇,不可能看得过来,大家会依赖论文推荐或社媒的推荐系统,如果你能在系统中占据更大权重,声量被放大,工作就能被更多人看到,更好地强化工作的价值。
👦🏻 Koji
在 PhD 圈子里,除了大粉理论,还有什么理论?
🧑🏻💻 李磊
薄肌理论也应该推行到 PhD 群体里。读博是一个漫长的过程,身心健康始终是第一位的,确实需要换换脑子。
👦🏻 Koji
作为 PhD,要怎么运营小红书?
🧑🏻💻 李磊
首先是利他。发争议性的观点容易爆,但大家只会点赞评论,不会觉得跟这个人相关。只有持续产出对别人有帮助的内容,收获的影响力才是副产物。
第二个是要坚持。我一开始在小红书发很多论文 notes,粉丝增长很少。直到有一天发了引用和粉丝关系的讨论,突然爆了一下。把它做成日常的事情,想到什么发什么,最后呈现出最真实的状态,一定能吸引到想吸引的人。
第三个是做自己。赛道很卷,去模仿别人会很累,因为不知道对方背后的动机是什么。做自己,把想到的、符合前面两个条件的内容发出来。粉丝数量不是最重要的,找到一帮同频的人有一个好的交流平台,目的就达到了。
👦🏻 Koji
利他、高频、做自己,这几个建议蛮好的。你在小红书上点赞最多的笔记是哪几篇?
🧑🏻💻 李磊
拿奖的最多,比如青云奖学金,还有 citation 超过 1 万的笔记。学术方面,之前关于 On-Policy Distillation 的 notes 关注度也蛮大。我们团队比较早采纳这种新范式,看到之后觉得很不错于是就写了笔记。
👦🏻 Koji
我看最近代季峰老师、自然意志他们的新工作出来,你也会发分析解读,流量感觉也不错?
🧑🏻💻 李磊
大家很关注 Neo Lab 的动态。代老师他们做得非常不错,有一些 RSI 工作正好用了小米的基模,我就顺手研究了一下。
👦🏻 Koji
现在小红书完全是你个人工作、生活和研究兴趣的外化?
🧑🏻💻 李磊
对。
👦🏻 Koji
如果把读 PhD 从入学到毕业划分,你认为可以分成怎样的几个阶段?
🧑🏻💻 李磊
首先是知道怎么做研究,这是一个很重要的 milestone。
做研究之前有一些 preliminary basics,要了解很多基础知识,比如 machine learning、statistics。这些课虽然今天用 AI 似乎不需要补,但很有必要从头到尾自己做一遍。我们当时用 TensorFlow、NumPy、MATLAB 把 SVM 等基础算法实现一遍,吴恩达老师在 Coursera 上的课程非常重要。到今天泛化、overfit 等经典概念仍在整个系统中运作,像 vLLM 用的 PagedAttention 就是操作系统的概念,这些是 basics。
第二个阶段是 research 作为 knowledge sharing,如何让知识更好地传播。这里面包括 paper wr