


昨天,受邀在北京参加英伟达的活动,跟他们一起在店里庆祝,RTX Spark的全球开售。
毫不夸张的说,现场真的人山人海。
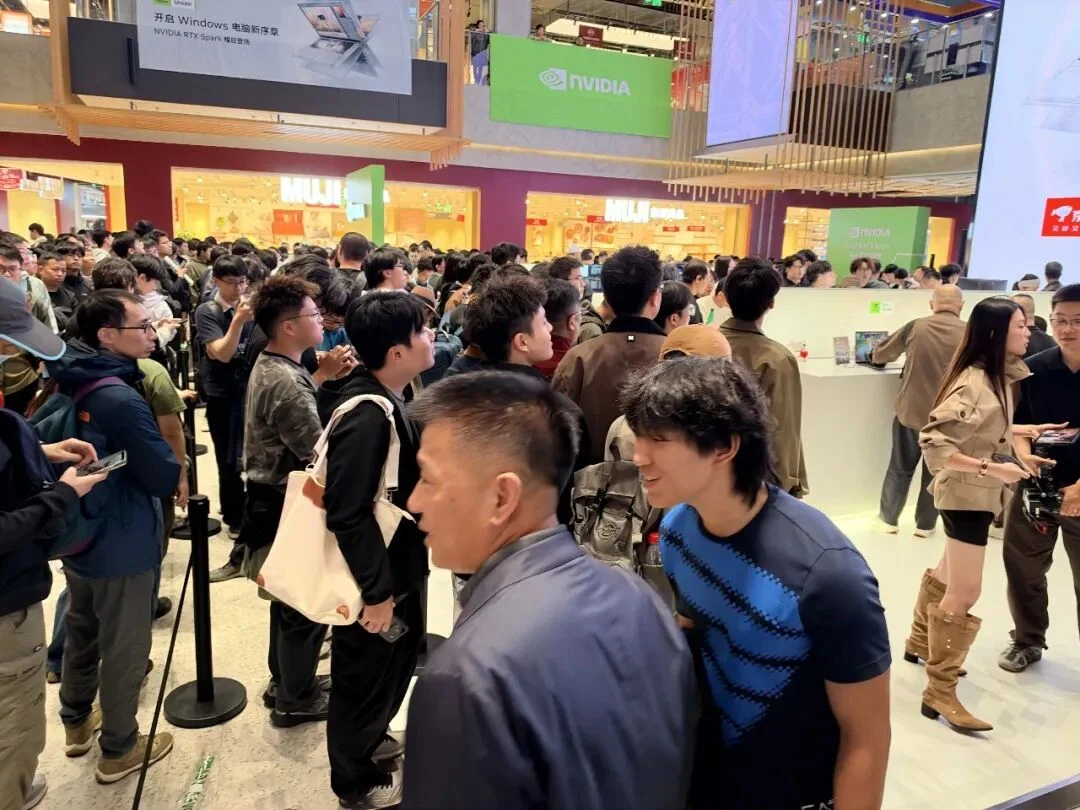
在剪彩开售的一瞬间,我去京东看了下,几分钟不到,128G的版本,直接就被抢空了???
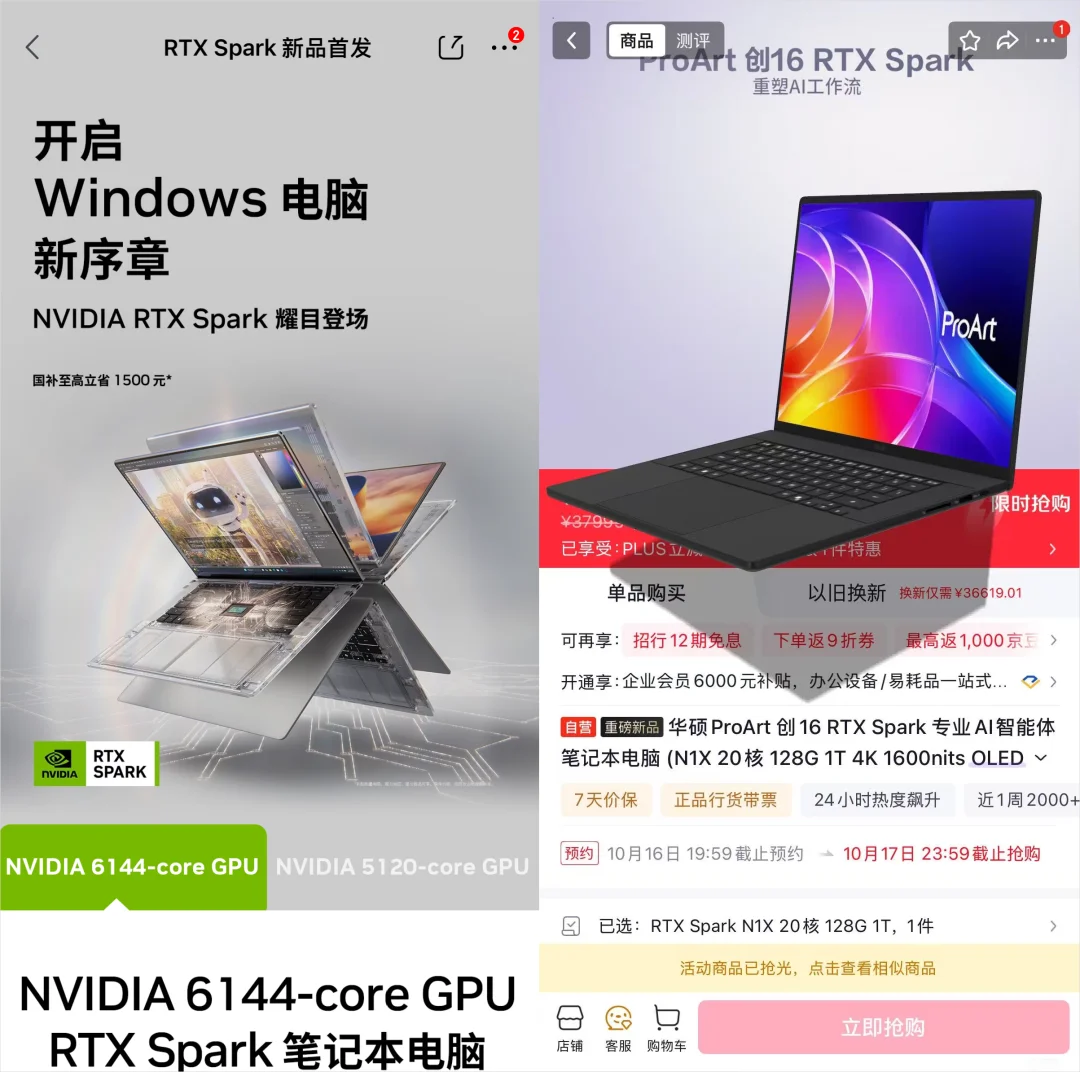
大家对本地算力的需求,比我想象的还要旺盛。
而我自己呢,其实在一周以前就已经收到了RTX Spark的机器,是华硕的ProArt创16,128G统一内存+1T版本,目前在京东售价37999,也就是上面那个在京东直接被抢空的版本。在所有的同机型里,性价比应该是最高的了,其他的同型号有的甚至要贵上万块。
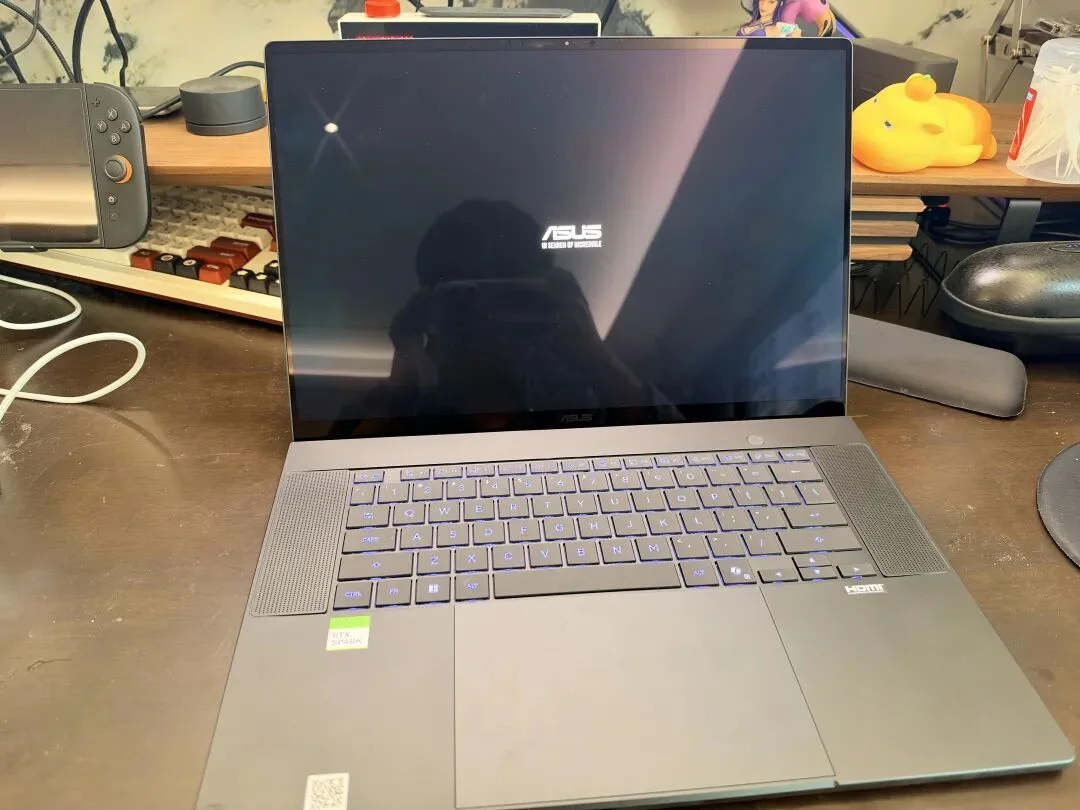
只能说,感谢英伟达。
说实话,第一次拿到手的时候,我最惊讶的地方,其实是它的体积和重量。
你很难想象,这么一台薄至约12.9mm、轻至1.79kg的16英寸轻薄本,里面居然塞进了一颗原生支持CUDA、最高拥有128GB统一内存的RTX Spark芯片。
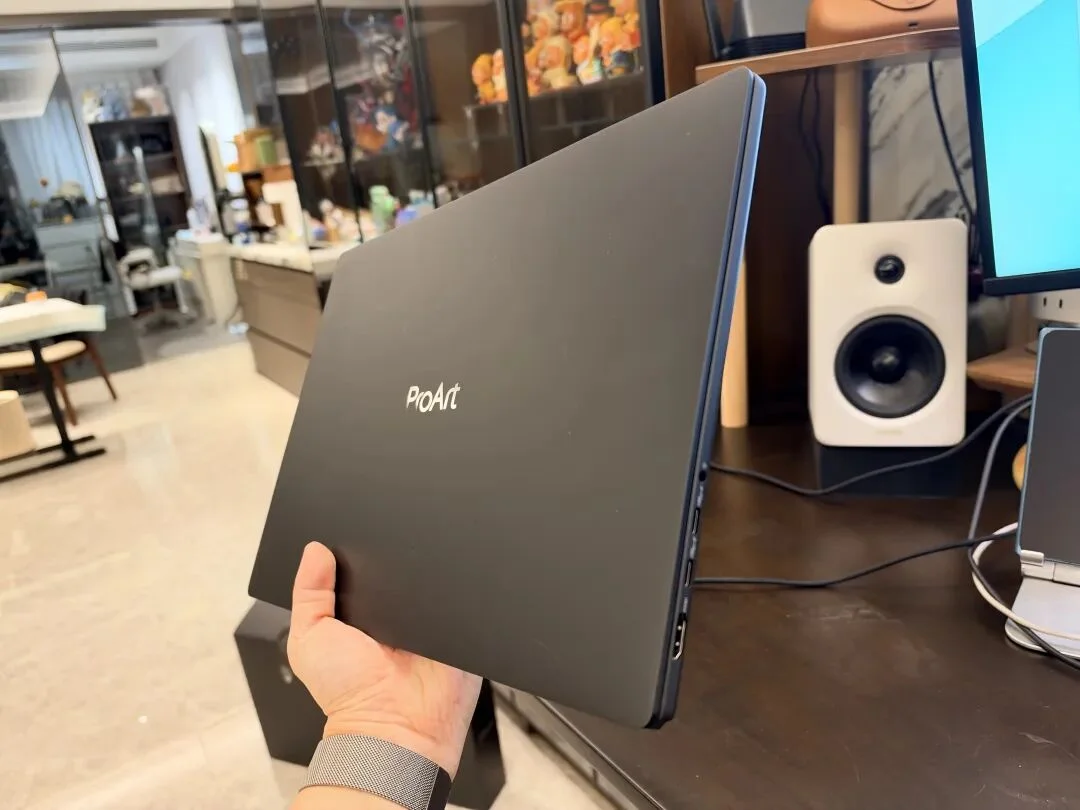
目前我也已经深度使用了一周的时间了,非常想跟大家来分享一下我在这段时间,使用RTX Spark的体验。
其实今年6月,老黄第一次在发布会上发布RTX Spark 的时候,我就写过一篇文章:英伟达发布全新RTX Spark - 个人PC的新时代。
在那之后,我其实就一直等着这台电脑发售,虽然我现在有两台Mac Mini在家24小时跑着Agent,但是谁又能拒绝一个有着统一内存,还有CUDA生态,能在本地跑模型,还能打游戏的超轻薄的RTX Spark电脑呢。
因为过去我们想在本地跑大模型,一直有一个非常蛋疼的问题。
你想要大内存,那可能就得买 Mac。苹果的统一内存确实很牛逼,但是很多AI项目的底层都是围绕NVIDIA的CUDA生态开发的,在Mac上跑起来,有时候就需要各种移植和适配。
你想用CUDA呢,那就得买英伟达显卡。但是传统消费级显卡的显存容量又有限,5090也才32G,稍微大一点的模型,就有可能塞不进去。
而RTX Spark这次,把这两件事情直接结合到了一起。
128GB的统一内存,加上CUDA生态,作为一个喜欢折腾AI、并且还是一个游戏佬的我来说,没办法,RTX Spark还是太有吸引力了,而且基本就是唯一解。
所以一周以前拿到手以后,我除了先下了Steam之外,干的第一件事,就是开始疯狂去部署各种各样的模型。
玩AI的这几年,好像都没有这么痛快过。
而且模型自由、Token自由的感觉,真爽。
可以先给大家看一下我这台电脑的配置。
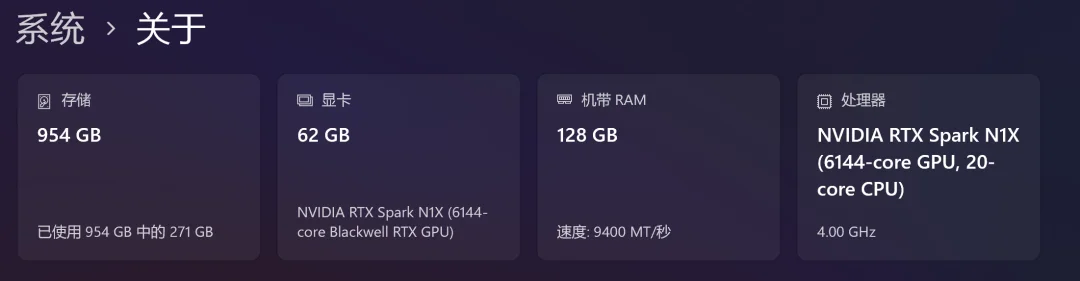
RTX Spark N1X芯片,128GB统一内存,加上1TB SSD。
我知道,大家肯定都还会想跟5090比一下,但这块我想说,RTX Spark主打的还是大容量、便携、以及超高能效。
我简单做了一下表。
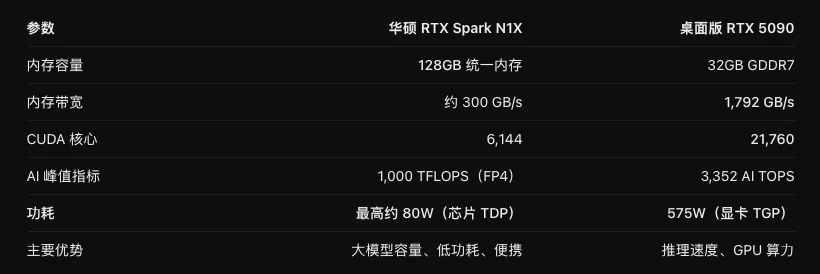
为了大容量和轻量便携,所以英伟达做了一些妥协,压低了带宽和算力,但是换来的,是完全不同功耗。
RTX Spark把功耗压到了80W,而5090纯单显卡,就需要恐怖的575w的功耗,你在笔记本和一些小机型里,根本不可能带的动。
所以,相比之下,我个人还是觉得,对于绝大多数的玩家来说,RTX Spark的适用性和泛化性,还是高于5090的,基本就是用更加广泛的场景,来换取慢一点的速度。
因为这一次英伟达为了让大家开箱即用,所以也贴心的跟WorkBuddy合作了,他们搞了一个RTX Spark专区,所以国内用户完全可以直接下载WorkBuddy,这样可以非常方便的开箱即用。
首先,打开WorkBuddy,在左上角找到这个RTX Spark专区,然后点击切换。
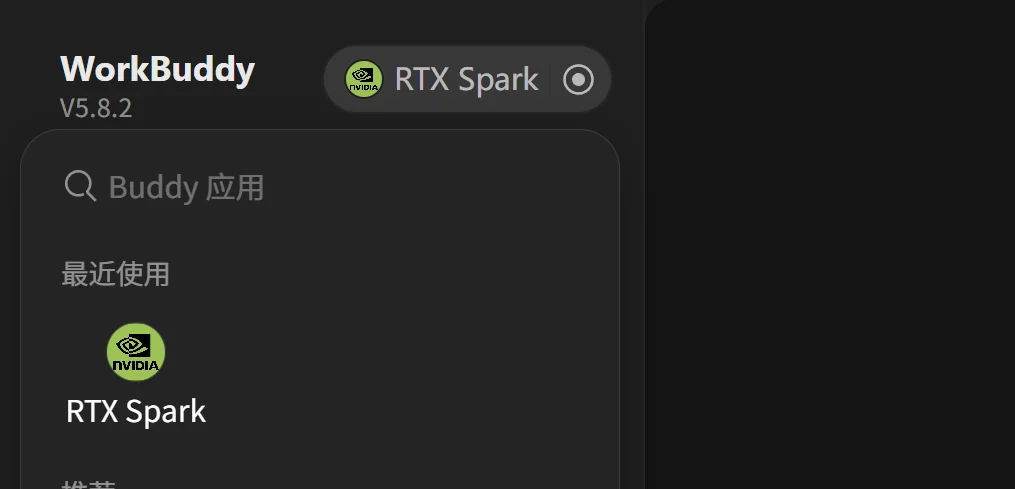
你就可以来到RTX Spark的专区首页了。
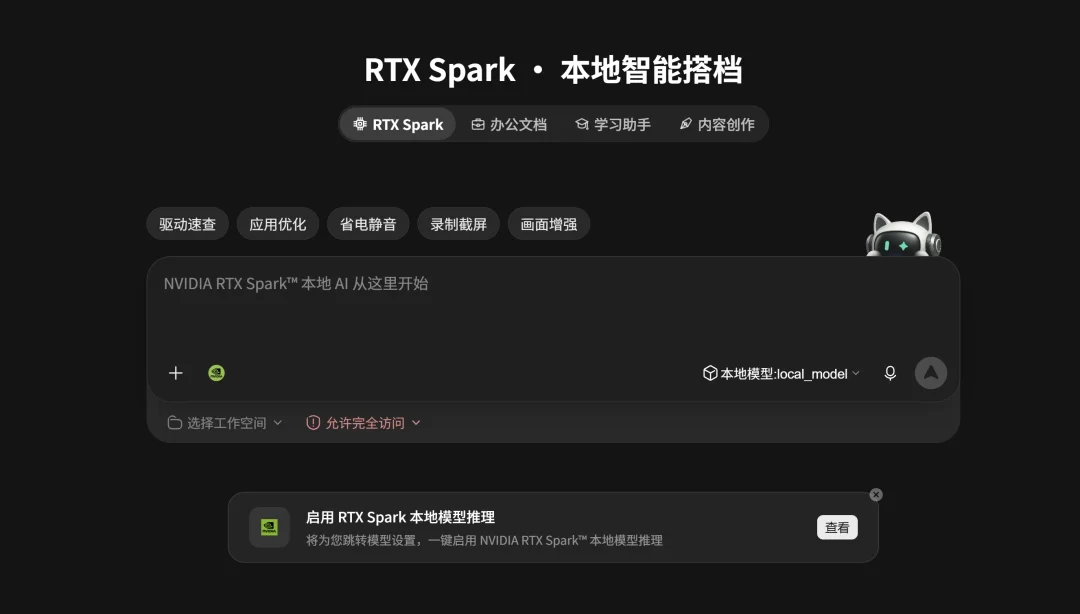
英伟达给了一些预设,你可以快速的进行一些便捷操作。
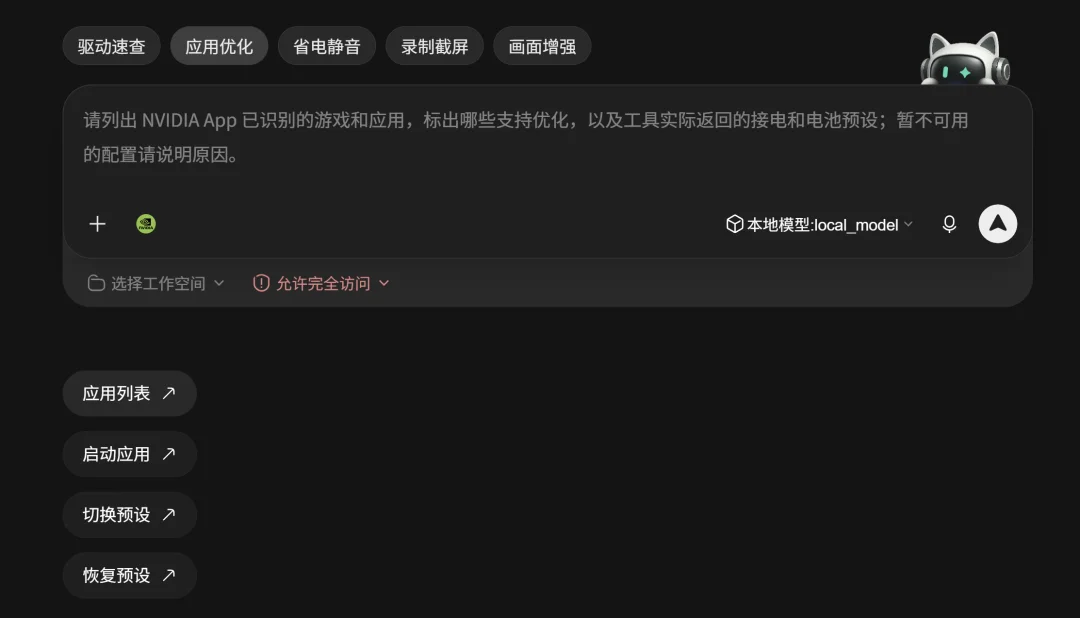
当然,最核心的,肯定还是在这台电脑上,使用本地模型,我都用RTX Spark了,那肯定是要用本地模型的嘛对吧。
点击设置,进入到模型,就能看到这边有个本地模型的选项了。
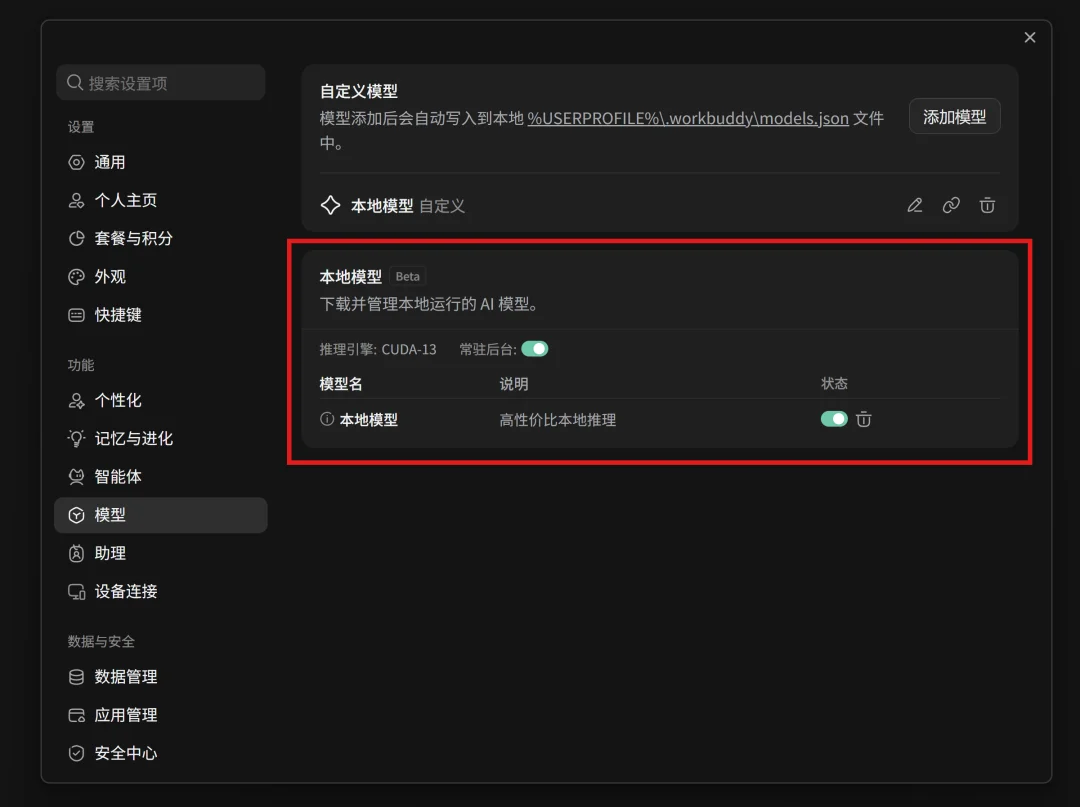
如果你是第一次拿到这台设备,那右边是一个下载的选项,就可以直接一键把模型下载下来放到你的本地了。
这个模型是单独预设的,所以跑的速度还是不错的,能跑到80 Token/秒。
同样的,你也可以自己部署其他的模型,不需知道太底层的原理,可以直接让Agent帮你跑。
对于一台128G统一内存的机器来说,吃下一个100B左右的Q4量化版本,我觉得是没啥问题的,但是相对于日常使用来说,我不建议跑的这么满,需要给别的东西留下一点空间。
所以,我无比推荐大家,换上我觉得本地的一个最牛逼的模型,甚至是能跟曾经的Opus 4.6相匹敌的,且能无时无刻常驻后台的模型。
他就是Qwen 3.8-27B。
这玩意是真的猛,猛到一定的级别了,在AA上,以一个27B的模型,跟一众几千亿的模型打的有来有回。
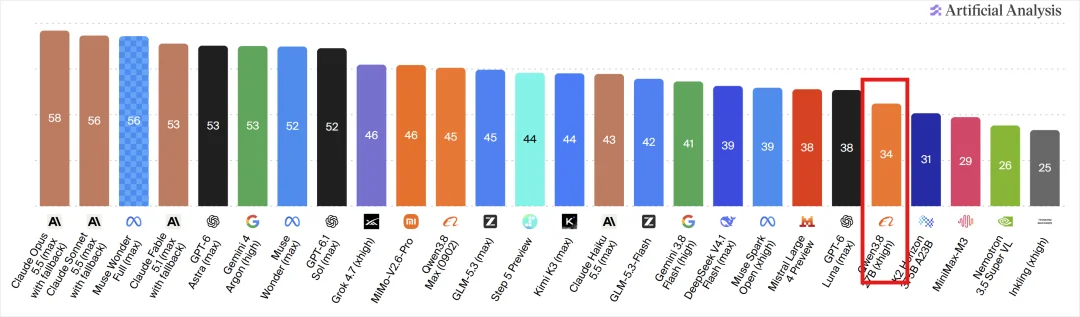
而且是完全可以本地部署的,而且Token无限,绝大多数的活,它其实都足够了。
想在本地部署它,并且在WorkBuddy里一起用,或者放到别的Agent里面变成可选模型,也特别简单。
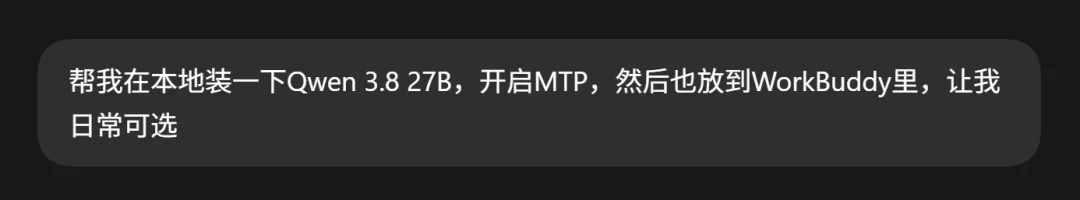
一句话的事,记得一定要说开启MTP。。。
然后,就装好了。
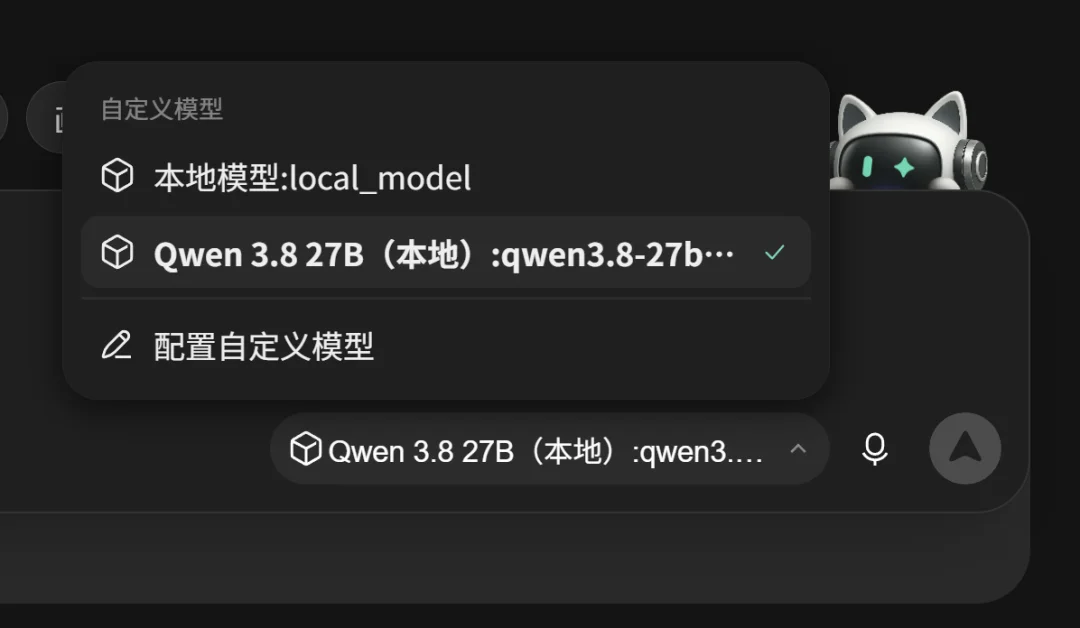
这里要注意,即使开了MTP后,Qwen3.8-27B的推理速度,还是会比比如Qwen3.6-35B-A3B慢不少,主要是因为这是一个少见的Dense模型,所以其实推理的时候也是带着27B的参数一起推理的,而后者其实只需要跑3B,所以会慢不少。
但是换来的,却是智力的飞跃。
我在本地实测大概能跑到30 Token/秒,差不多跟Codex里面的GPT-6.1 Sol一个速度,所以你能接受GPT-6.1 Sol的速度,那我觉得在本地跑Qwen-3.8 27B,我觉得你也没啥问题。
部署到本地以后,你就可以让他快乐的干活了,至此,你也拥有了,无限Token,想怎么干活怎么干活。
比如直接挂在后台,监控我产品的BUG反馈和Github上PR,直接异步全自动迭代,实现loop循环,相信我,在很多场景下,Qwen-3.8 27B,绝对够了。
那我们大语言模型有了,但你都买RTX Spark了,肯定不可能只玩个大语言对吧,那多亏啊。
所以我又陆陆续续部署了一系列的各种各样的模型。
比如图片生成模型、视频生成模型、本地OCR模型、ASR模型、TTS模型,甚至还有专门翻译的小模型等等等等。
各有各的用处。
就像3年前,那时候大家买电脑玩本地AI,很多人都是为了玩Stable Diffusion,那时候还缩写叫SD,可惜现在SD的名字都被Seedance抢走了。。。
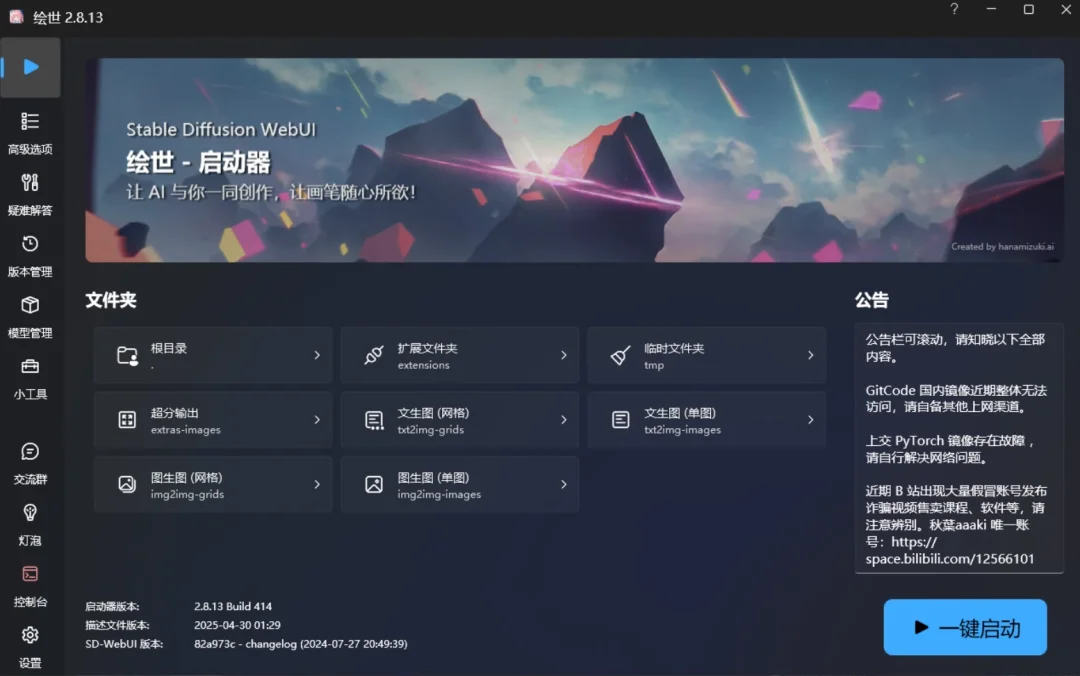
这张图肯定很多人见过也用过,属实是我的AI启蒙。
而现在,版本变了,AI绘图开源模型里面,Qwen-Image-2.1独领风骚,直接就可以部署以后,你也可以实现,无限画图。
BF16、40 步配置,一张1K左右的图,大概需要在1分多钟。
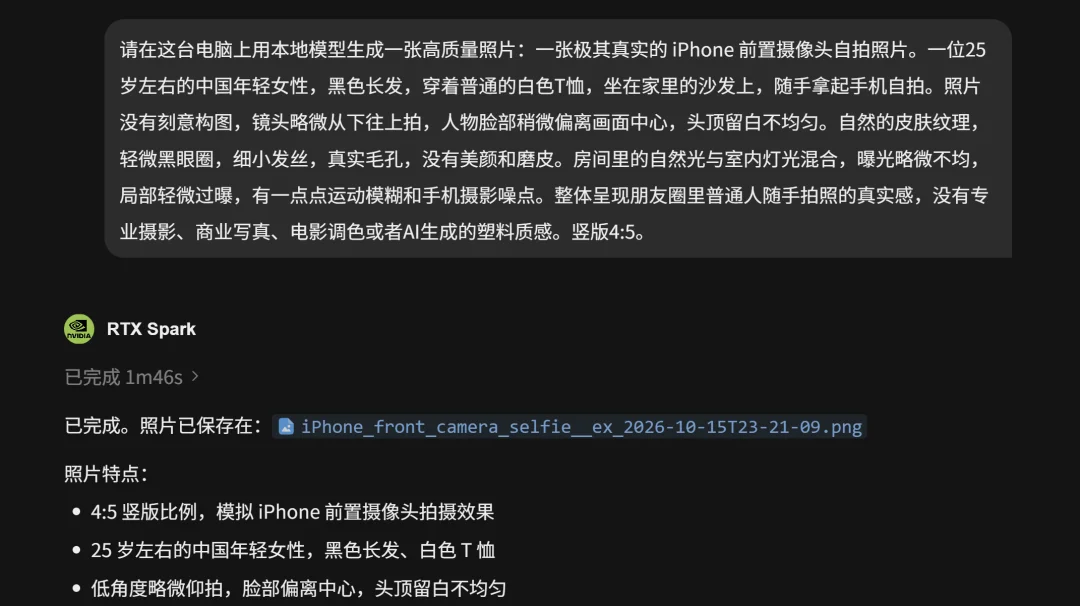
效果也很不错。
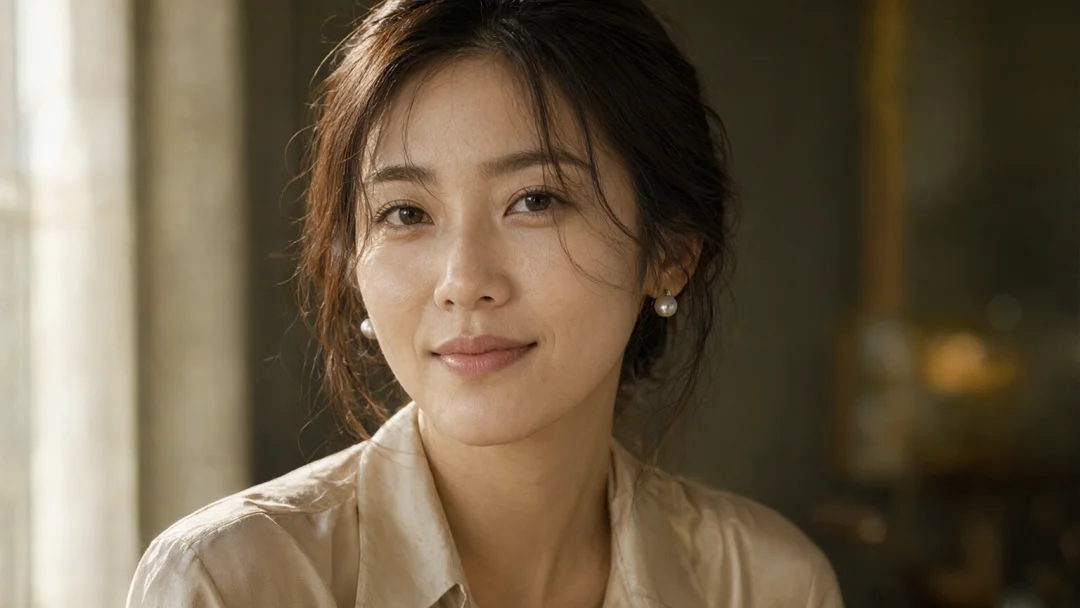
当然,你也可以,直接出视频。
H3在本地就可以直接跑,15秒的720P,本地跑大概20分钟。
还有等等等等。
这些,是我在本地里面,精挑细选之后,装的所有的模型,基本能覆盖到绝大多数场景了。
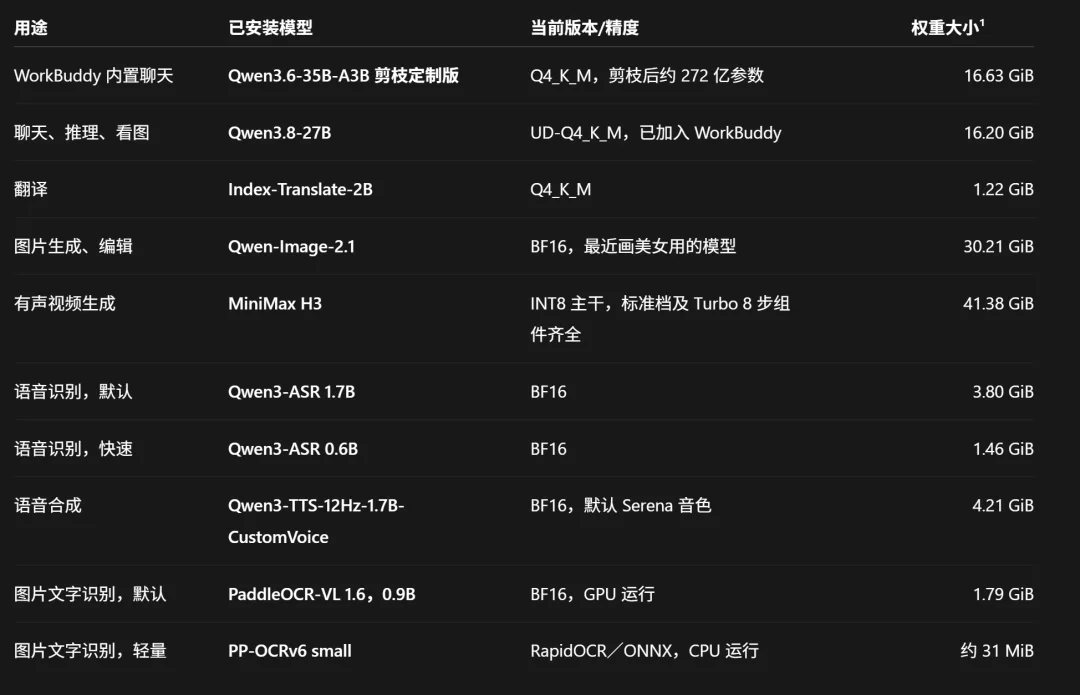
这么一看,在开源生态上,Qwen是真的强的离谱,几乎占了半壁江山。
而折腾这些模型,其实也挺麻烦的,虽然有Agent了,但是还是没有那么开箱即用。
于是,为了让大家也可以方便的开箱即用,包装整合一下,于是,我想了想,把整套的路径和流程,打包成了一个WorkBuddy上的专家,放在了RTX Spark的专区里面。
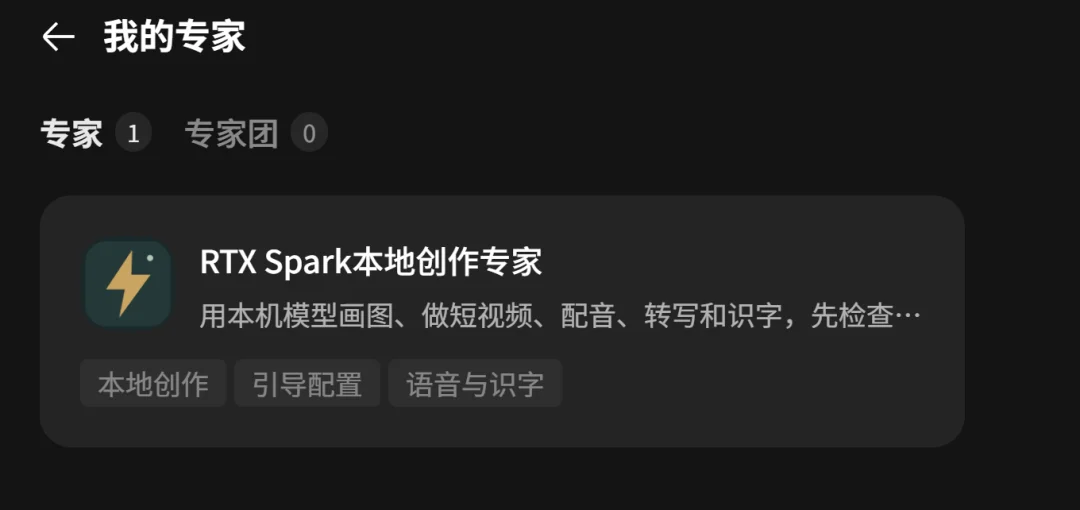
当你把机器买来以后。你只需要打开WorkBuddy, 安装这个专家。
它就会先检查你的电脑配置,以及本地已经有哪些模型了。
因为并不是所有人,都是128G的内存版本,那适配和能带的动的模型也不一样,所以这个专家会根据你的实际电脑配置来给你做一个清单的规划,告诉你应该配置什么样模型。
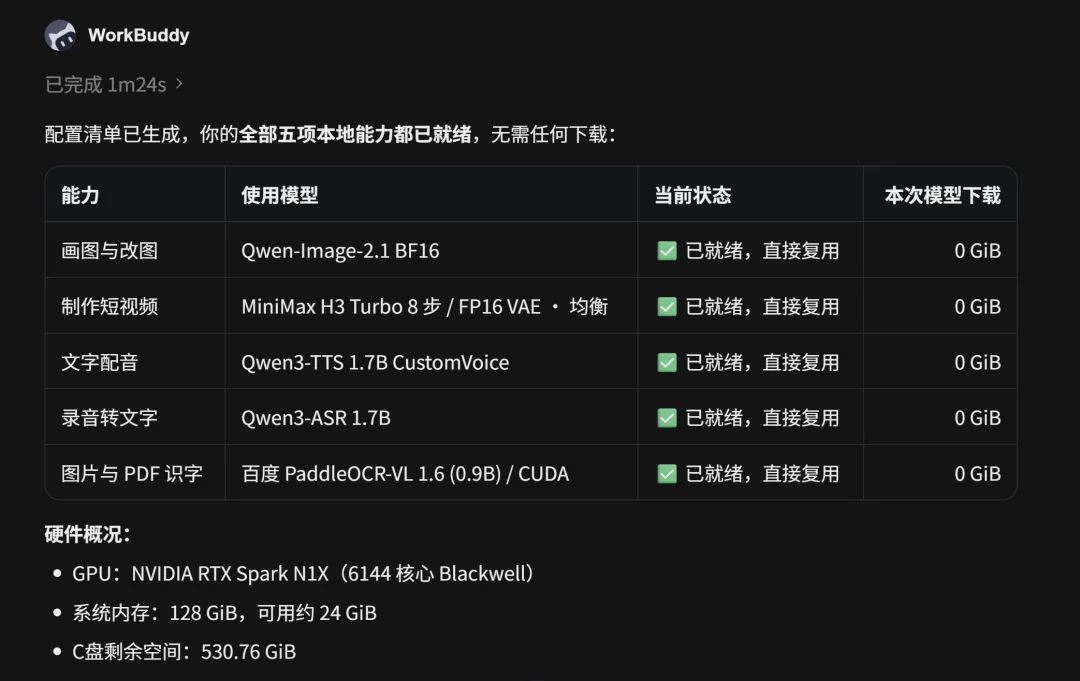
如果你已经配置过了,那么他们就会显示已就绪,如果是刚开始没有下载的话,它就会引导你去下载。并且我也全部都设成了魔搭社区的链接,所以也不需要做一些特殊的网络配置。
然后,所有的能力和推理引擎我都已经封装好了,当你跟着引导下好模型之后,也完全可以使用这个专家来调用你所有的本地模型。
比如直接让他画图,再让他生成一段视频,甚至可以组合起来进行使用。
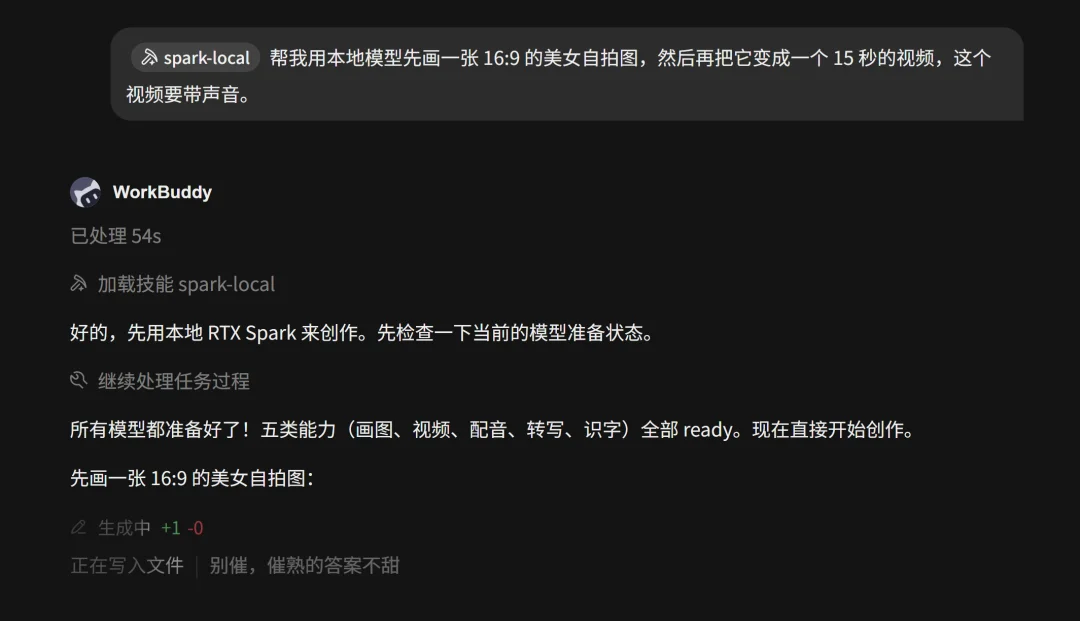
比如,你想给自己的文章做一张配图。
你可以直接跟它说,帮我画一张16:9的赛博朋克风格城市夜景,它就可以调用本地的Qwen-Image-2.1,直接在你的电脑上生成图片。
如果你觉得图片不错,还想让它动起来,那就接着说,把刚刚那张图做成一段视频。它就可以继续调用本地的H3视频模型,去完成下一步的生成。
甚至你还可以把几个模型串起来,这就是128G超大内存的好处了,可以并行跑。
比如,我丢给它一张英文的产品发布会截图,先调用OCR模型把里面的文字识别出来,再调用翻译模型翻译成中文,最后交给Qwen3.8-27B,帮我整理成一段适合公众号使用的介绍。
或者你有一段会议录音,也可以通过本地ASR模型转成文字,再用大语言模型帮你提炼重点、整理待办。
这些场景涉及的模型能力,我都整合到了这个专家里,不过能用哪些,取决于你的电脑配置,还有已经下载和配置好的模型。
而且整个过程中,你不需要自己去研究每个模型的API怎么调用,也不需要知道背后到底跑的是什么推理框架。
而这所有的行为和操作都是在你本地电脑上完成的,不花一分钱。
毕竟大家花了几万块钱买一台RTX Spark,总不能买回来以后,还得先花半个月学Python、学CUDA、学各种推理框架,才能真正把这台机器的能力用起来吧。。。
我希望普通人拿到机器以后,也能尽可能简单地把本地AI用起来。
而且这些本地模型推理,都不需要再额外支付API费用,想画多少图、翻译多少文字,就看你自己的硬件能跑多少了。
希望这个小小的专家,能对大家有用。
当我做完了这一切以后,我是真的觉得自己,用AI的心情,是跟以前不一样了的,有一种,更加自由的感觉,不需要被Token额度所束缚。
真的,每次看到这种东西我都很难受。
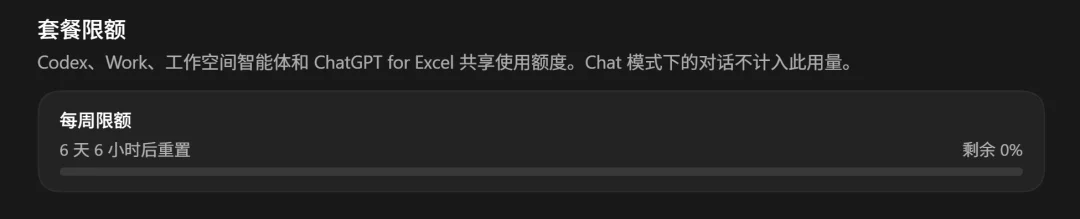
而这种Token自由带来的创造力,我感觉也会更多。
举个例子,我自己的英语不是很好,所以你让我去阅读一些国外的网站。对我来说还是有很大的挑战的,但对于一个AI博主来说,不看国外的网站,那是不可能的。
所以一直以来我都在用模型来去帮我翻译,这就避免不了的,需要用到付费的Chrome浏览器翻译插件,要么订阅,要么为API所付钱。