


GPU不够烧,但AI要啃的任务却越来越长,模型迭代稍慢一步就可能被同行彻底甩下牌桌。
怎么破?
千问交出了一份新答卷——QwenGyre。
在同等GPU预算下,它将原本需要跑135小时的48步强化学习训练时间直接压缩到了75小时,一口气为团队省下了近三天(60个小时)的训练时间。
这意味着,训练团队不用再多加一张卡,靠QwenGyre重新安排算力、处理训练数据,就能把训练效率提升78%。
那么QwenGyre是怎样把原本浪费掉的算力重新抠出来的?
研发过程中又刷新了千问团队对于Agent训练什么认知?
看完你就明白了。
AI接上大工程,训练系统先“堵车”了
从前咱们聊代码Agent,顶多是在SWE-bench这类基准上修一个现成的bug,AI跟终端交互几十轮就收工了。
但现在趋势完全变了。
大家开始让AI独立搞全自动软件开发。
无论是从零搭一个完整代码库、做系统级重写、还是给整个超大工程做代码重构。
这背后,都透露出了用户对长程自主规划与复杂工程落地能力越来越高的要求。
Qwen团队将这类任务称为xLong-horizon,即超长程任务。
跑一次rollout(环境交互),AI要调用各种工具、跑终端命令、反复看报错,连续交互几百次,上下文动辄累积100万token。
这就像公司派了一批AI实习生去独立承包整个重大软件项目,很难吃得消。
而问题,也就恰好出在这场工程实习里。
我们可以总结为两个麻烦。
第一个麻烦:Agent交卷时间参差不齐,算力只能跟着干等
同一批分发下去的任务,有的AI运气好或者任务简单,半小时就交卷了;
但有的AI一旦遇到了棘手bug,就能在沙盒里疯狂死磕4个多小时。
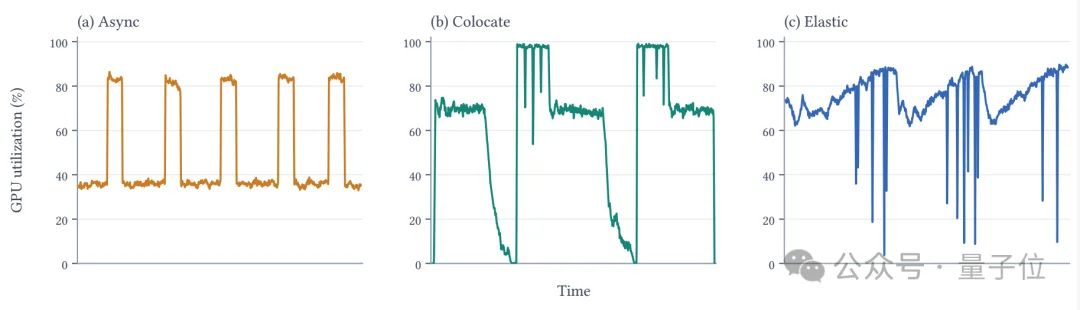
在这时候,如果用传统的Colocate(共享池交替)模式,整个GPU集群就像一个同进同退的大班级。
哪怕90%的卡早就跑完了,也必须死等最后一个拖后腿的AI交卷,才能全集群统一切换去做训练反向传播。
导致提前交卷的算力全都在干等,算力利用率暴跌。
如果换成Async(异步分离)模式呢?
把GPU切成两块,一块专职跑推理,一块专职跑训练?
结果,更尴尬了。
因为超长任务生成太慢,负责训练的GPU经常断粮饿肚子;
而负责推理的GPU卡到冒烟,又没办法把训练卡拉过来帮忙跑推理…
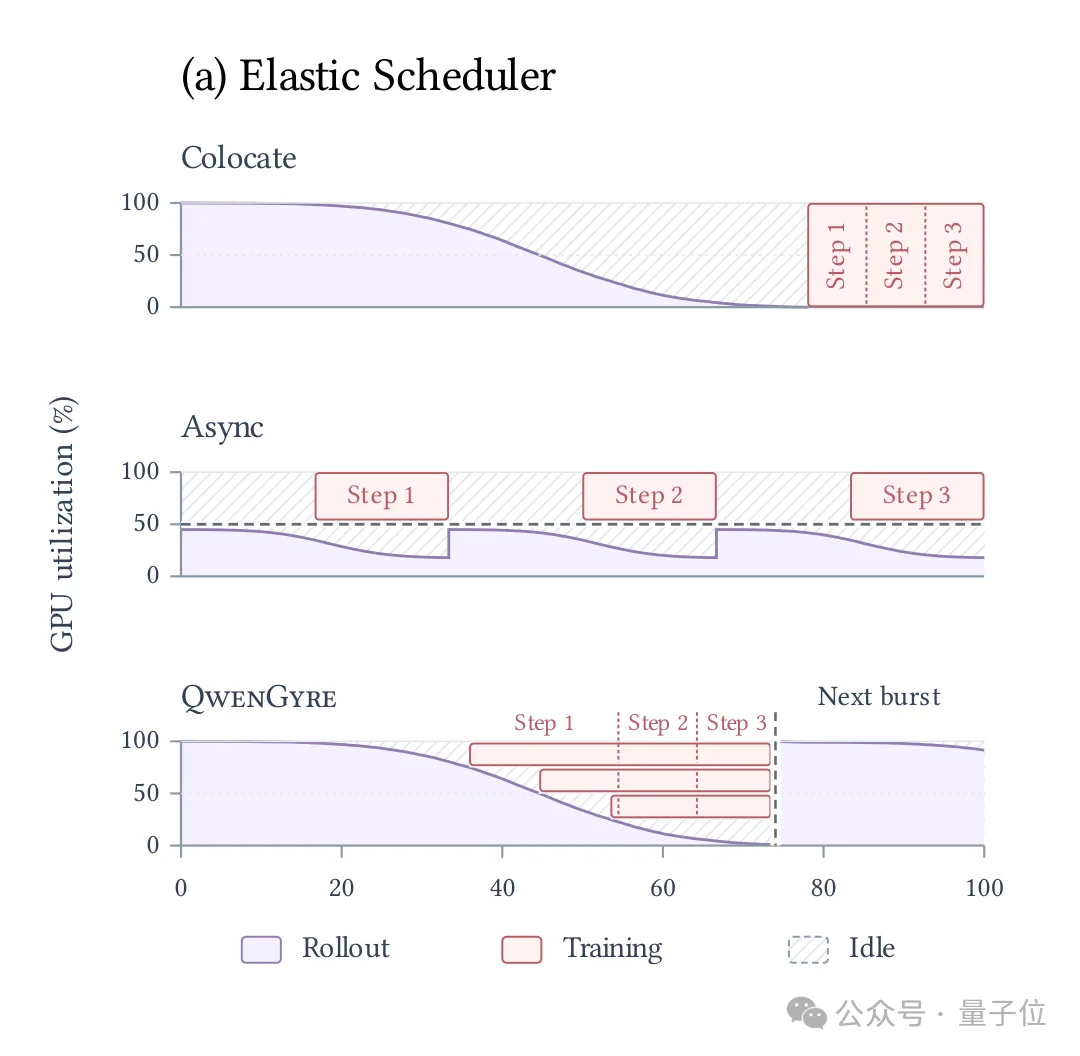
△三种算力调度方式对比
第二个麻烦:工作记录不断分叉,复盘算账彻底乱套。
在几个小时的工程执行里,像Claude Code 2.1.220这种成熟的黑盒Agent框架,可不会像小学生记流水账一样单线往下走。
上下文快爆了,它就会自动做历史压缩(compaction);
任务太重了,它就会派生出子Agent去干活;
命令跑挂了,它就会掉头重试。
于是,跑完一个项目后,AI留下的根本不是一条直线的执行记录,而是一棵枝繁叶茂、疯狂分叉的轨迹树。
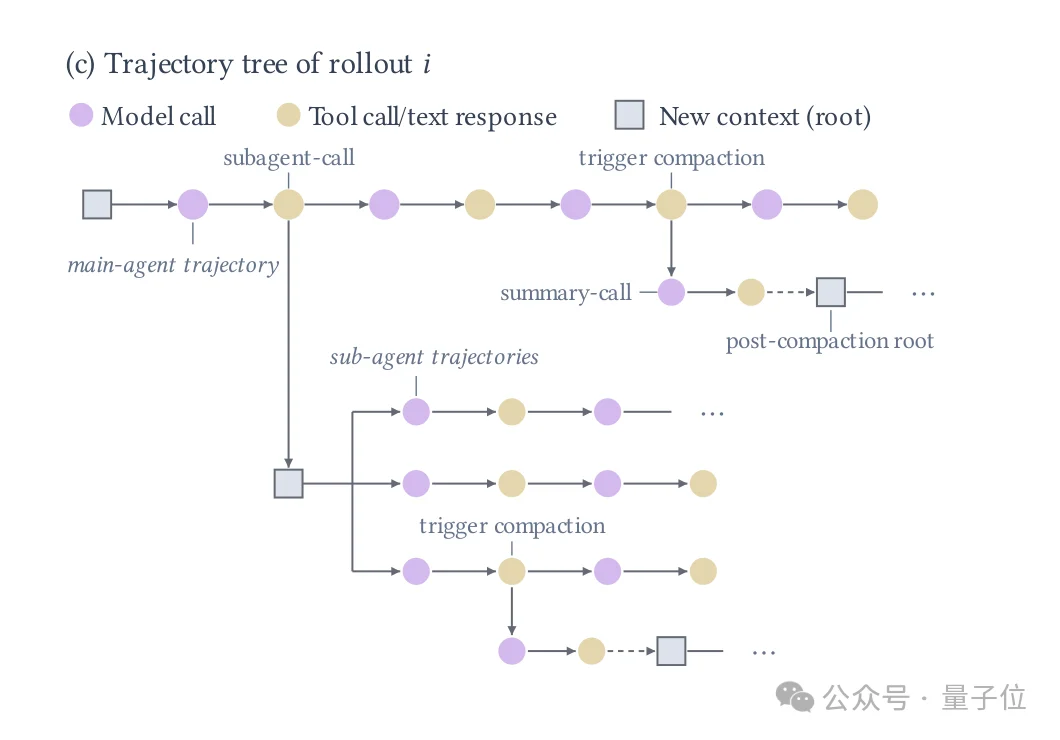
△Agent的轨迹树
要是我们这时候选择做策略优化,系统就会当场就懵圈:
所有分叉路径全展开训练?
不行,显存和计算量会瞬间原地爆炸,里面充斥太多重复前缀;
中途超时的任务怎么算分?
直接判0分太冤枉了吧,毕竟人家已经写完了80%的代码;
但不判0分,又没有最终的成功信号。
面对这团乱麻,QwenGyre干脆把整套系统重构了一遍。
给GPU动态调班,理清AI的“实习日志”
千问团队给出的解法很清晰:
- 弹性调度器(Elastic Scheduler):负责管算力;
- 轨迹处理器(Trajectory Processor):负责管数据。
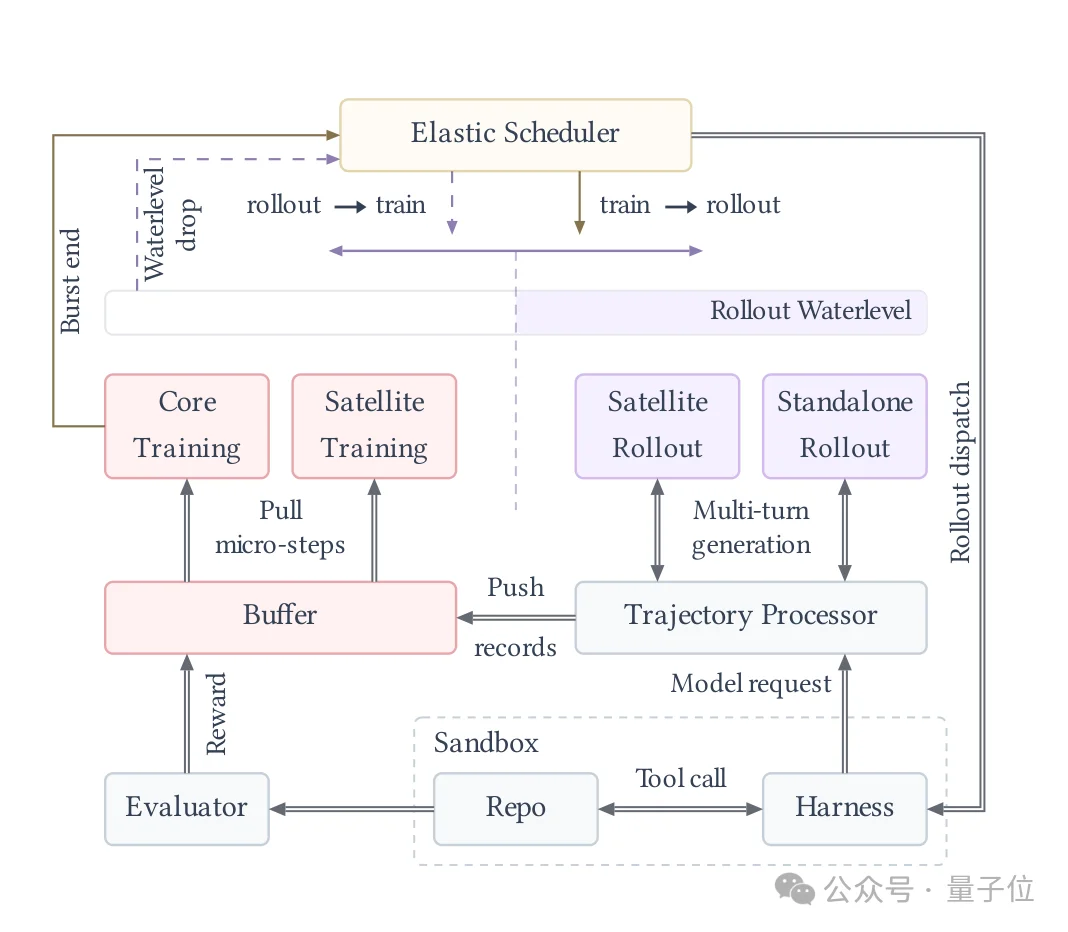
△QwenGyre整体架构
整体运作可以分成两步走。
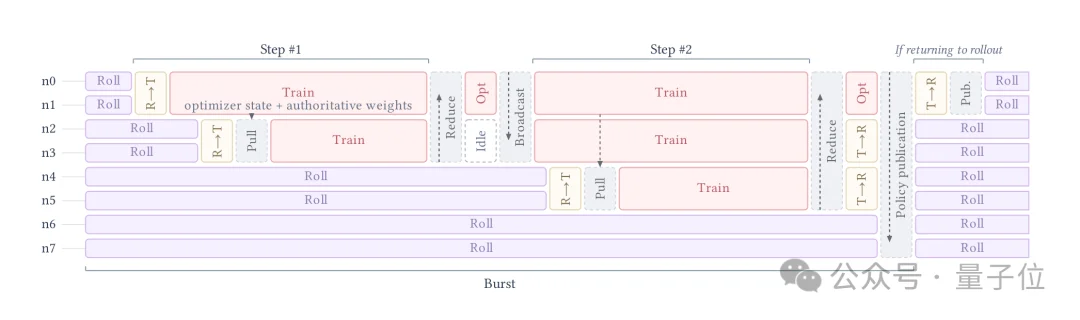
第一步,给GPU无缝调班。
QwenGyre把整个GPU集群切成了多个可以独立切换角色的计算单元(Cell,比如4台机或8台机一组)。
排在第一位的叫Core Cell,掌握着优化器状态和权威模型权重;
后面的叫Satellite Cells。
在任务刚启动时,大家都在全力以赴跑推理。
系统里设置了一个水位线监控机制(Waterlevel Control),时刻盯着还剩多少没跑完的任务。
随着一部分AI陆续交卷,未完成的任务越来越少,水位线跌破阈值。
这时候,空闲下来的Cell不需要等所有Agent,立刻就可以就地转职,切去训练模式。
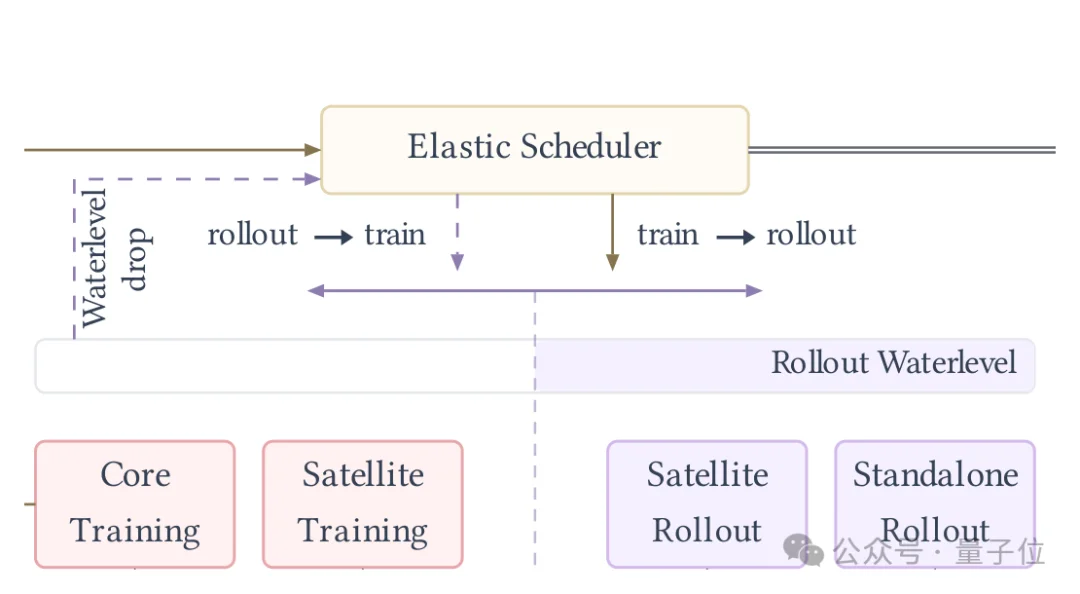
△水位线监控机制图
这套机制的灵感,来源于千问团队内部的一张GPU利用率监控看板。
他们发现,在传统训练框架中,GPU利用率总会呈现出一种锯齿状波动:
第一轮任务刚开始时,大量Agent同时调用模型,导致负责推理的GPU忙得热火朝天、推理需求瞬间拉满;
但随着越来越多Agent完成任务,或者转去调用工具、运行测试,推理需求便会一路下滑,大量GPU也跟着闲下来待命。
而另一边,等待训练的数据却在不断堆积。
于是团队灵机一动:
既然推理和训练的波峰波谷正好错开,那为什么不能让同一批GPU灵活换班,用训练的高峰填平推理的低谷呢?
好一个逆向思维。
既然算力潮汐无法抹平,那就让任务去适应潮汐!
咱们可以把它理解为去银行办理业务。
早晨刚开门时客户扎堆,5名工作人员需要全部留在窗口接待;
但随着一些业务办完,有些客户开始转去填表、复印,窗口逐渐空了下来,只是后台等待处理的材料越堆越多。
这时,银行只需要根据尚未办完的业务量,留下足够的人守住窗口,再让其余员工转去后台处理材料,便能提高整体工作效率。
QwenGyre也是如此。
当推理需求下降时,就把空闲GPU切去训练;
一旦Agent重新需要调用模型,再把算力调回来。
这样,GPU既不用陪着少数慢任务干等,也不会错过随时可能回来的Agent。
看到这里,大家可能会忍不住好奇:
AI还在沙盒里跑着呢,GPU突然切去搞训练,推理不就直接掉线崩溃了吗?
对此,QwenGyre设计了一套透明的无损迁移机制:
1、请求透明重路由:
当某个Cell准备转职训练时,它先停止接收新请求,代理层把后续的模型调用秒级分流到还在负责推理的节点上。
2、RDMA极速搬运KV-Cache:
原节点把显存里的Cache块锁住,目标节点直接通过RDMA把缓存拉过去无缝接力,尽量避免重新算一大段历史上下文。
3、切换耗时极短:
从推理切到训练平均只要8.52秒,从训练切回推理只要3.46秒。
相比于动辄几个小时的工程任务,这几秒钟的切换时间几乎可以忽略不计。
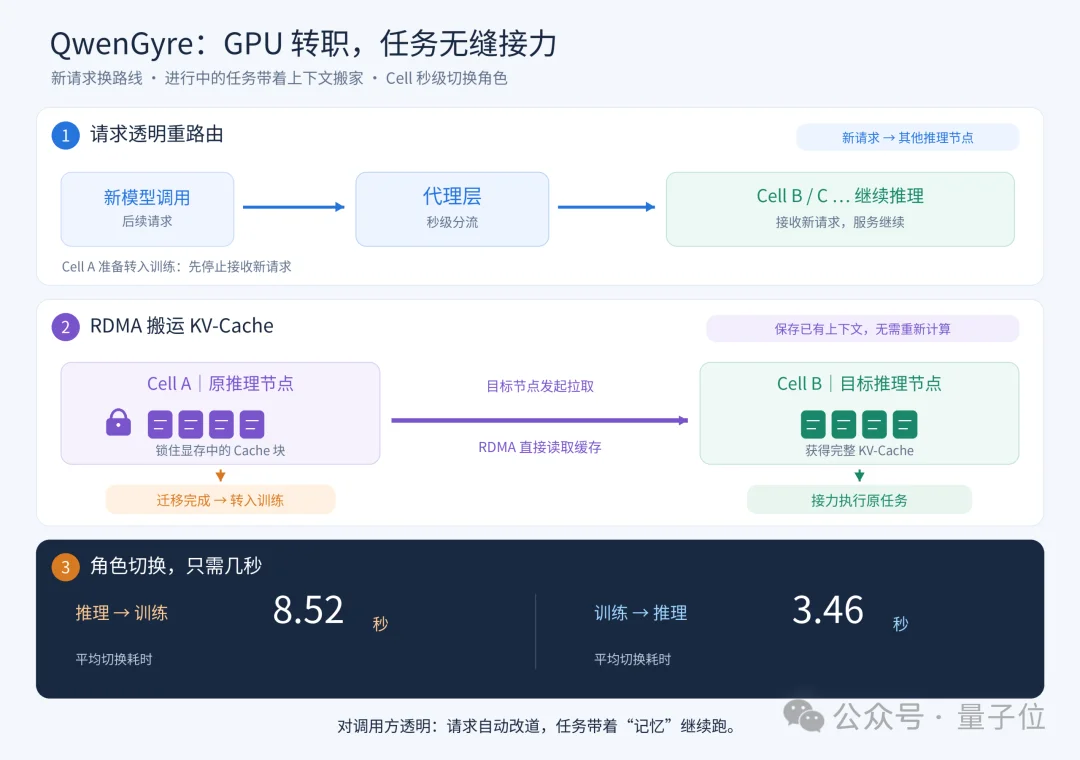
△无损迁移机制,依据论文制图
而且在训练侧,千问团队还搞了流式训练(Streaming Training)。
Core Cell不需要等一个大Batch的所有数据全部集齐,只要手头有做完的数据,直接拉开架势开训。
随后转职过来的Satellite Cell通过Mooncake Transfer Engine可直接拉取权威权重,像拼积木一样动态插队加入训练。
于是,谁算力空闲,谁就从微步队列里认领任务;
大家各干各的,最后在同一个时间点齐刷刷完成参数更新。
这样一来,算力调班便理顺了。
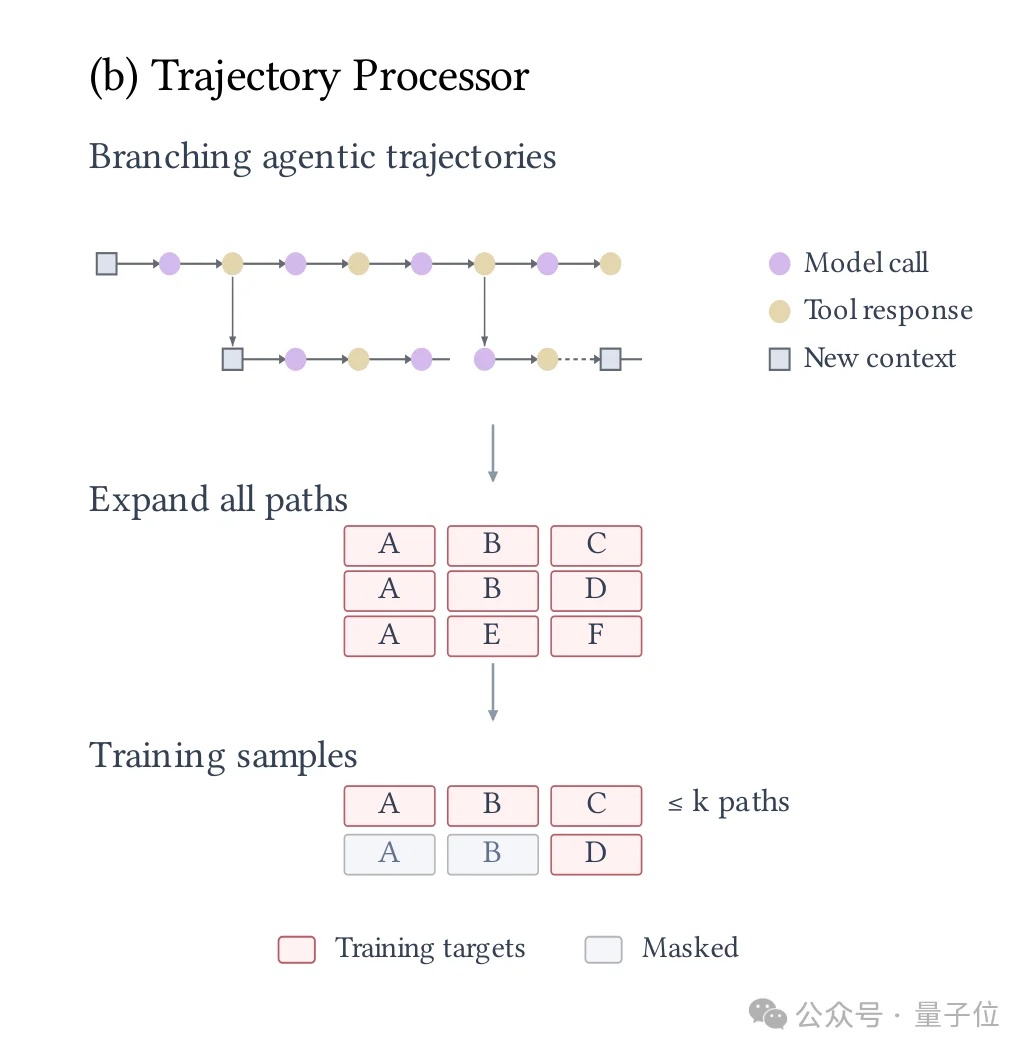
第二步,是理清AI复杂的“实习日志”。
面对AI在几个小时里留下的那棵巨大、错综复杂的分叉轨迹树,QwenGyre做了几道干净的处理:
1、TITO(Token-in Token-out)与前缀树共享:
黑盒代理层精确记录每一次模型调用的原始token与行为概率。
所有分叉路径合并成一棵前缀树,公共前缀只存一份,训练时也只算一次目标损失,绝不重复算账。
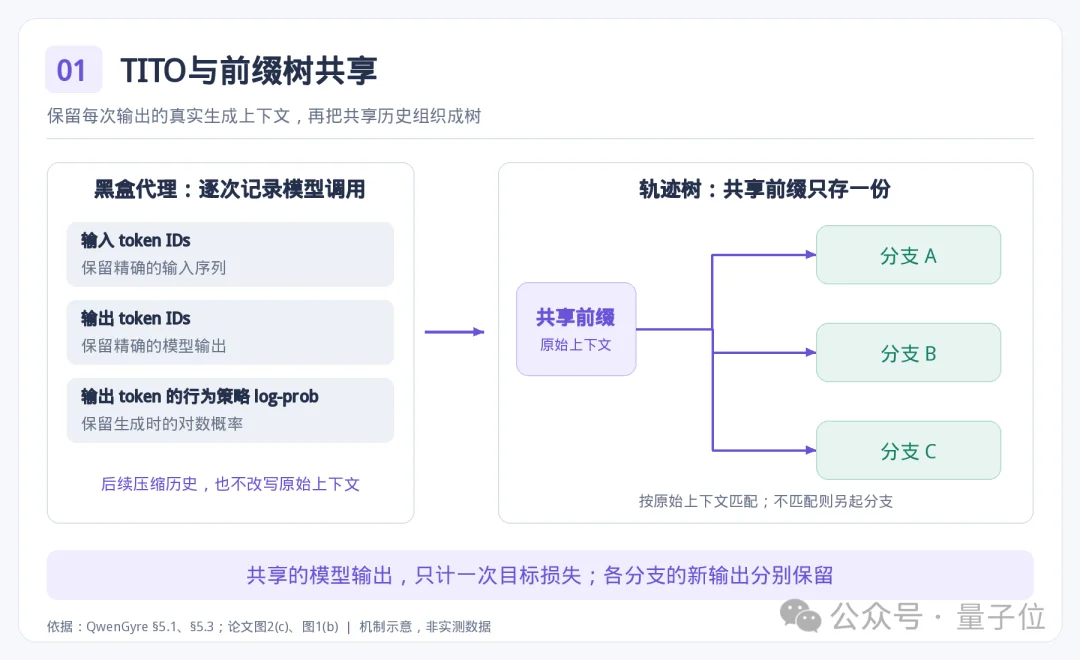
△TITO处理,依据论文制图
2、科学给出“过程分”:
如果AI因为超时没彻底跑通整个项目,评估器(比如独立的Qwen 3.7-Max打分模型或项目单测)会对当前已经生成的代码产物做局部评估,并给出真实的过程分,而不是直接一棍子打死判为0分。
这样一来,中途探索的经验,也能转化有效的训练信号。
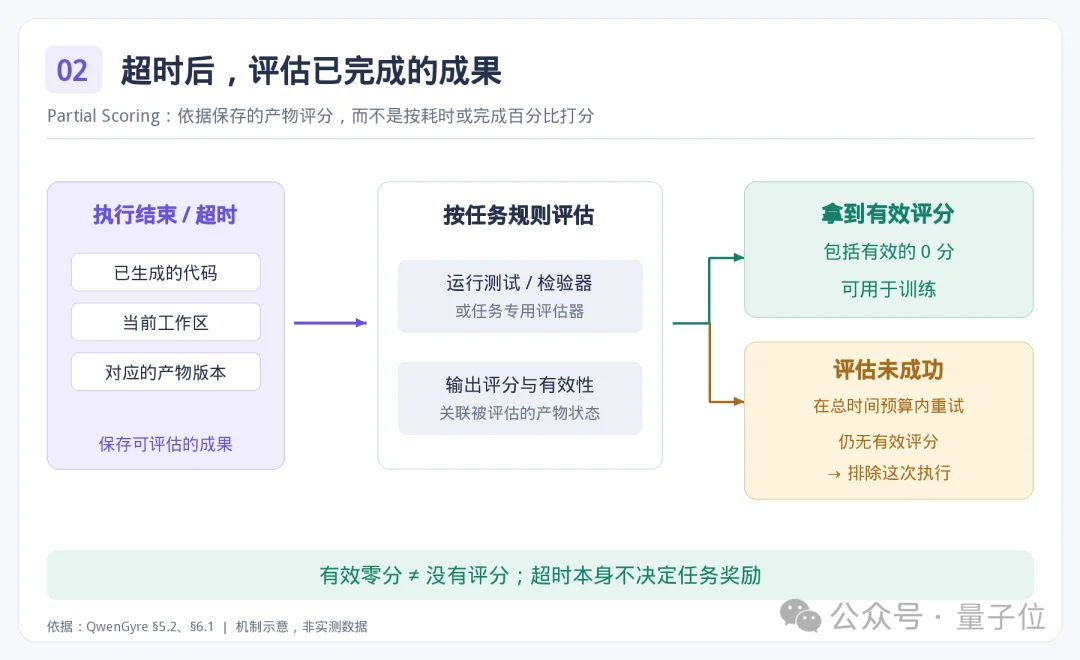
△过程分评估流程,依据论文制图
3、按角色优先级精准采样:
面对庞大的分支,系统也设立了严格的优先级:
主Agent主线>主Agent总结 > 子Agent任务 > 子Agent总结
系统给每个任务设立了一个严格的预算上限(默认最多挑5条轨迹),并优先保证主任务的学习信号,防止边角料子任务反客为主。
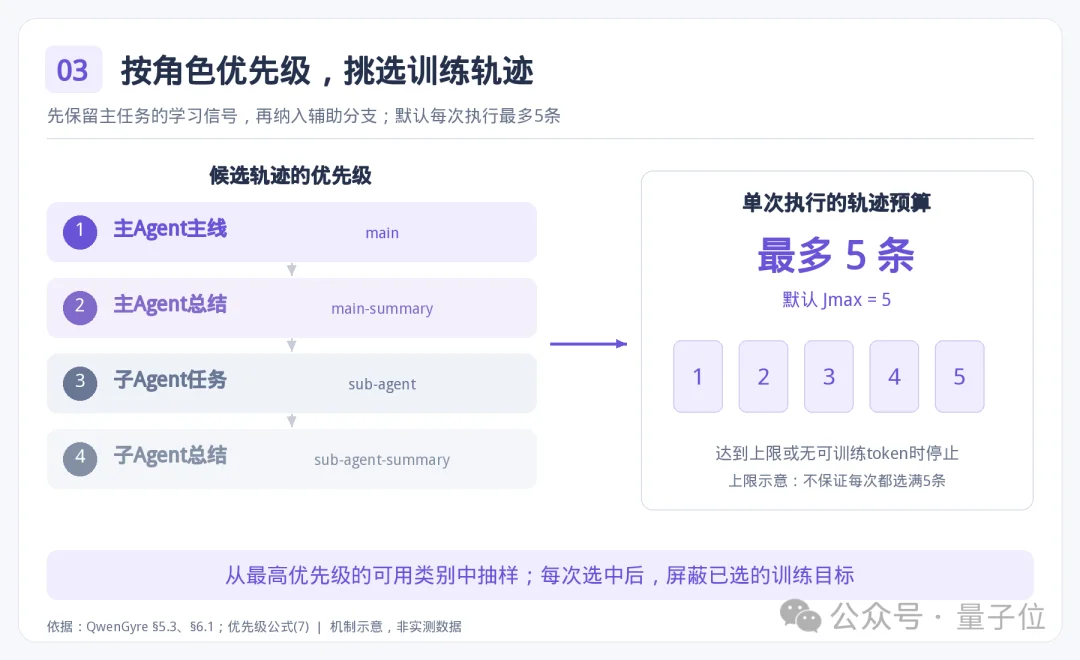
△优先级排序,依据论文制图
4、严格打mask与样本级归一化:
只有模型自己吐出来的token才算loss,系统提示词、工具返回的终端输出全部打上mask。
同时把损失在任务内部做平均,杜绝了“谁分叉多谁权重就大”的偏置问题。
△整套流程,图源论文
这两套组合拳打下来,模型的排班便更加灵活了,复盘也更利索了。
但架构搭得再漂亮,最终还是要看实战演练。
接下来,就让咱们一起来扒扒看,它的实际战果如何。
少花近60小时,AI学得怎么样?
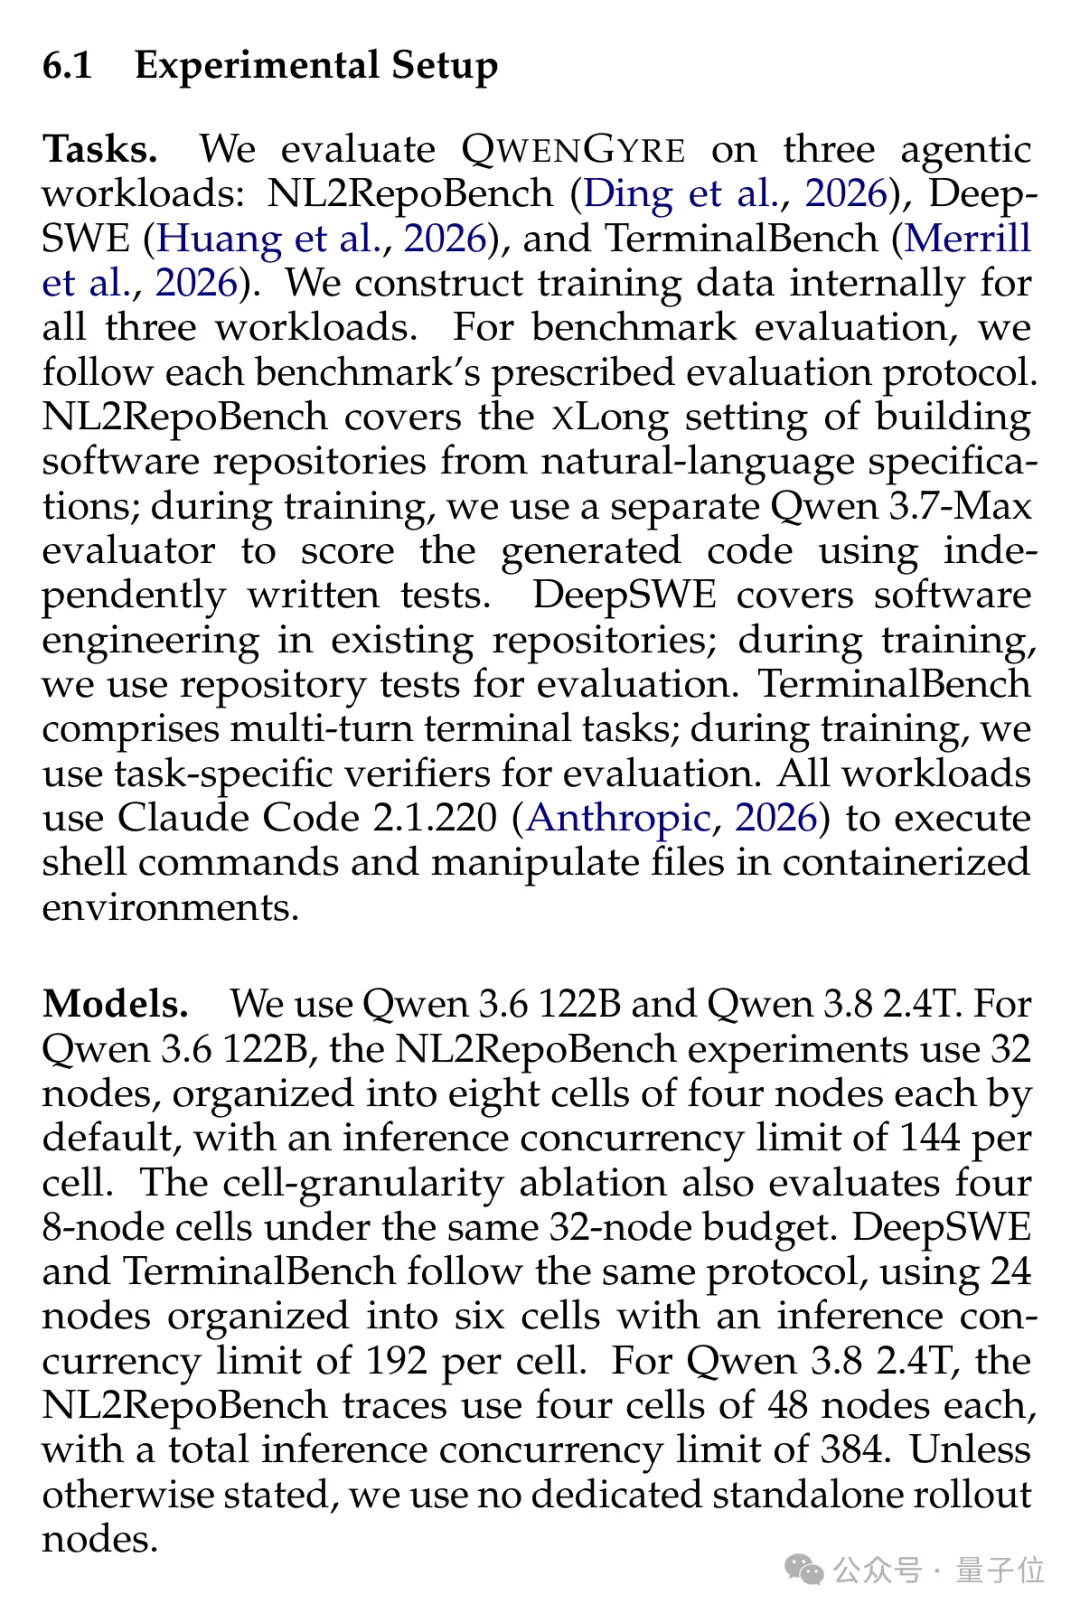
除了在Qwen 3.6 122B上做了详尽的消融对比外,千问团队还把这套方案直接推到了旗舰模型Qwen 3.8 2.4T上。
整体评测任务选的也是业内公认最难啃的代码生成与工程基准:NL2RepoBench(根据自然语言需求从零搭建整个代码库)、DeepSWE以及TerminalBench。
而底层的Agent外壳,则统一使用的是Claude Code 2.1.220。
在Qwen 3.8 2.4T上跑NL2RepoBench时,超长任务的残酷性展现得淋漓尽致:
有超过61.1%的查询任务耗时在4小时以上,最长任务超时率高达38.2%。