


对于现有的AI智能体,能否在有限候选方案里快速、准确地给出决策,直接影响任务的完成情况。
TypeSafe的Jev正是在这样的需求下受到关注:它让模型面对给定选项直接给出结构化决策,把“快速选择”变成一种可以被程序调用的能力。
但要让这种“直觉”走出文本、进入真实场景,模型还必须看懂图像和不断变化的界面。
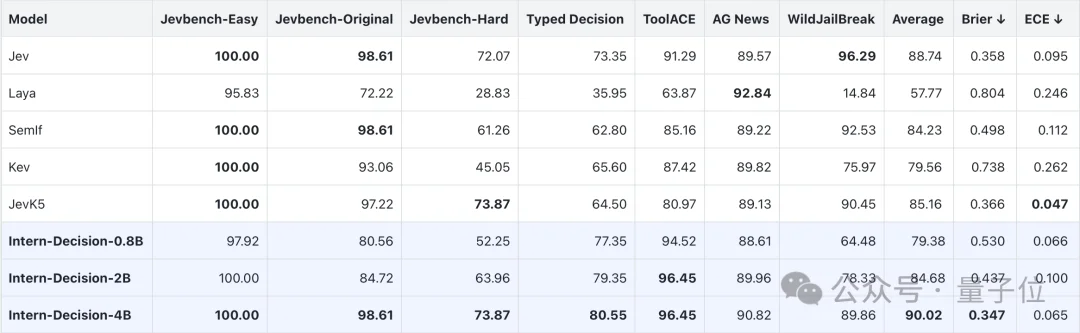
基于这一认识,来自上海人工智能实验室的研究团队构建了性能超越Jev和目前所有相关开源模型的多模态决策SOTA模型Intern-Decision,探索如何结合视觉理解与指令遵循,让模型快速作出判断,同时兼顾决策效果。
Intern-Decision将这种决策建模为“自回归式掩码语言任务”(Autoregressive Masked Language Modeling),充分利用现有LLM的Next-Token Prediction能力,达到一步Prefilling即可获得全部问题结果的效果。
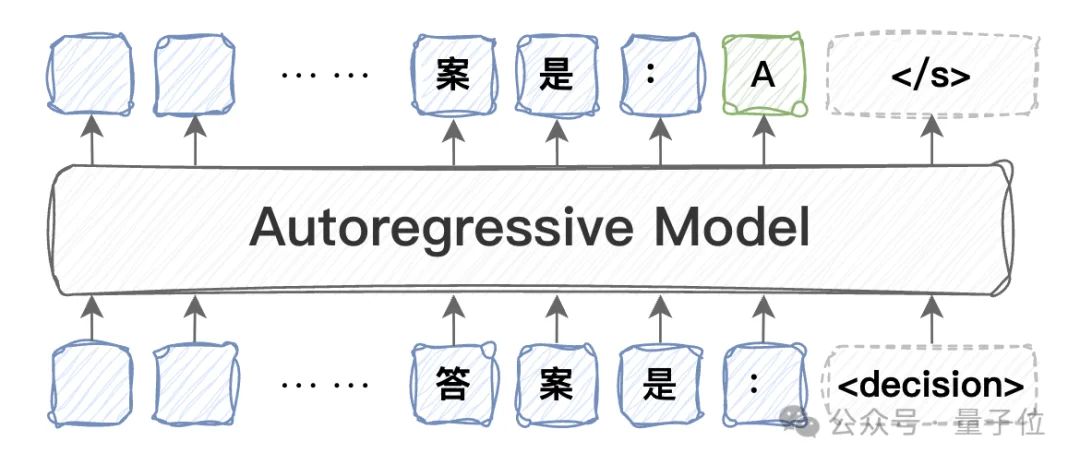
在此基础上,团队构建了一套面向实时结构化决策的数据体系。从决策场景中抽象出多类结构化任务,定向构造高难度决策样本并融合公开语料。通过这两类数据,模型既能学习通用快速分类,也能学习真实业务和复杂文本中的决策边界。
平均指标超越Jev
每秒30次决策的快速响应
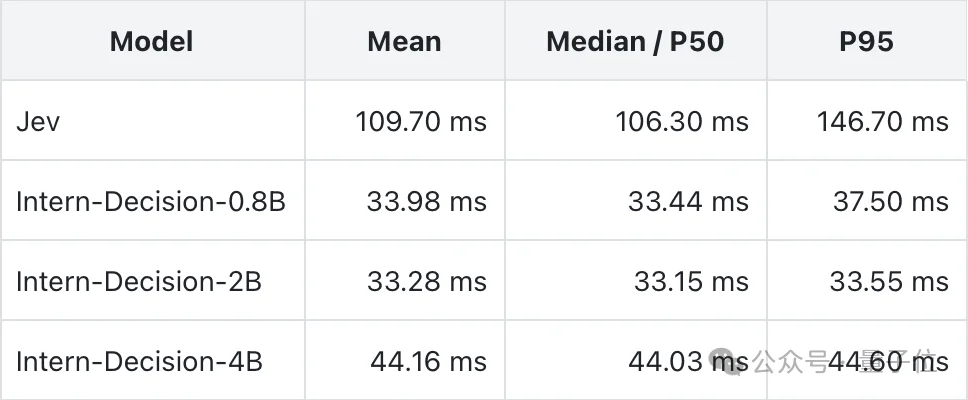
为了尽可能贴近用户需求,团队在RTX4090上进行了Intern-Decision的推理速度测试。结果显示Intern-Decision相较于Jev而言有2-3倍的效率提升,4B模型的端到端推理时延可以被缩短至每query45ms以下,而0.8B和2B的推理效率基本保持一致。
0.8B和2B模型可以达到每秒约30次推理,几乎可以在绝大多数场景实现“实时”决策效果,这大大拓展了模型的使用场景。
从“答对”到“知道自己有多大把握”
大模型在决策任务中,输出一个正确选项只是第一步。对于医疗判断、风险控制、智能客服和安全审核等场景,系统还需要知道:自己有多大把握?当答案存在不确定性时,模型能否给出合理的概率分布?
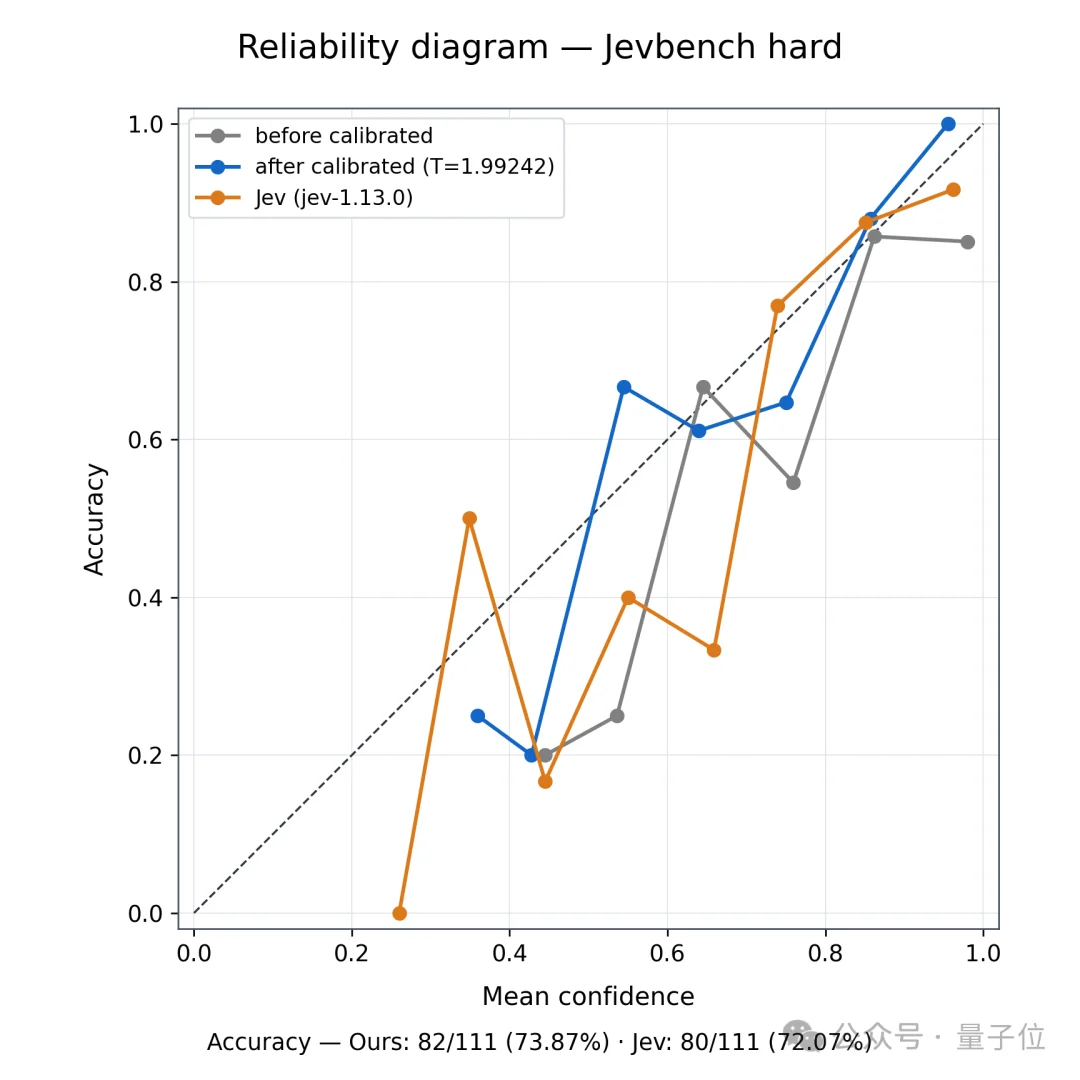
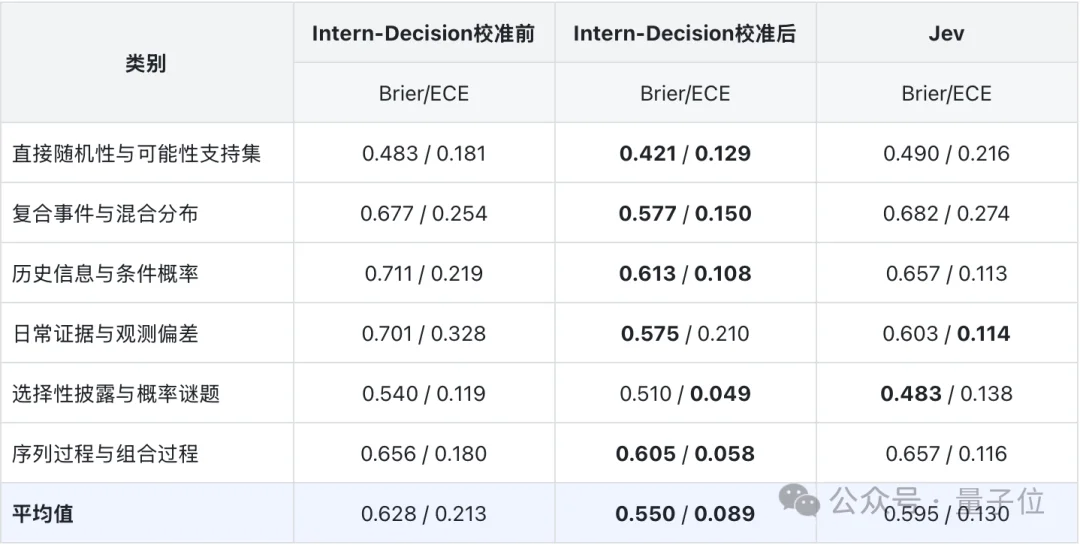
围绕这一问题,Intern-Decision对模型进行了温度校准。结果显示,经过校准后,Intern-Decision的整体Brier从0.628降至0.550,ECE从0.213降至0.089。
图中展示的是JevBench-hard上的可靠性分析。校准前的Intern-Decision在高置信度区域存在明显偏差:模型经常给出接近0.9或1.0的置信度,但实际准确率没有同步达到这一水平。
经过温度校准后,蓝色曲线整体更接近对角线,说明模型的置信度与真实准确率之间的偏差明显减小。Jev的曲线在部分区间表现较好,但在中低置信度区间仍然存在较明显的波动。
为了评估模型是否真正理解“不确定性”,团队构建了专用的选项概率分布评测集,覆盖直接随机性、混合分布、条件概率、观测偏差、概率谜题和序列过程六类场景,并为每道题提供精确的参考分布。
结果显示,Intern-Decision校准后整体Brier从0.628降至0.550,ECE从0.213降至0.089,均优于Jev的0.595/0.130。
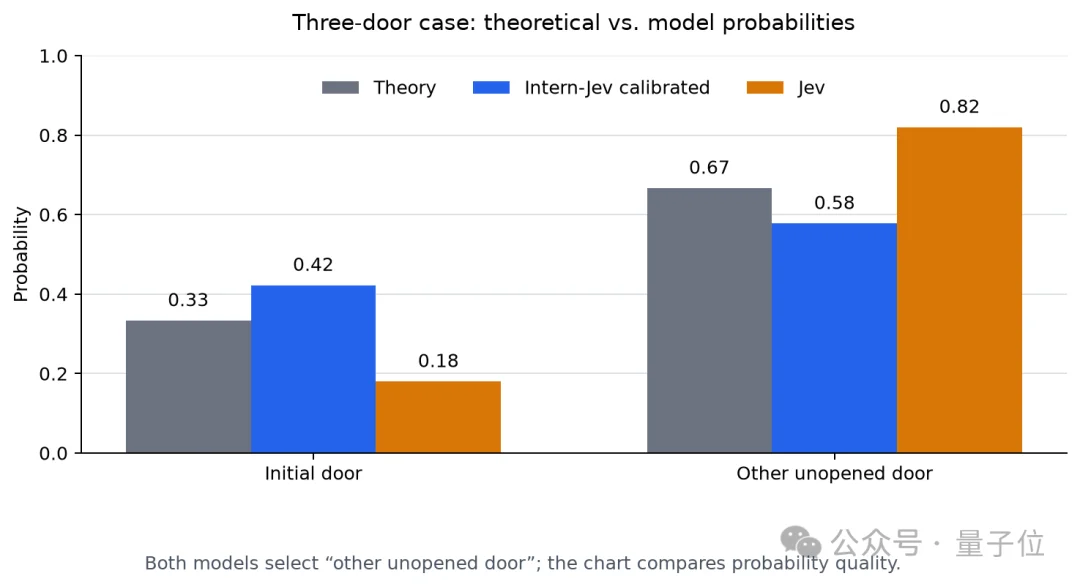
以经典的“三门问题”举例,当提问“剩余的两扇门里哪个藏着奖品”时,经过校准后的Intern-Decision概率分布更接近真实值。
拿不准,就交给大模型
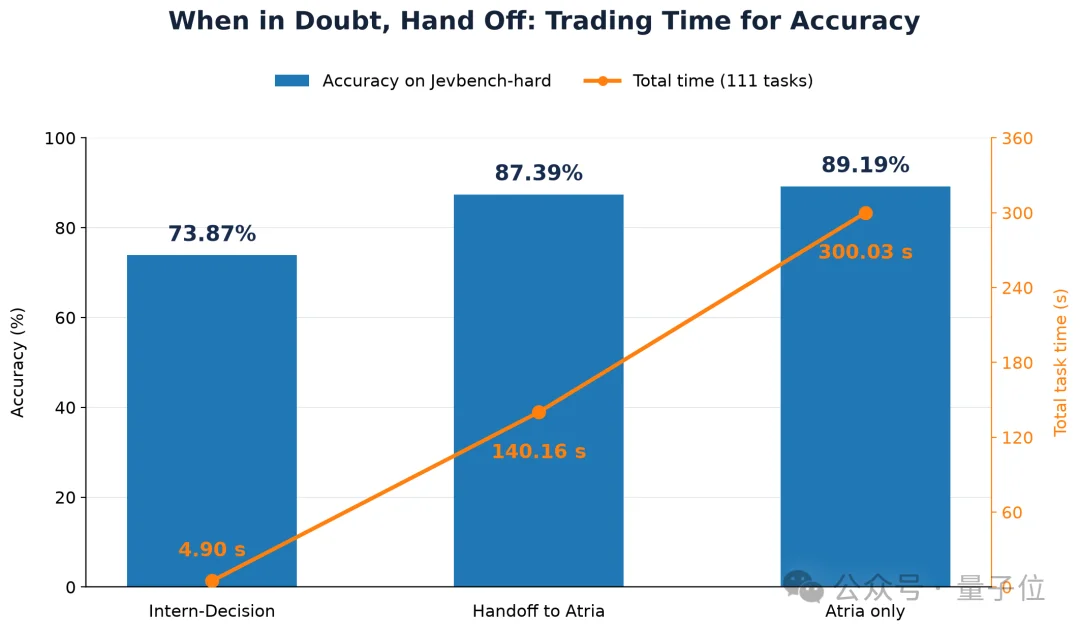
在Jevbench-hard的111道题上,Intern-Decision独立作答的准确率达到73.87%(82/111)。这款4B模型部署在单张RTX4090上,平均每次判断仅需44.16ms,完成整套任务只需4.90秒。
如果愿意多等一会儿,准确率还能进一步提升。如果根据置信度将拿不准的42道题交给Atria-Dawn-Preview处理,最终准确率升至87.39%(97/111)。相应地,整套任务总耗时估算为140.16秒。
相比之下,全部交给Atria的准确率为89.19%(99/111),实测总耗时为300.03秒。在本次测试配置下,接管方案仅少答对两道题,却将总耗时缩短约53.3%。
这正是大小模型协作的价值:追求速度时,让小模型快速作答;需要更高精度时,通过置信度把不确定的问题交给大模型,用额外时间换取更可靠的判断。
看懂游戏画面,做出连续动作决策
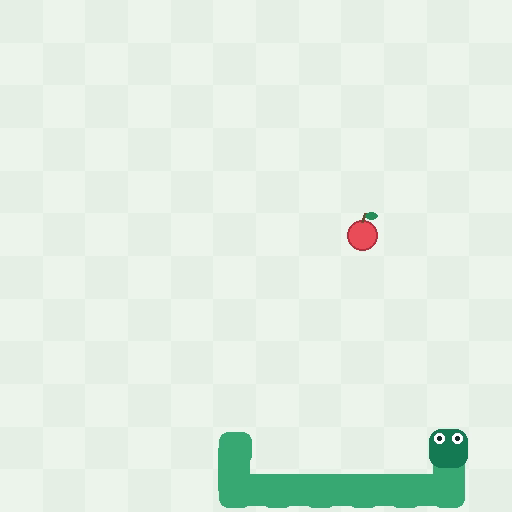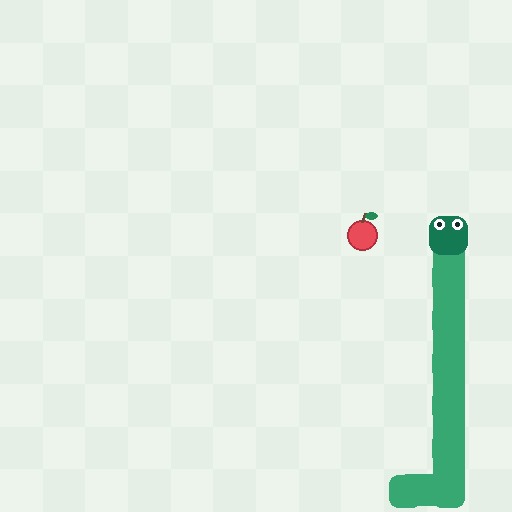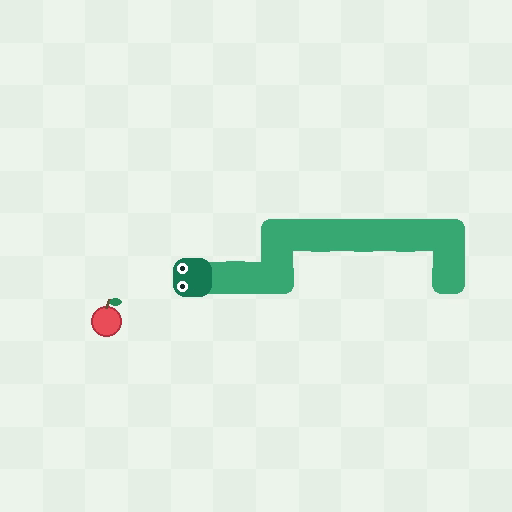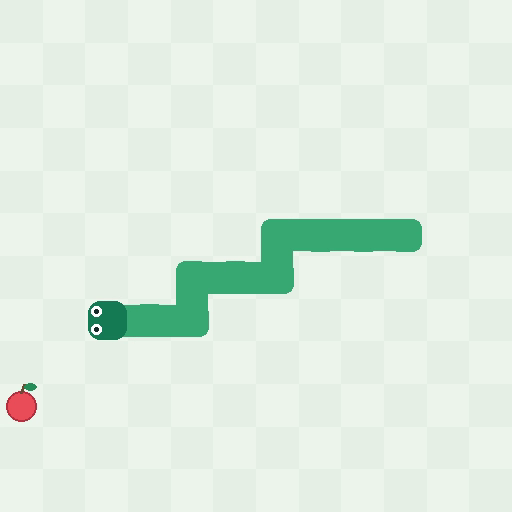
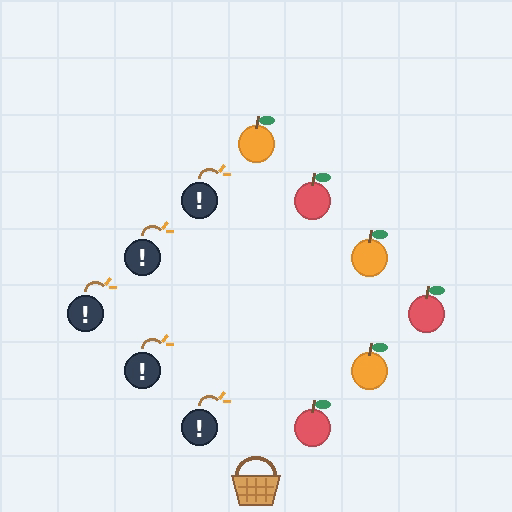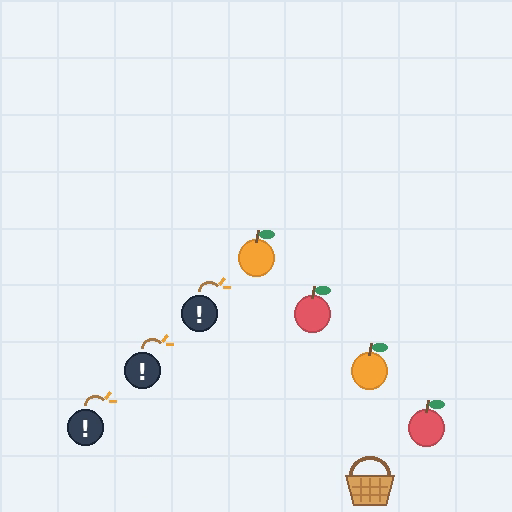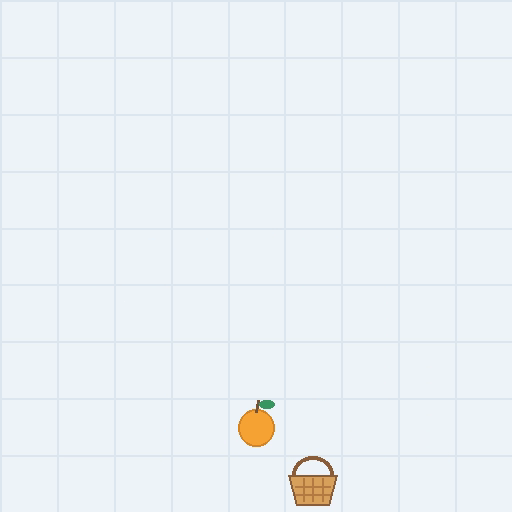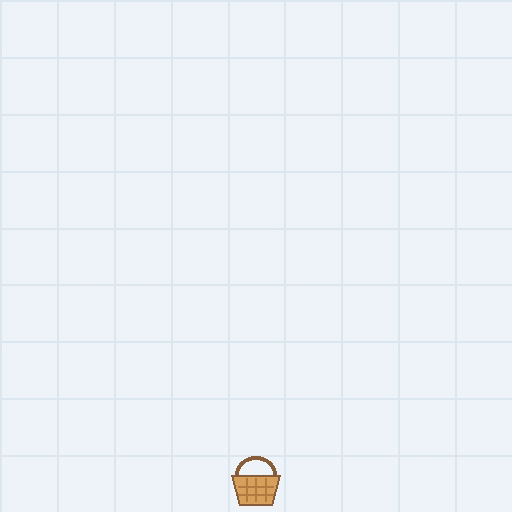
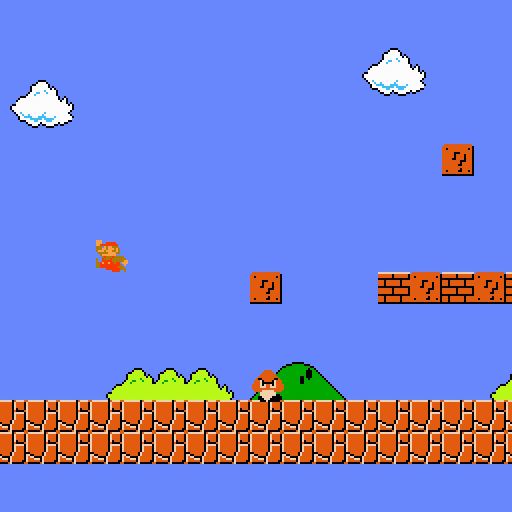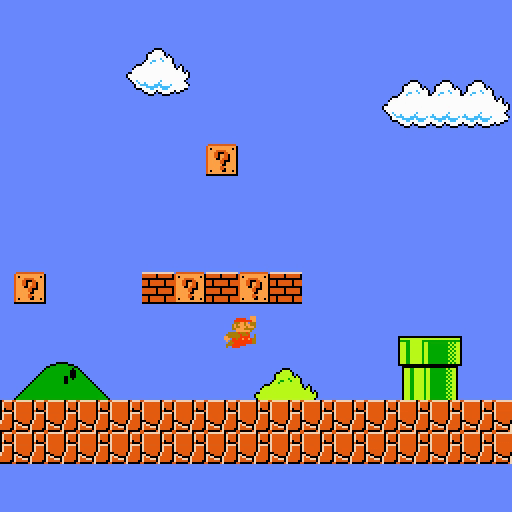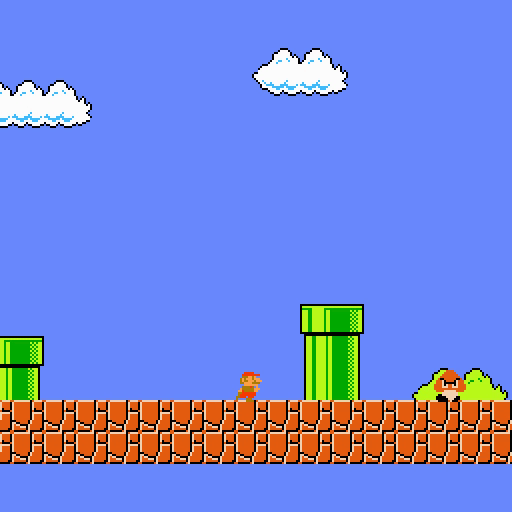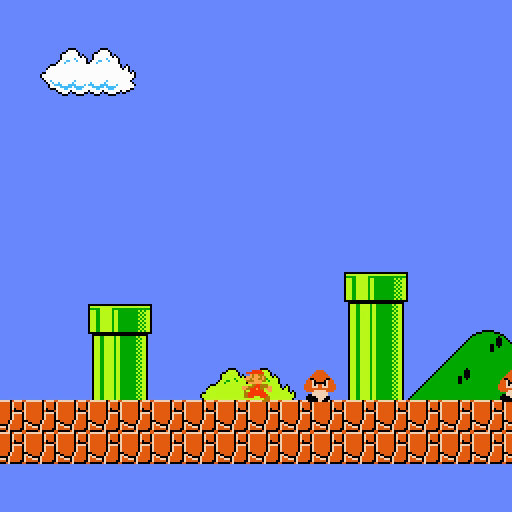
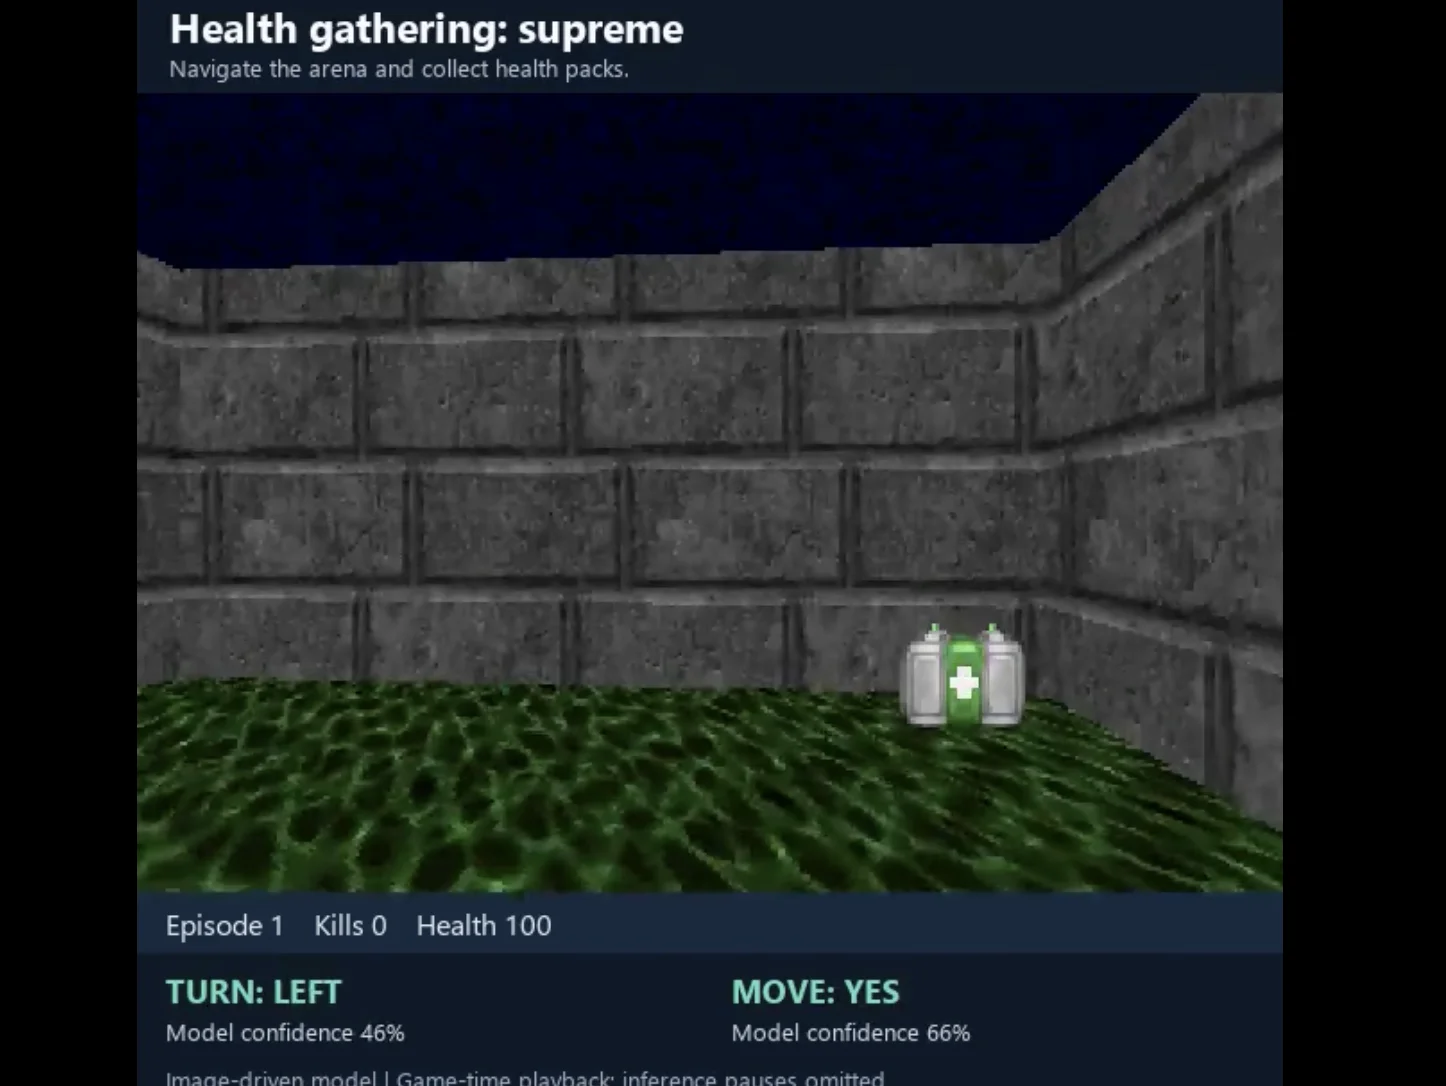
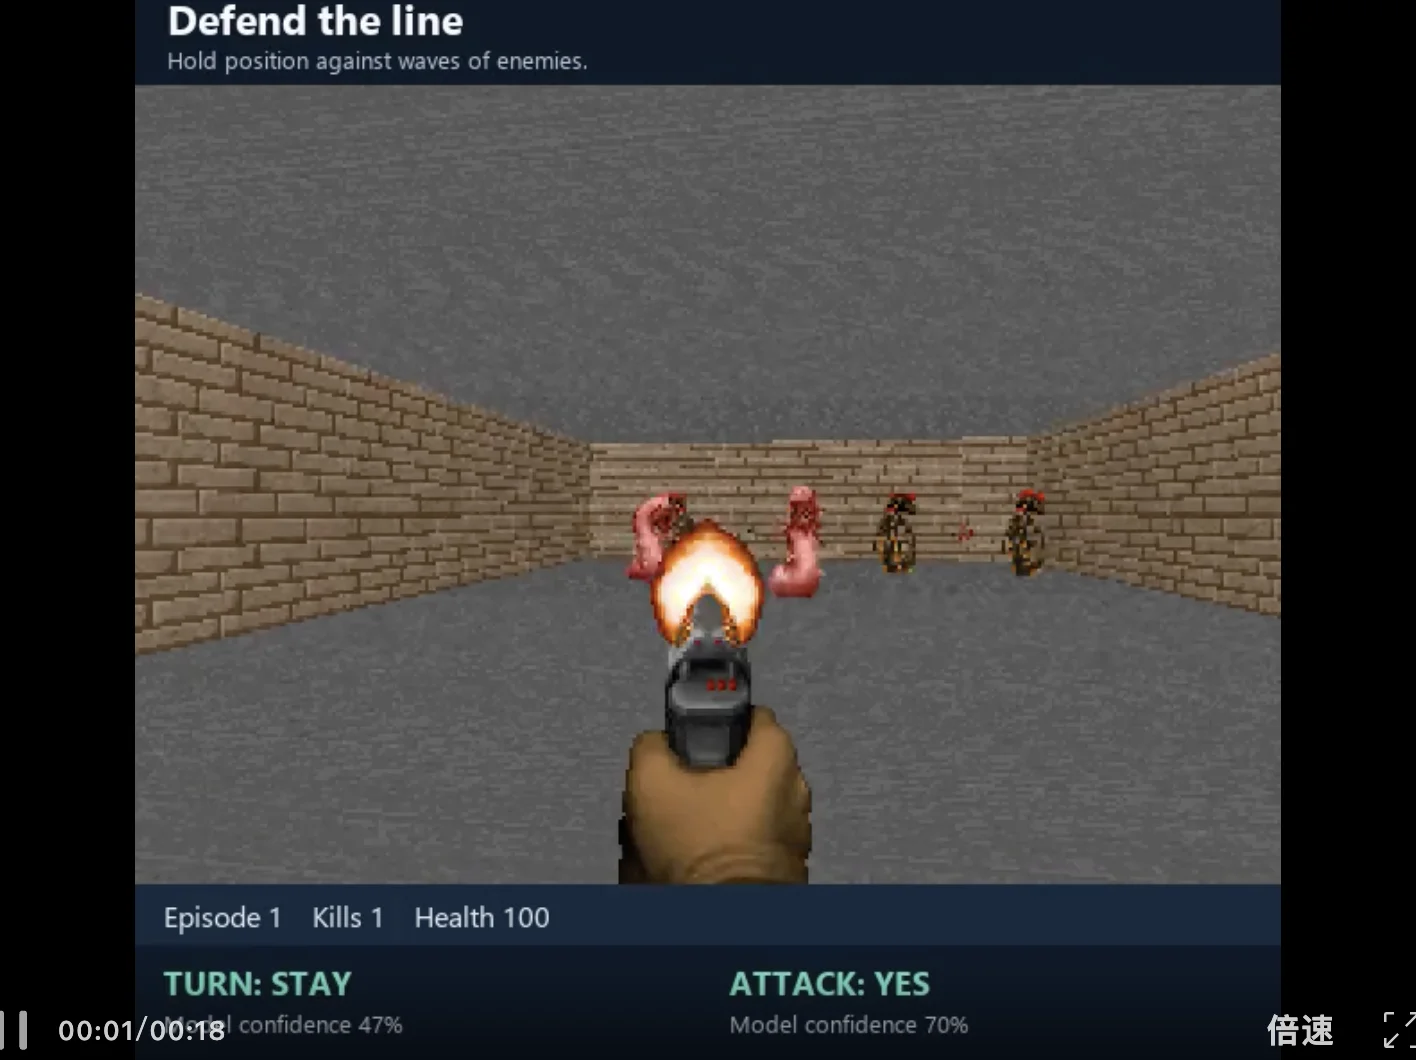
游戏任务要求模型将视觉感知与动作选择结合起来。和Jev读取游戏状态不同,Intern-Decision可以直接读取游戏画面,并做出相关动作,例如在贪吃蛇中寻找食物、避开自身,在接水果时区分水果与炸弹,在超级马里奥中选择移动和跳跃,并在两个第一人称游戏任务中寻找生命补给或射击来袭敌人。模型需要根据不断变化的画面判断当前局势,将这些判断转化为可执行的离散动作。
这五个演示覆盖了二维网格、横版平台和第一人称三维场景。不同任务分别强调路径选择、目标与危险物识别、跳跃时机和空间方向判断,展示了Intern-Decision将画面理解转化为连续交互行为的能力,也为研究多模态模型在动态环境中的动作决策提供了直观的实验场景。
有趣的是,团队还发现Intern-Decision在这些游戏中出现了一些探索性行为,比如Doom的Health Gathering场景中,角色触墙之后会选择晃动镜头以尝试发现新的目标。
移动鼠标通过图案验证码
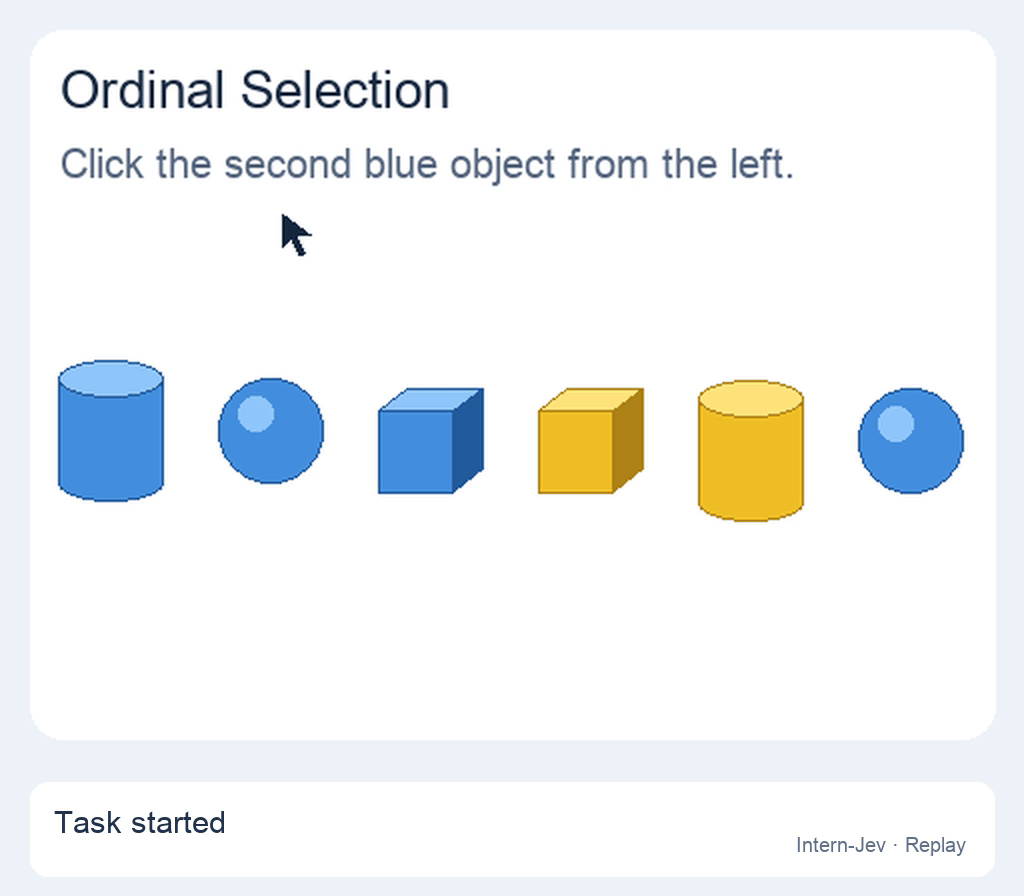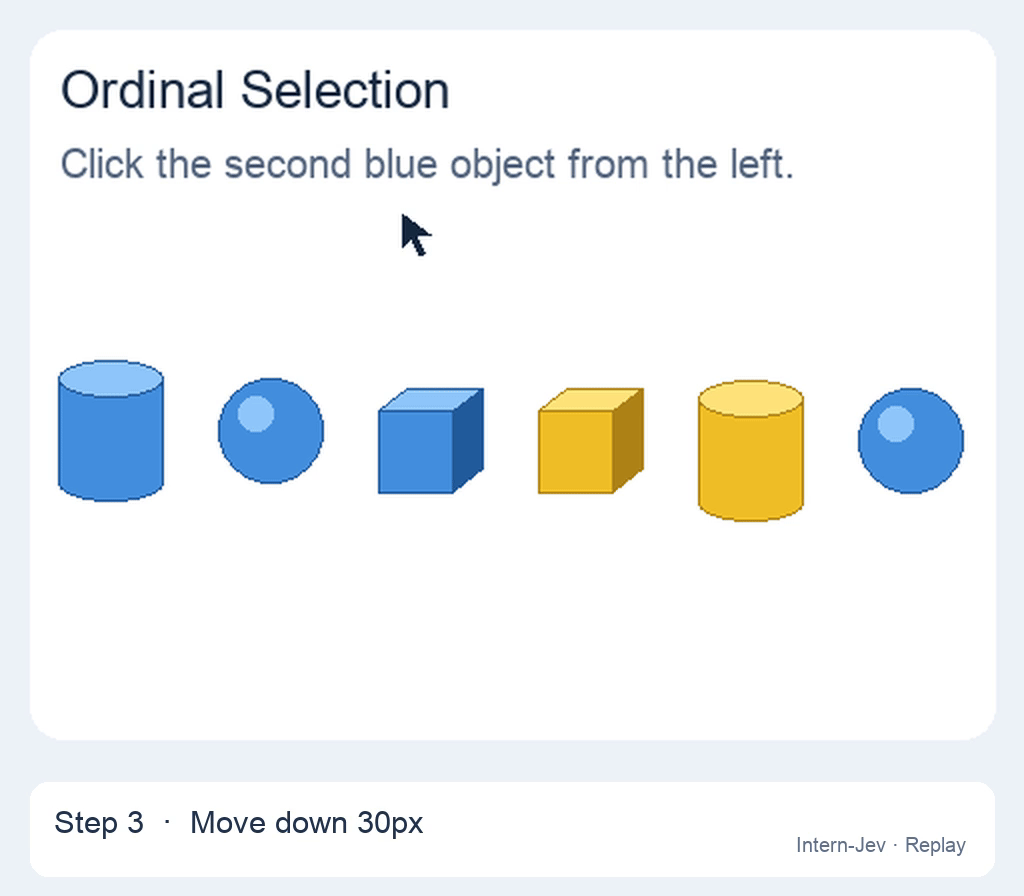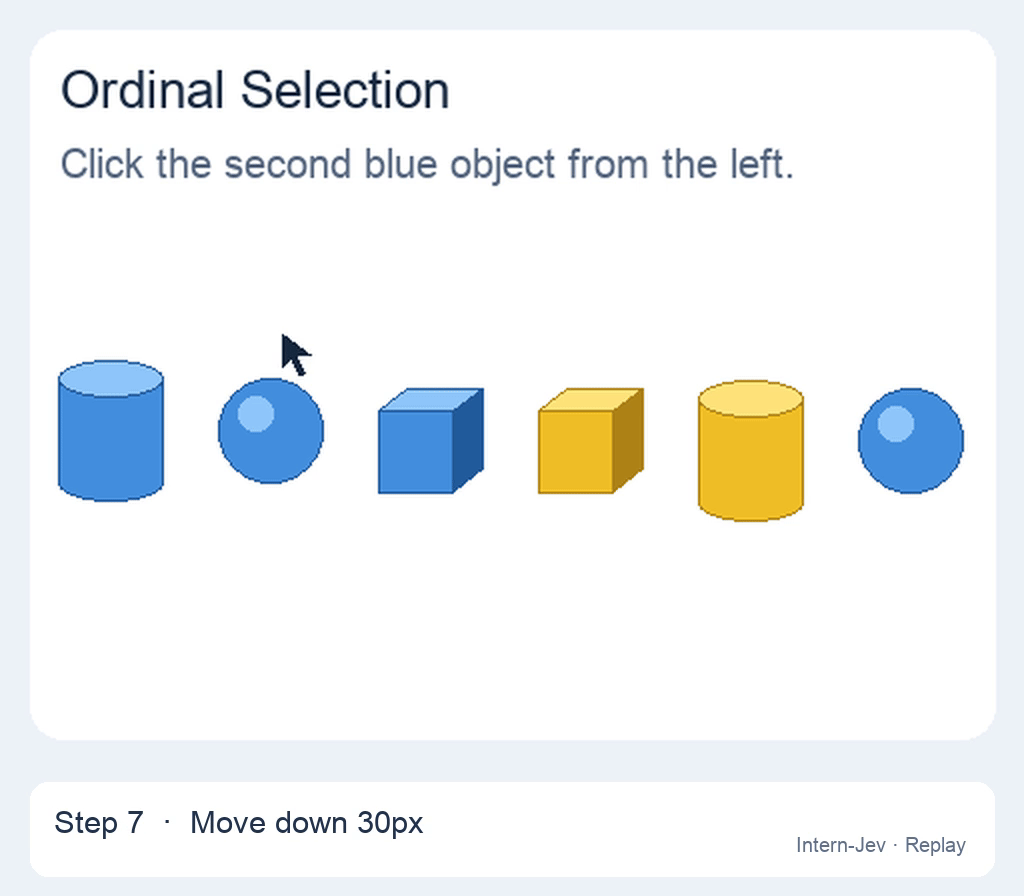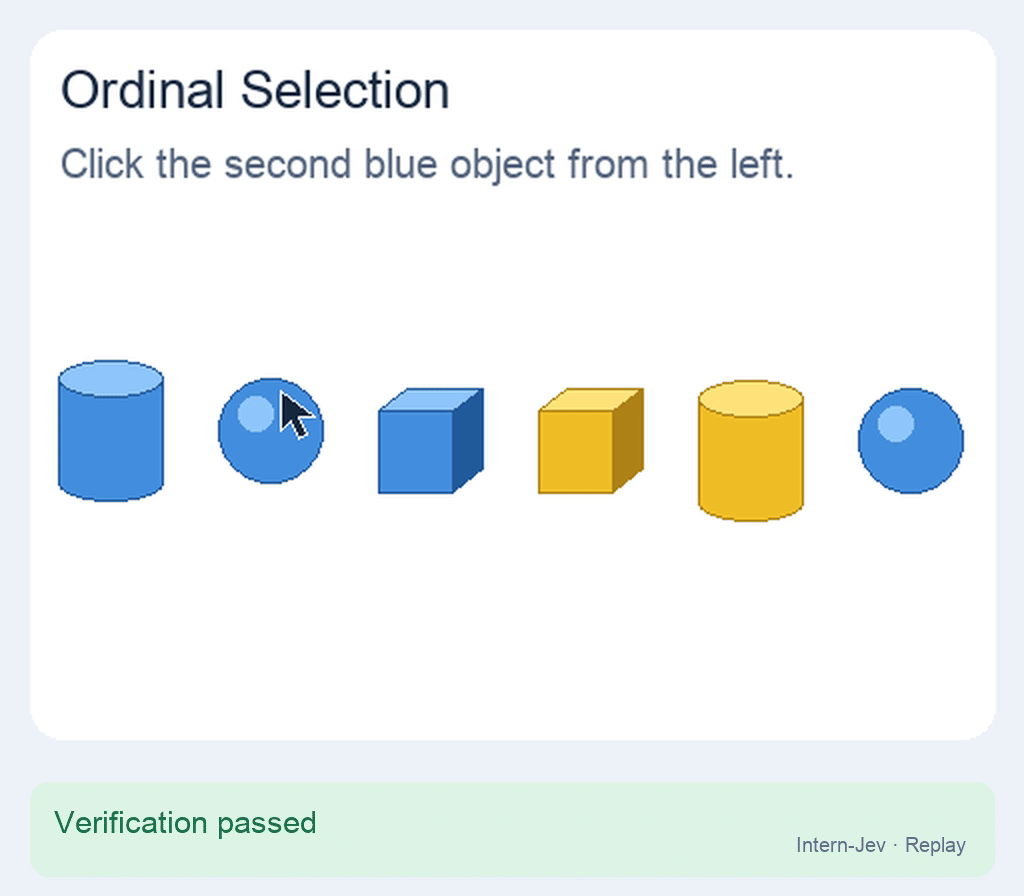
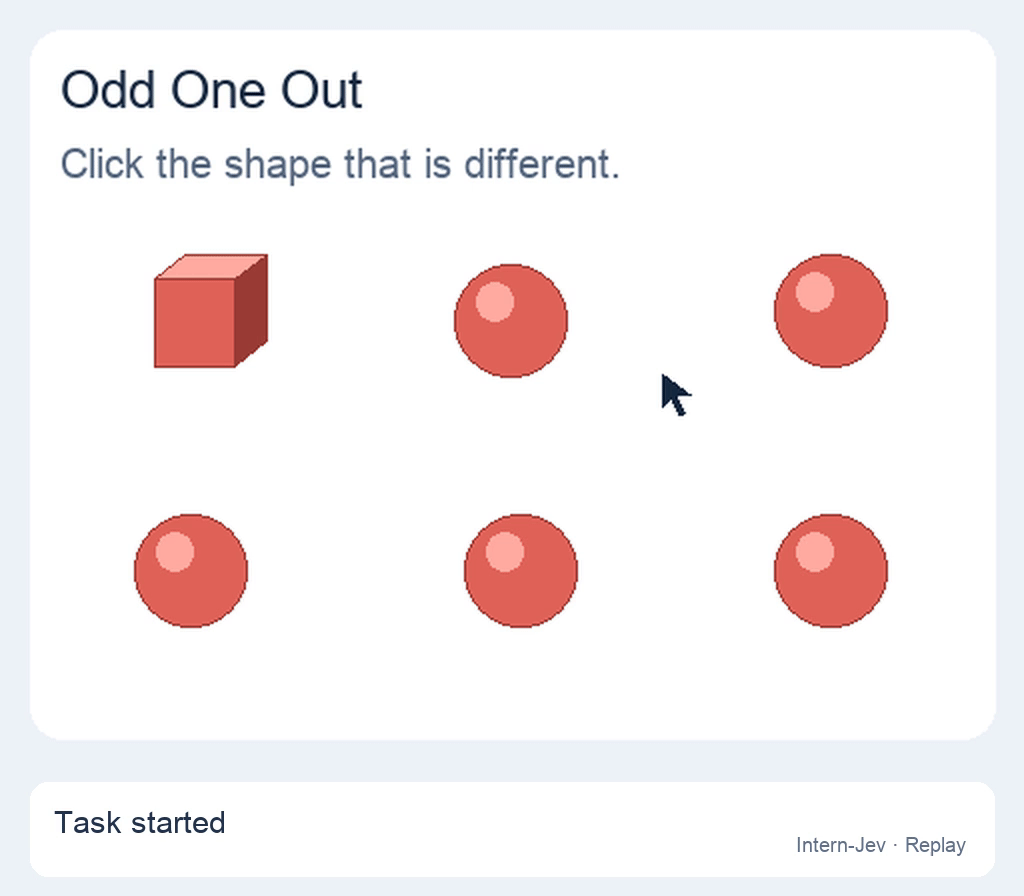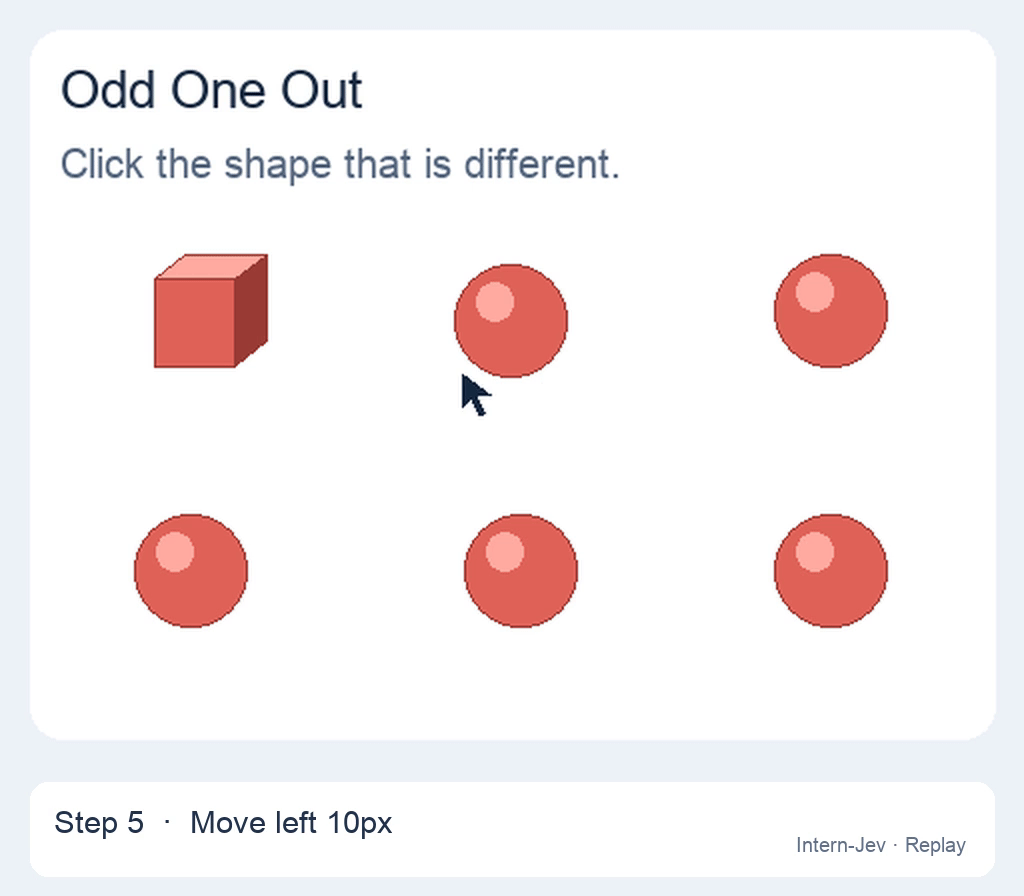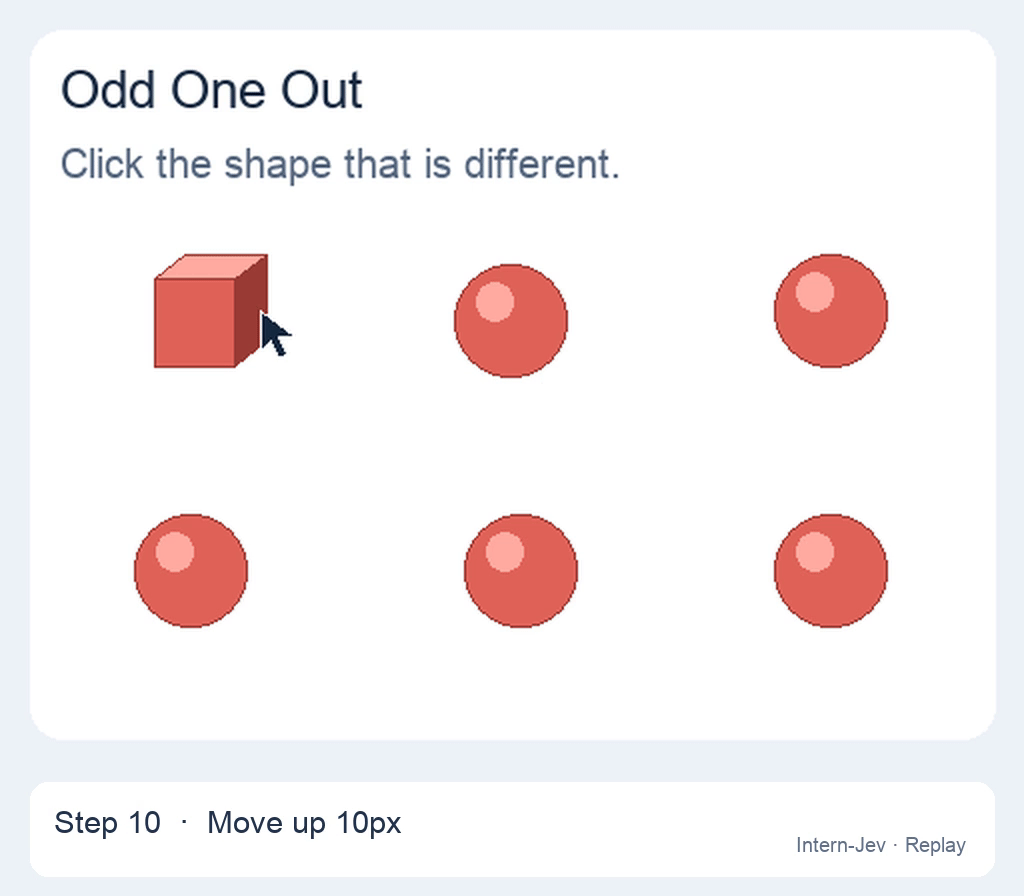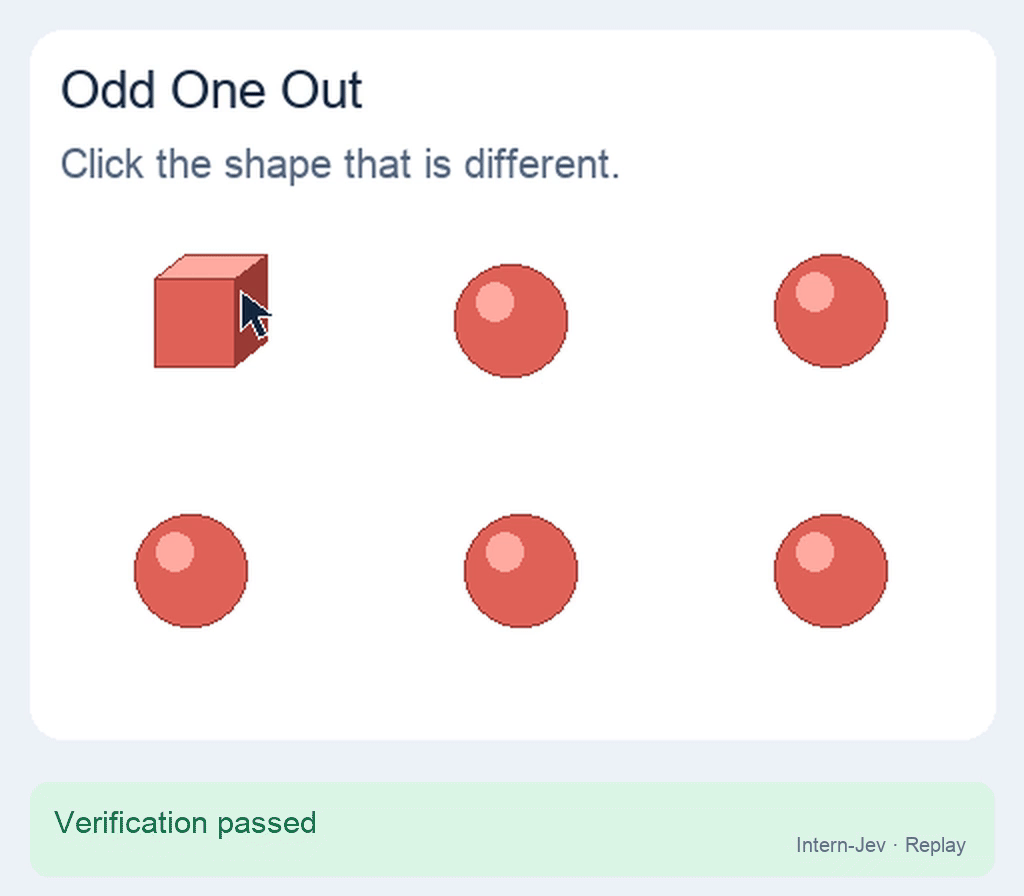
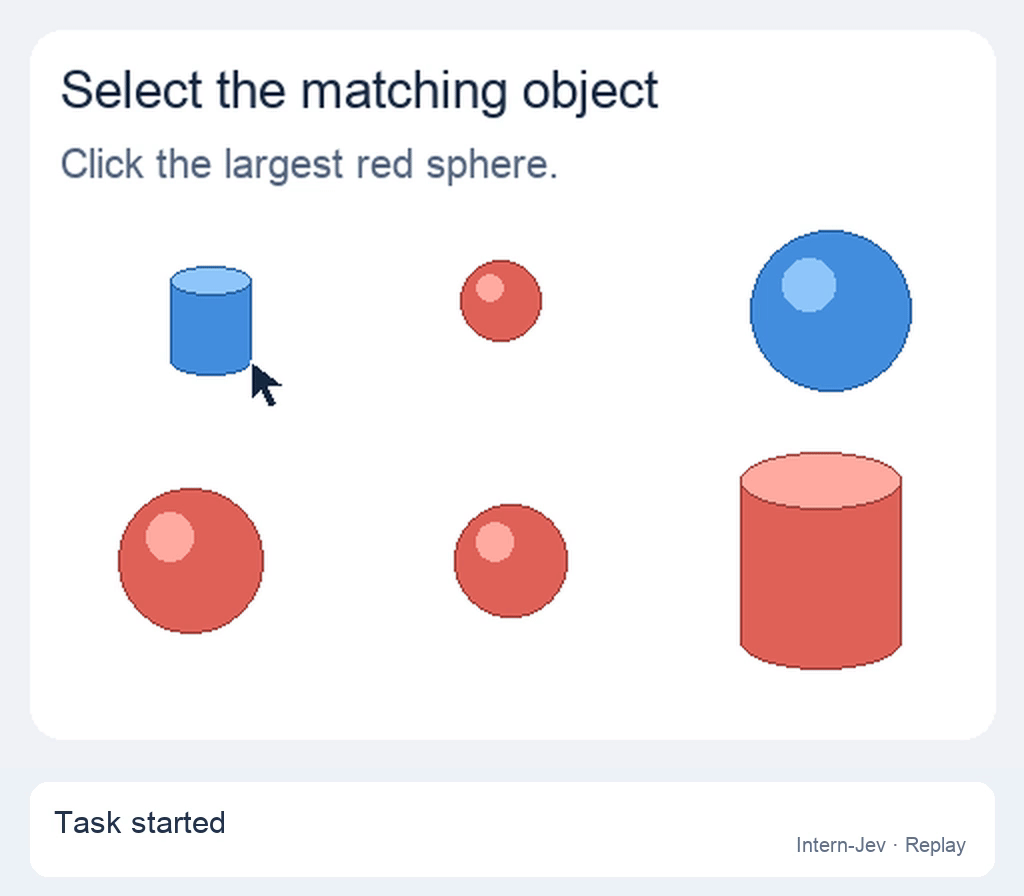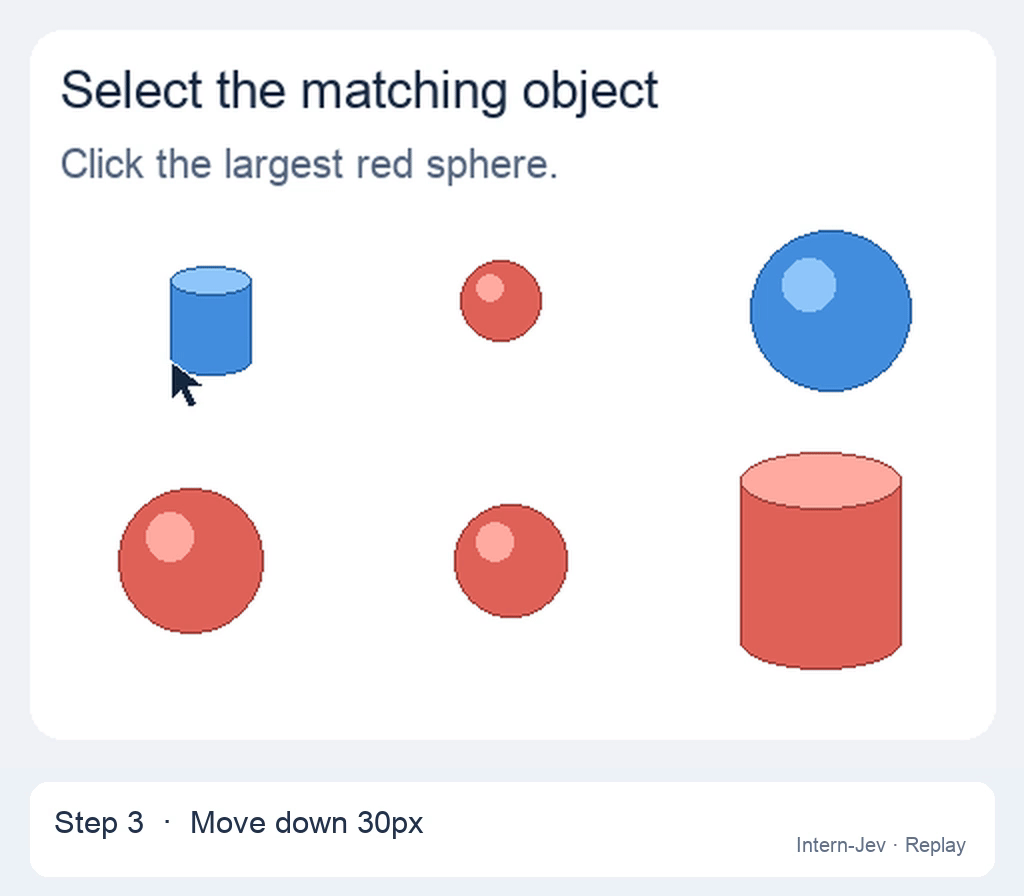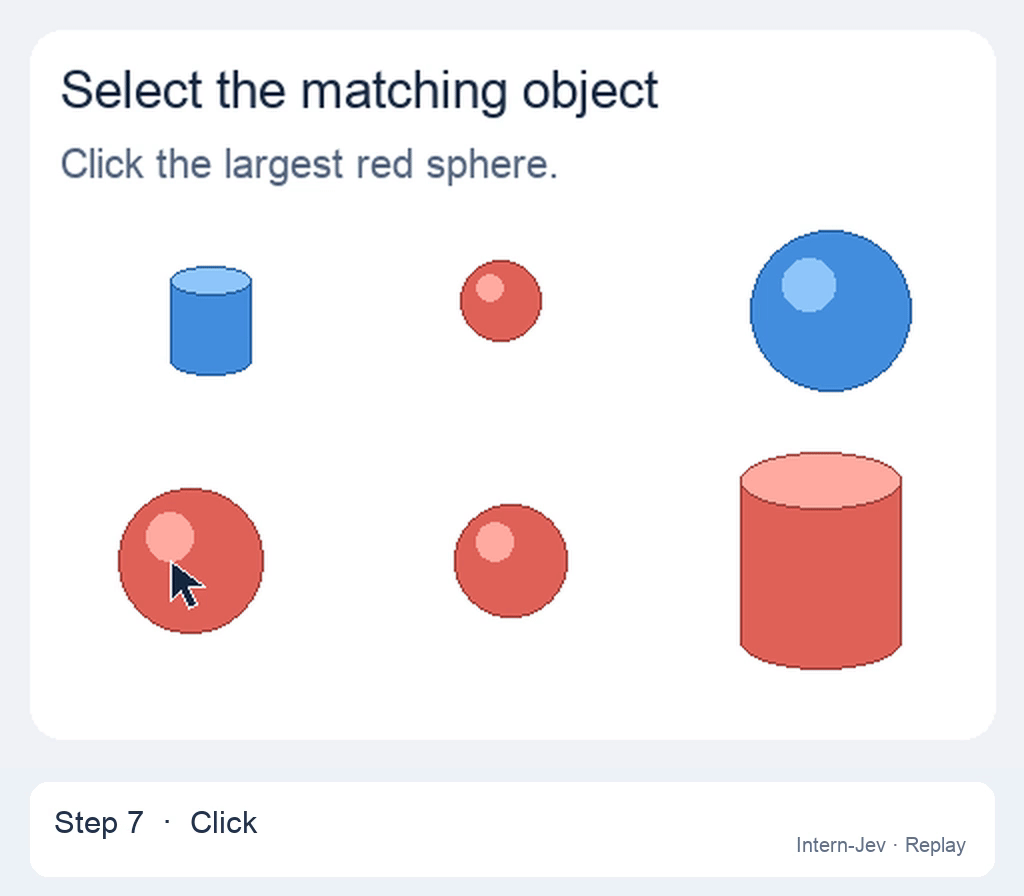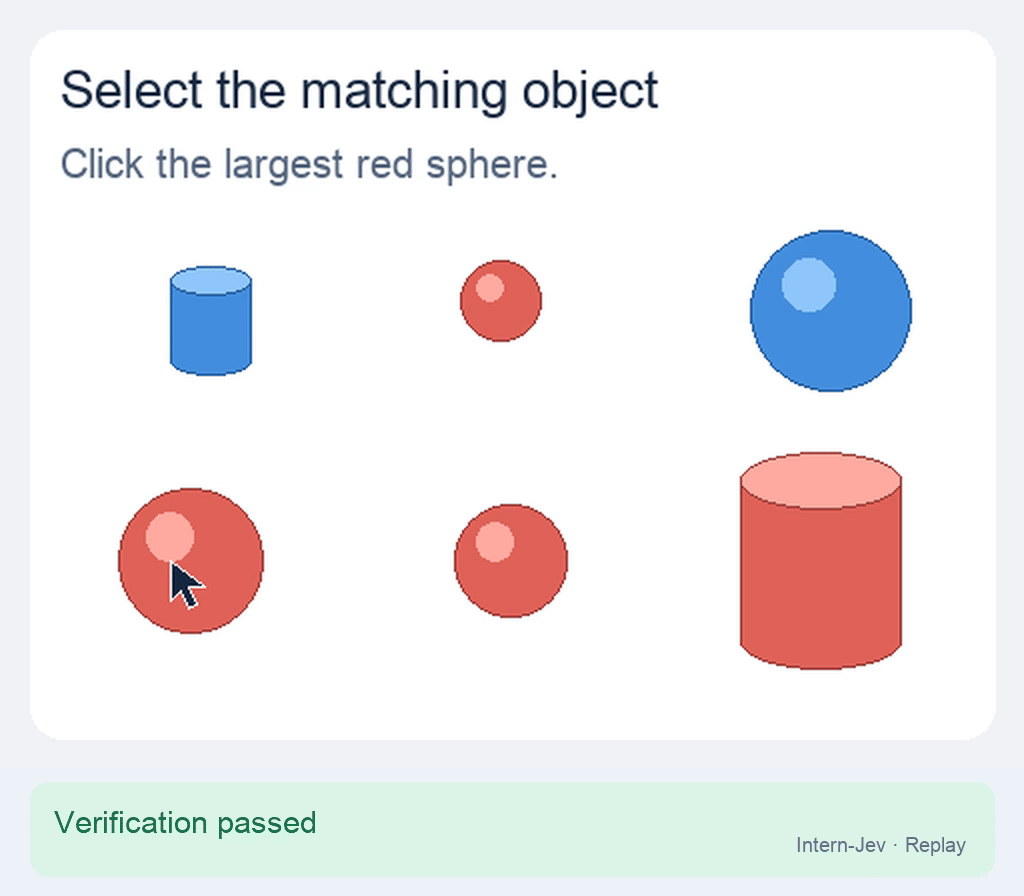
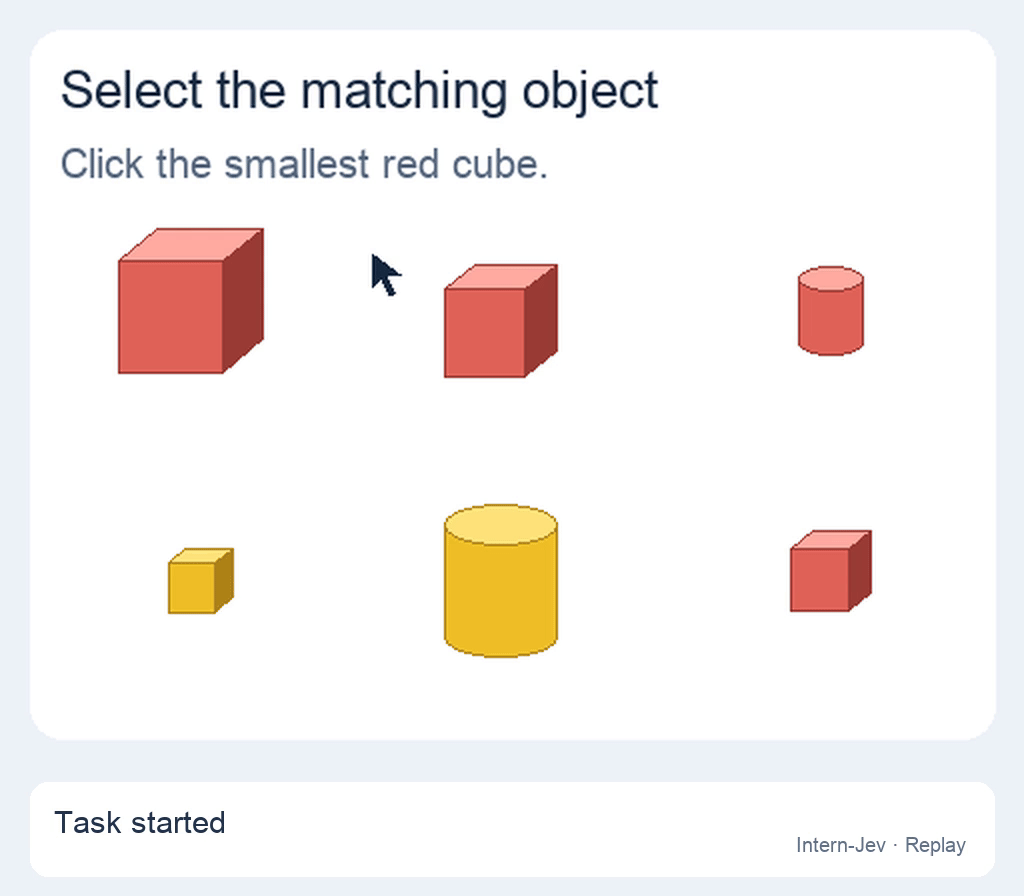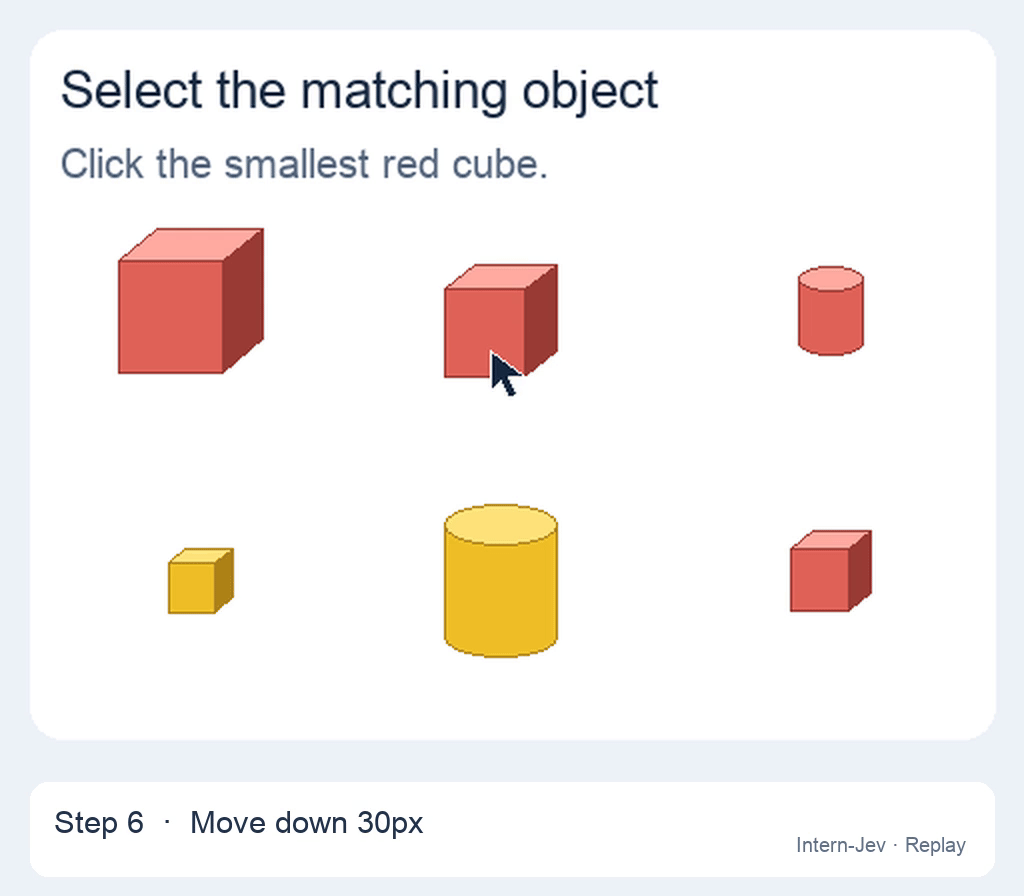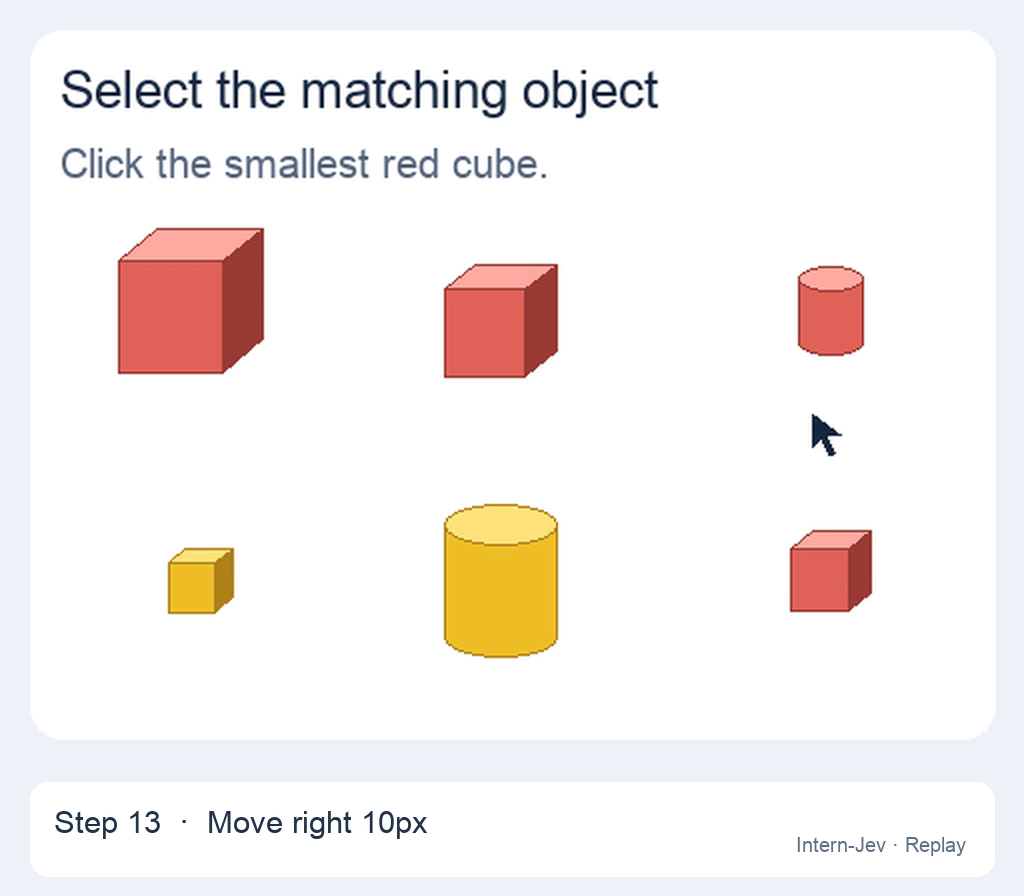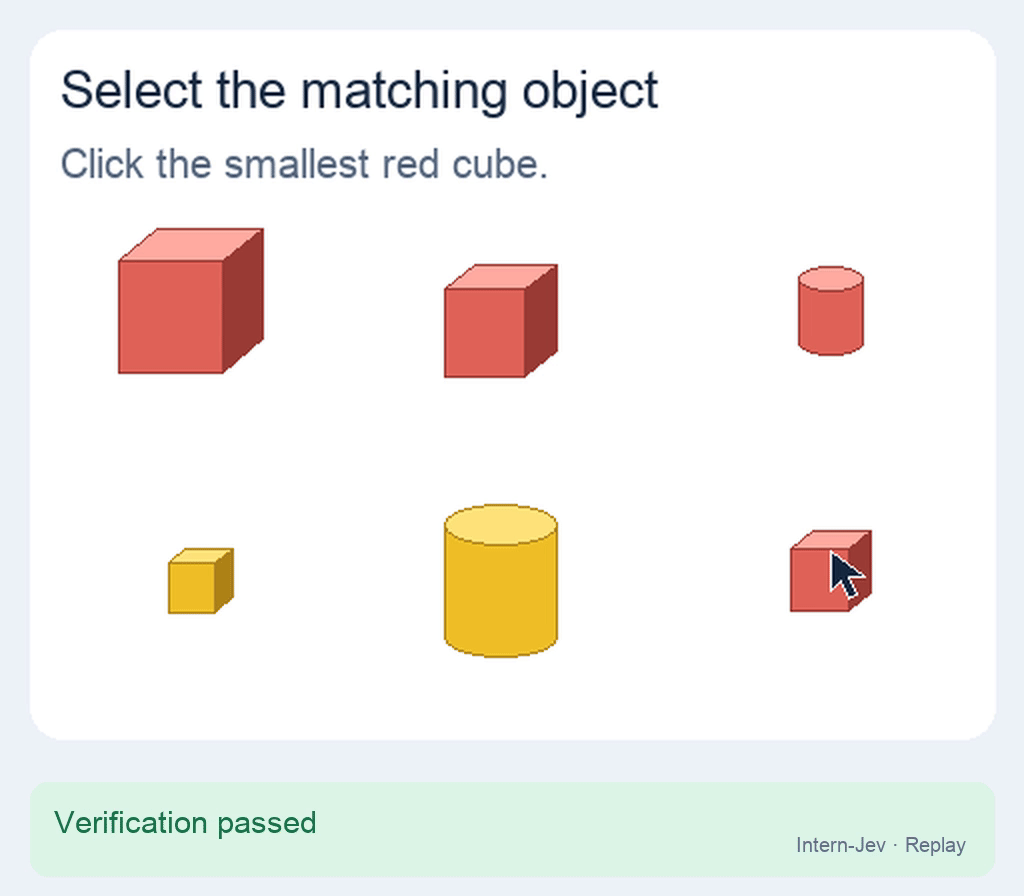
验证码任务要求模型将视觉感知、指令理解与交互决策结合起来。这里让Intern-Decision直接读取界面截图,根据自然语言描述寻找目标,并通过离散的鼠标移动与点击动作完成任务。模型需要理解画面中的物体属性及其相互关系,并将这些判断转化为可执行的操作序列。
四个演示记录了Intern-Decision自主完成任务的完整成功轨迹:从解析指令、辨识目标,到移动鼠标、调整位置并完成点击,全程由模型输出动作,无人工接管或纠偏。这些案例展示了Intern-Decision将多模态理解与动作决策结合的能力,也为研究面向图形界面的视觉交互与任务执行提供了直观的实验场景。
操控浏览器实现复杂任务
网页操作要求模型在持续变化的界面中反复判断下一步动作。用户通常只需要提出任务目标,系统随后读取当前页面、选择操作、观察页面更新,并继续作出判断,直到任务完成。
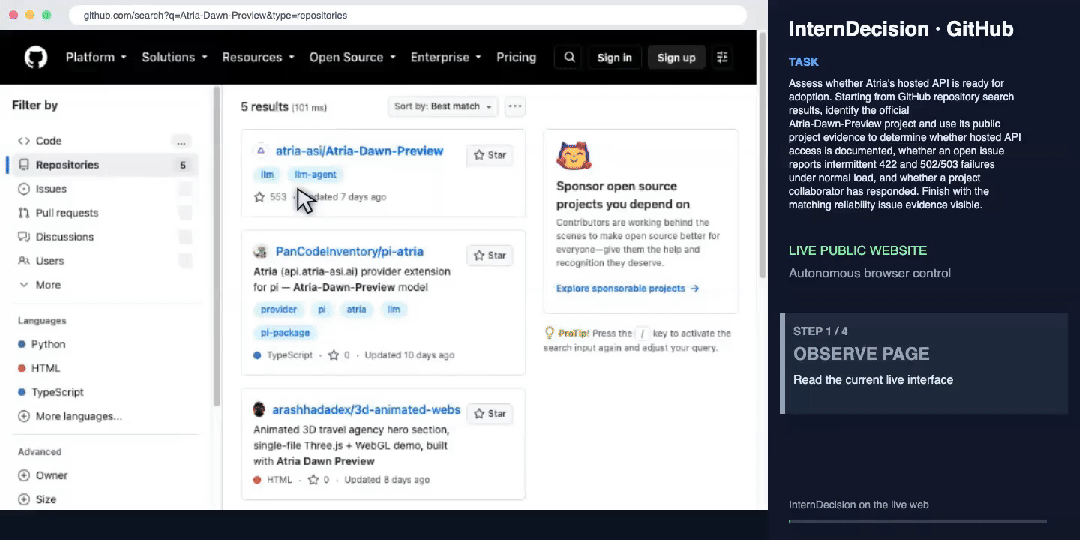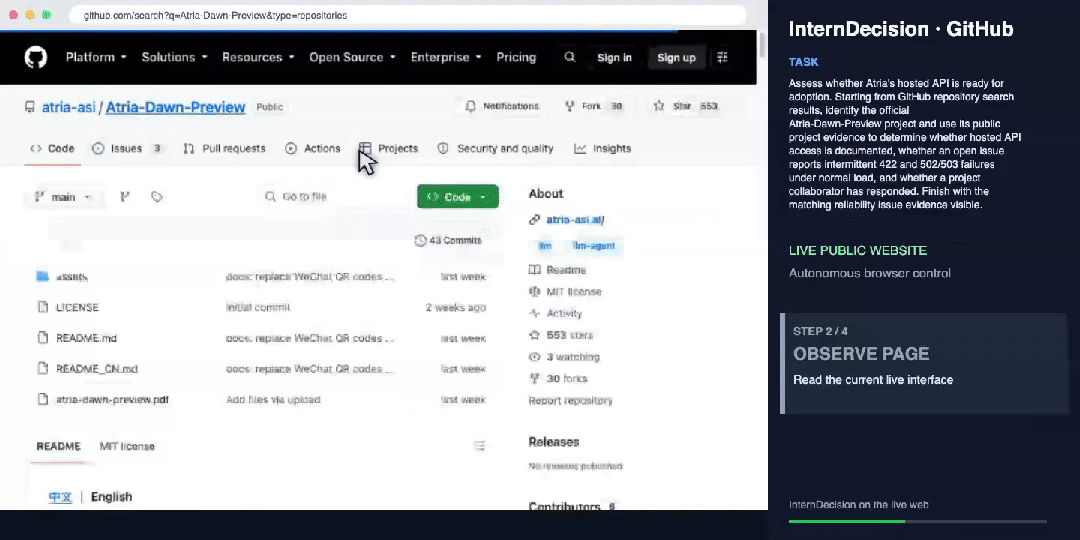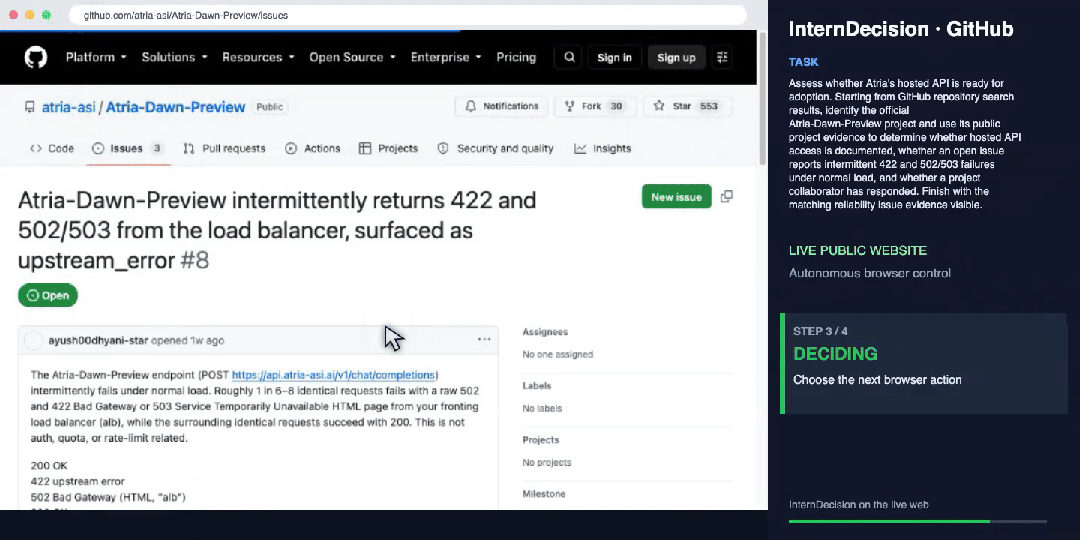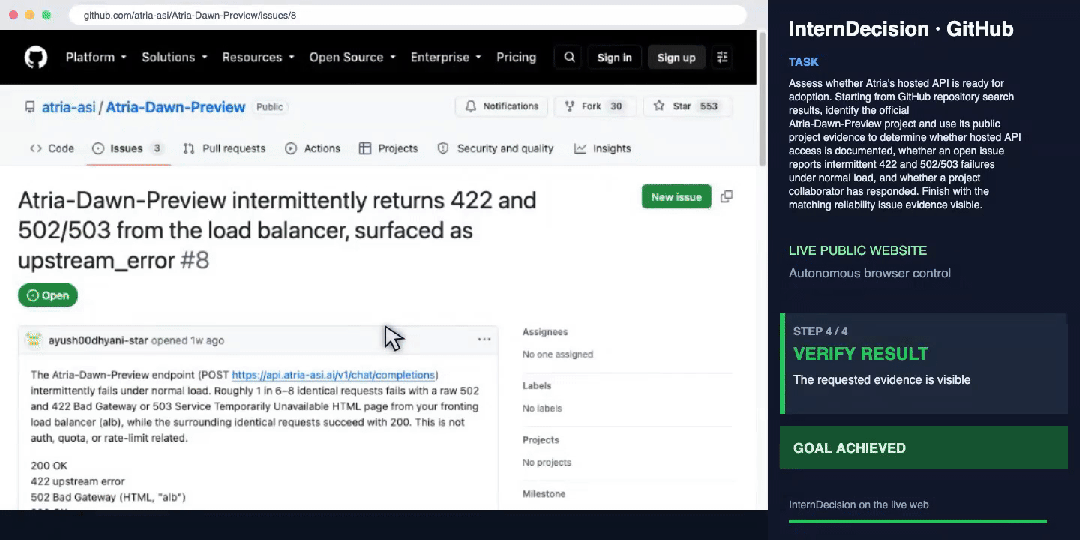
这里采用大小模型协同的方式完成这一过程。大模型负责理解整体目标、拆解阶段任务,并结合跨页面信息提供指导;Intern-Decision负责高频的局部决策,根据当前页面,在点击、滚动、返回和结束等候选动作中快速选择。每次操作执行后,系统都会重新读取页面状态,再进入下一轮判断。
下面三个Demo展示了这一协作方式在真实公开网页中的应用:
- Hugging Face:系统从官方Atria模型集合中找到标准checkpoint,并依次核对模型架构与默认推理配置。
- GitHub:系统从搜索结果中识别Atria官方仓库,进入Issues,并定位包含422与502/503异常的API可靠性报告。
- PyTorch:系统沿官方文档查找scaled_dot_product_attention的dropout使用风险,并进一步追踪到对应版本的源码实现。
这些任务覆盖了模型集成检查、API问题排查和技术资料核验等常见工作,也展示了大小模型协作处理连续网页决策的实际效果。


开放获取权重和代码
为了满足不同人群和设备的需求,团队本次开源0.8B、2B和4B共计三款多模态决策模型。目前Intern-Decision系列模型已经在Hugging Face开源,代码和样例也存放在GitHub,欢迎大家试用和反馈。
GitHub:https://github.com/InternLM/Intern-Decision
Hugging Face:https://huggingface.co/collections/internlm/intern-decision
文章来自于微信公众号 “量子位”,作者 “量子位”