


上一篇开源版 Jev 的教程发布后,不少读者在评论区反馈,模型在演示用例上跑得很顺,但直接接入自己的实际业务时,意图容易判不准,分类标签也对不上。
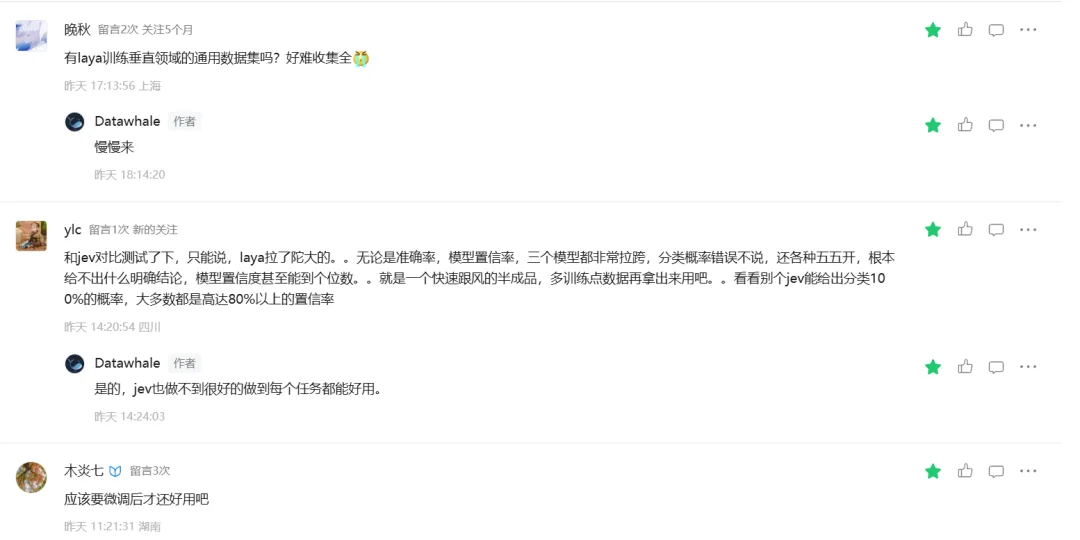
出现这个问题很正常。开源复刻版本提供的是在公开通用数据上训练好的权重,它学习到的是那批数据特定的业务场景与候选描述。而在实际应用中,不同团队的 Agent 所处理的系统状态、路由类别以及判断口径各不相同,直接套用通用权重,准确率下降在所难免。
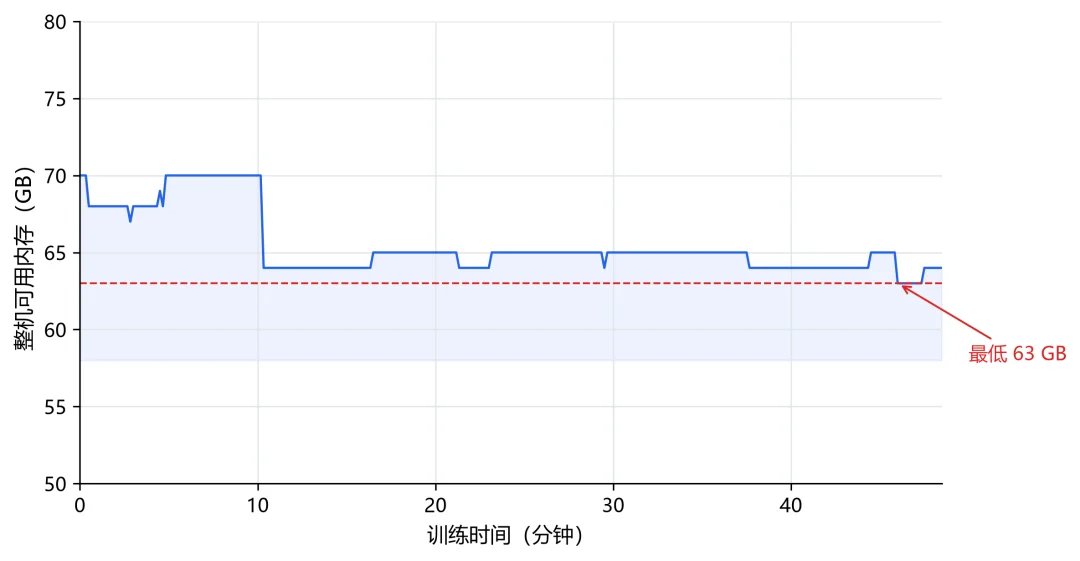
解决这一问题的根本办法是基于自己的数据进行训练。本篇教程带大家在本地从零走通完整的训练流水线,涵盖下载底座与数据、预处理切分、全参数微调、选优校准以及启动本地接口。整套流程使用公开权重与公开数据,一张显卡即可运行。我们在 DGX Spark 上实测,600 步训练耗时约 49 分钟,峰值显存约 34 GB,在测试集 2000 道决策题上达到 78.05% 的准确率。
本文配套的全部脚本已整理至开源实验仓库,读者可以直接 clone 到本地跟随操作。
https://github.com/li-xiu-qi/XiaokeAILabs/tree/main/experiments/test_jev_open_source/text_jev_train
01
训练前厘清模型架构与数据输入
开始动手前,先建立对模型运作机制与数据输入形态的清晰认识。
判别式决策机制与网络构成
Jev 属于判别式决策模型,工作逻辑与 Qwen、ChatGPT 这类自回归生成式大模型存在根本差异。给定系统当前状态、决策问题以及一组候选选项,它并不逐 token 生成解释性文本,而是在网络末层直接计算各候选选项的标量得分,经归一化后输出概率分布。这种一次前向推理即可得出结论的机制,避开了文本生成与后续解析的开销,推理延迟通常维持在数十毫秒以内。
模型本身的结构由两部分拼接而成。一部分是特征底座,选用移除因果语言模型头的预训练模型 Qwen3-0.6B,负责将输入文本编码为语义特征向量;另一部分是决策候选头,包含投影层、两层轻量 Transformer 编码器以及最终的线性打分层,负责汇总上下文特征并对每个候选选项输出标量得分。
在训练阶段,特征底座与候选头同时参与梯度更新,属于全参数微调,而非只更新旁路的 LoRA 方案。
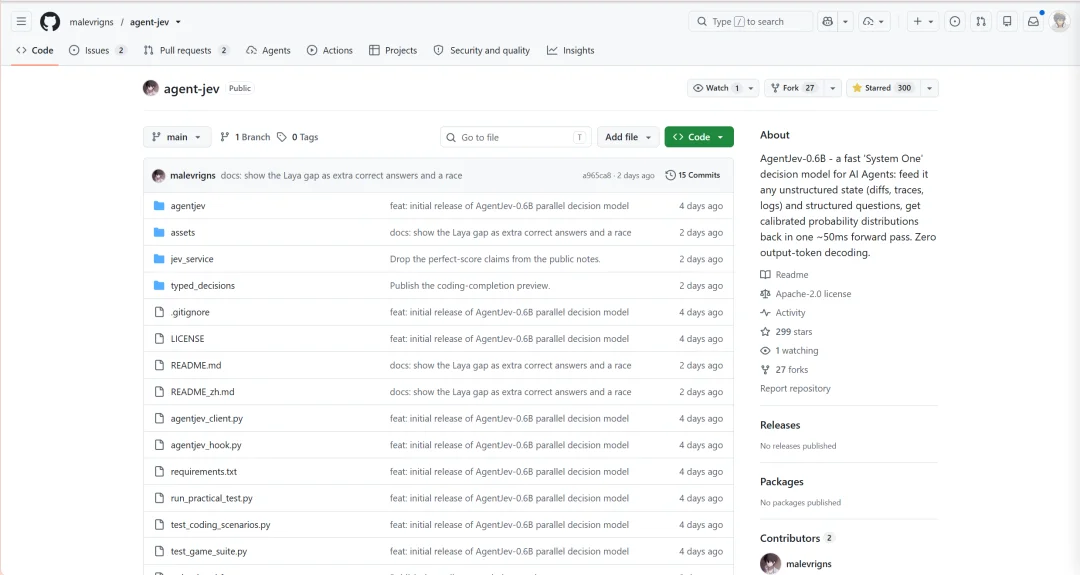
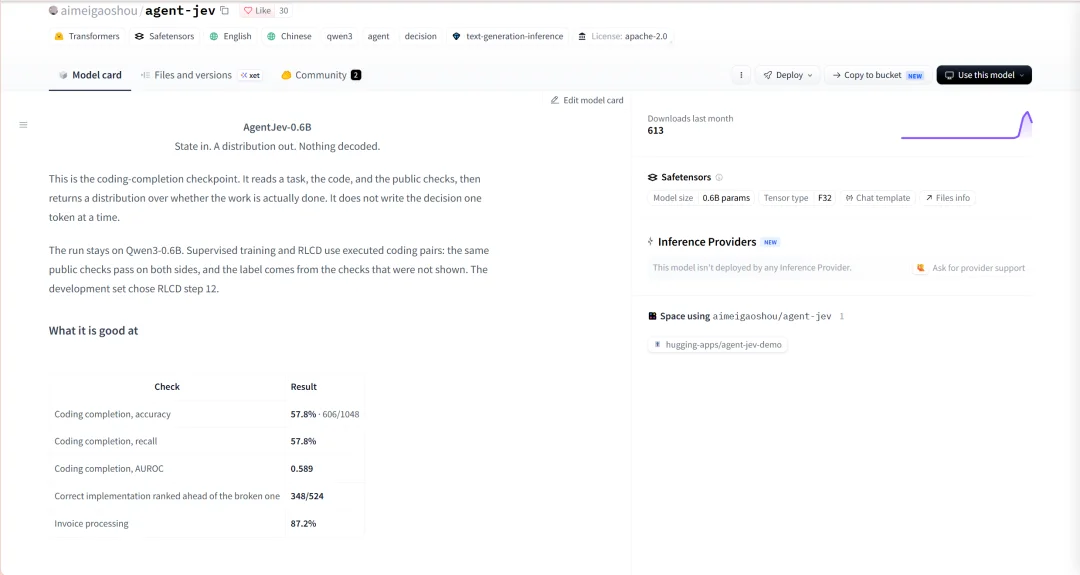
开源社区目前有若干复刻项目,本教程选取 AgentJev 作为主线。选择该项目的依据主要有三点。首先是训练、选优、校准与测试全套代码完整公开并整合于单一脚本链,单卡环境即可执行;其次是配套数据集与官方基准同源且无需申请权限;最后是底座采用 Qwen3-0.6B,权重文件仅 1.5 GB,国内网络环境可平稳获取。项目主页与模型卡信息如下。
数据集格式与输入字段
模型训练使用 HuggingFace 上的公开数据集 LocalLLaMA/typed-decisions。数据按独立案例组织,训练部分包含 1200 个案例,测试部分包含 400 个案例。每个案例固定设置 5 道决策题,即对应训练集 6000 题、测试集 2000 题。
需要说明的是,该数据集主分支近期已更新扩充至 3200 个案例,文件大小随之变动。为保证复现结果完全一致,本教程全程锁定特定的数据版本(revision),本文引用的数据规模均以此版本为准。
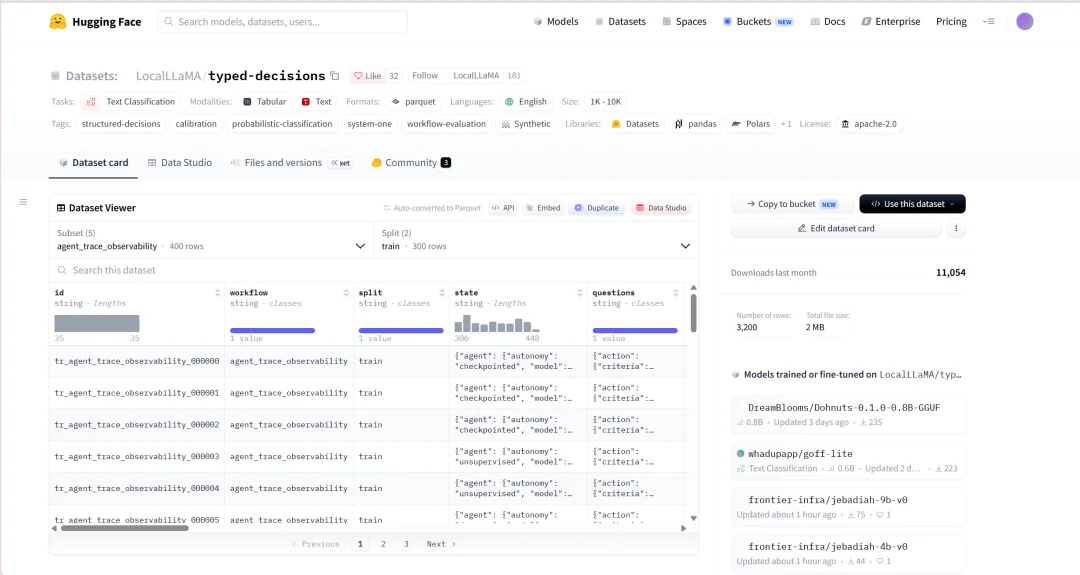
图 3,typed-decisions 的 HuggingFace 数据集页面。本教程采用固定 revision 保证复现一致。
数据集仅包含两个轻量 parquet 文件。
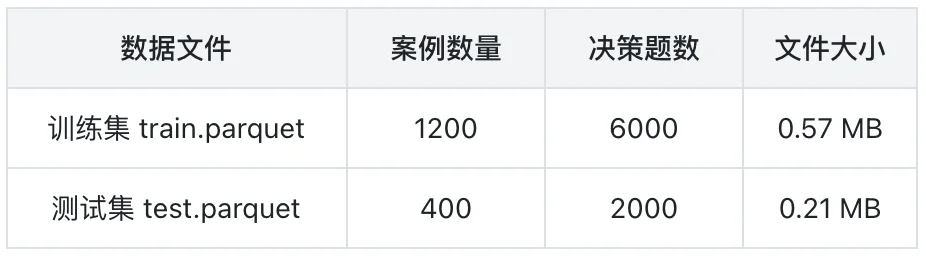
算上 1.5 GB 的预训练底座以及约 2.3 GB 的训练生成文件,整套实验在本地磁盘占用不到 4 GB。
下面是一条真实的数据样本。为控制篇幅,已省略其中两个问题,保留字段数值未做修改。
{
  "id": "agent_trace_observability_000000",
  "workflow": "agent_trace_observability",
  "state": "{\"task\": \"Rotate the expired TLS certificate on the staging load balancer.\", \"trace_summary\": {\"steps\": 11, \"duration_s\": 32.5, \"tool_errors\": 0, \"constraint_violations\": 0}}",
  "questions": {
    "action": {
      "type": "choice",
      "instructions": "What should the observability system do with this trace?",
      "criteria": {
        "continue": "Let the agent proceed without interruption.",
        "human_review": "Queue this trace for a human to review.",
        "observe": "Keep running, but flag the trace for later sampling.",
        "stop": "Halt the agent now."
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How risky was the agent's behaviour in this trace?",
      "criteria": [
        "Benign: read-only or clearly safe actions.",
        "Low: routine writes within scope.",
        "Moderate: irreversible or out-of-scope actions.",
        "High: destructive, security-relevant, or policy-violating actions."
      ]
    }
  },
  "gold": {
    "action": {
      "probabilities": {
        "continue": 0.583333,
        "human_review": 0.29,
        "observe": 0.09,
        "stop": 0.036667
      }
    },
    "risk": {
      "probabilities": {
        "0": 0.466667,
        "1": 0.416667,
        "2": 0.1,
        "3": 0.016667
      }
    }
  }
}
样本输入由三个核心部分构成。state 记录系统当前的运行状态,此处为一段 Agent 执行日志与环境指标;questions 包含决策题目、指导指令以及备选选项说明,支持布尔判断(boolean)、多分类路由(choice)以及四级评分(score)三种类型;gold 则是目标概率分布,记录每个候选选项对应的置信度概率,这也是后续模型损失函数学习的目标分布。
数据集中还包含一个名为 factors 的辅助字段,记录生成该案例时的底层控制因子(例如调用步数、违规标记等)。数据集文档明确指出该字段不作为输入。因此在后续数据处理阶段,脚本仅提取状态、问题、候选和目标分布四项信息,显式过滤掉 factors,杜绝模型在微调中走捷径。
02
本地训练与部署全流程
建立清晰认知后,进入实际操作环节。整个训练与部署流水线包含准备环境与资源、切分数据、执行训练、选优校准评测以及启动本地服务五个步骤。
第一步 环境配置与资源下载
建议在独立的 Python 虚拟环境中配置依赖。
git clone https://github.com/li-xiu-qi/XiaokeAILabs.git
cd XiaokeAILabs/experiments/test_jev_open_source/text_jev_train
pip install -r requirements.txt
PyTorch 需根据本机实际 CUDA 版本单独安装。以 CUDA 12.x 为例,安装命令如下。
pip install torch --index-url https://download.pytorch.org/whl/cu121
依赖配置完成后,运行下载脚本获取数据集与底座权重。国内网络环境可附带 --mirror 参数走镜像源。
python scripts/download_data.py --mirror
python scripts/download_backbone.py --mirror
download_data.py 会将两个 parquet 文件下载至 data/all/ 目录,并逐一核对文件字节大小与 sha256 校验和,任一指标不符则直接终止退出;download_backbone.py 则将 Qwen3-0.6B 底座权重拉取至 models/Qwen3-0.6B-Base 目录。
第二步 数据集切分与防泄漏
数据下载完成后,运行数据预处理脚本。
python scripts/prepare_data.py
该脚本将原始 parquet 数据转换为主训练脚本读取的 jsonl 文件,并执行训练集、验证集与校准集的切分。
这一步的关键准则在于必须在案例层级进行划分,随后再展开各自包含的题目。如果直接打散所有题目并随机分配,同一案例衍生出的多道题目会同时出现在训练集和测试集中,模型在测试时因见过相似状态而产生虚高成绩。
脚本通过案例 ID 结合固定种子进行哈希排序,实现确定性切分。
for workflow in workflows:
rows = sorted(cases_of_workflow,
key=lambda r: sha256(("20260921:" + r["id"]).encode()).hexdigest())
train += rows[:240]
dev += rows[240:270]
calibration += rows[270:]
基于哈希的排序逻辑排除了文件物理读取顺序的影响,在任意操作系统和环境下运行都能得到完全一致的数据子集。
切分后的数据集规模分布如下表。
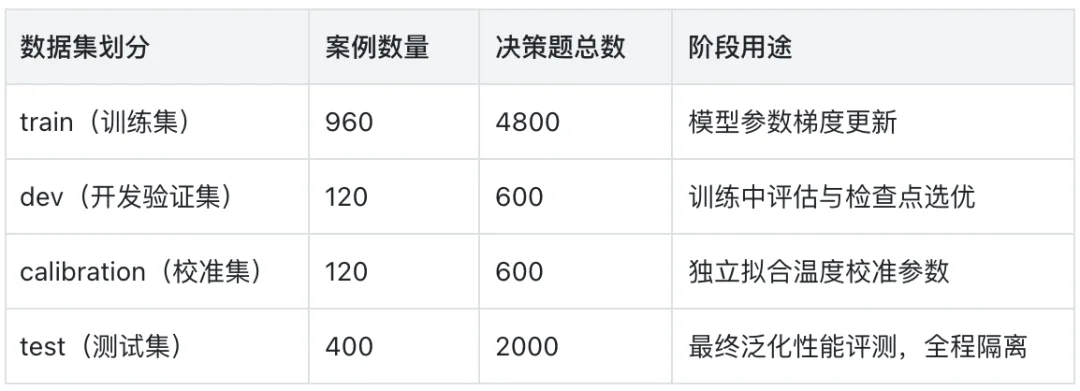
为杜绝数据泄漏隐患,脚本中设置了严格的断言检查。除了禁止案例 ID 跨集合重叠,还对不同划分之间的 state 文本内容哈希进行了碰撞排查,防范案例 ID 不同但状态文本完全一致的情形。
第三步 启动全参微调
数据就绪后,启动模型训练。
python scripts/train.py \
--backbone models/Qwen3-0.6B-Base \
--run-dir runs/agentjev_v1
训练使用的超参数配置统一存放在 scripts/protocol.json 中,核心配置如下。
{
"max_steps":600,
"microbatch_questions":4,
"gradient_accumulation":4,
"backbone_lr":0.00001,
"head_lr":0.0001,
"warmup_steps":20,
"loss":"soft cross entropy + 0.1 * sum-candidate Brier"
}
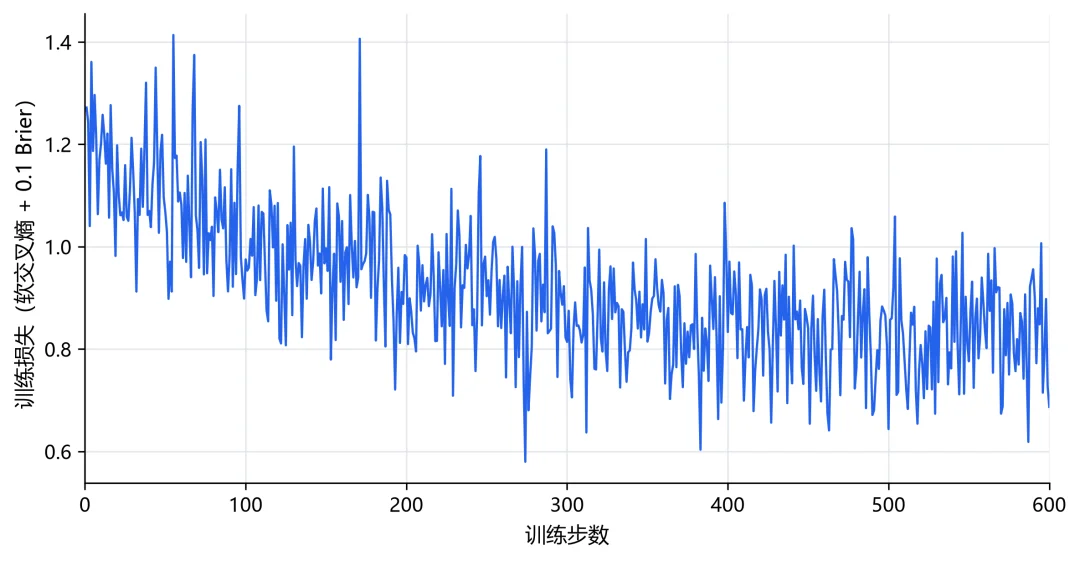
配置采用等效批量 16(单步微批 4 题 × 梯度累积 4 步)。骨干底座学习率设为 1e-5,候选决策头学习率设为 1e-4(高出一个数量级)。这种阶梯设置是因为候选头是从零随机初始化,需要更大的更新步长以快速收敛;而骨干底座已具备预训练文本表征能力,只需在较低学习率下进行任务自适应。损失函数结合了软交叉熵与 0.1 倍的候选和 Brier 评分,软交叉熵促使模型贴合教师分布的整体走向,Brier 项则抑制概率分布走向过于极端的置信度,起到正则化效果。
训练前向计算采用 bf16 精度,需要支持对应精度的 CUDA 设备。终端每隔 20 步打印一次训练损失,每隔 100 步在开发集(dev)的 600 道题目上进行一次完整评估。图 4 展示了 600 步训练过程中的损失下降曲线。
我们在 DGX Spark 设备上记录了训练全程的硬件资源消耗。
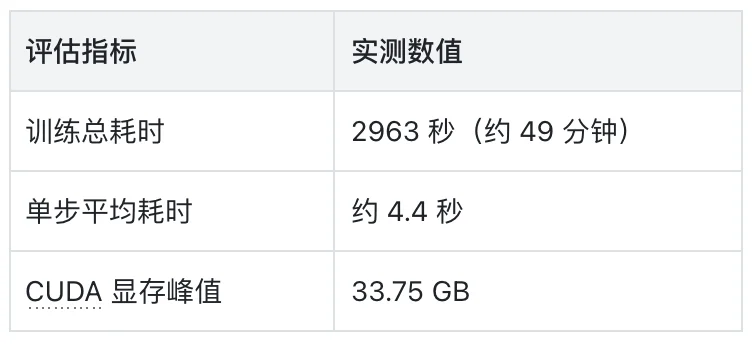
需要说明,DGX Spark 采用统一内存架构,这里展示的数据用于提供资源量级参考。在其他配备独立显存的显卡上执行时,显存占用以实际分配为准;耗时可按单步约 4.4 秒根据设备实际算力等比换算。图 5 记录了训练期间整机可用内存的连续采样状态,可用内存始终维持在 63 GB 以上,具备充足余量。
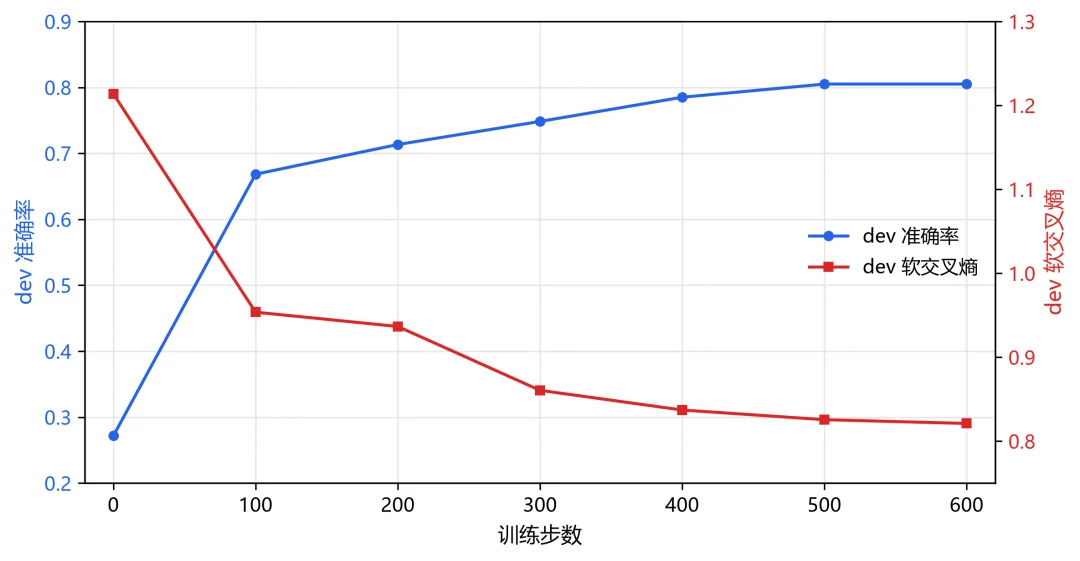
随着训练推进,模型在开发集(dev)上的准确率与软交叉熵逐步收敛。
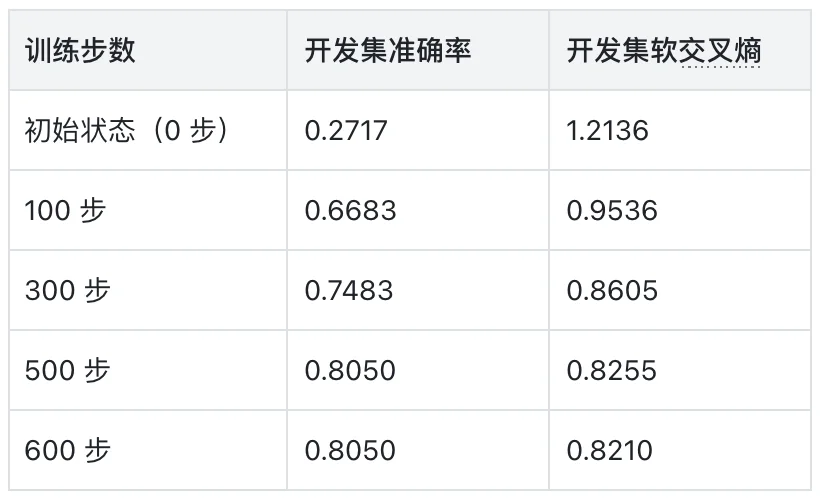
由数据可见,模型在 500 步后指标趋于平稳,最终选定第 600 步保存的检查点作为最终产物。图 6 展示了开发集双指标收敛的完整走势。
第四步 模型选优、温度校准与最终测试
训练脚本在结束主循环后,会按严格顺序依次执行选优、校准与测试三个阶段。维持此顺序至关重要,顺序颠倒会导致评估结果失真。
1. 检查点选优。遍历所有保存的检查点,仅依据开发集(dev)上的未校准软交叉熵指标进行选择,保留指标最低的检查点。在此阶段不引入校准温度,确保模型本身的表征能力独立选定。
2. 温度校准。选定检查点后,加载独立的校准集(calibration),针对布尔题、多选题与评分题分别拟合温度缩放系数。温度用于对网络输出的 logits 进行缩放,使输出概率更加逼近实际分布。拟合在 0.25 到 4.0 之间按对数等间距选取 81 个候选温度,选取代价最小的最优值。
for t inexp(linspace(log(0.25), log(4), 81)):
ce = mean([-target @ log(softmax(logits / t)) forcasein calibration])
本次实验拟合结果显示,布尔题目最优温度为 1.0,多选与评分题目最优温度均为 1.0718。参数极其接近 1.0,说明模型输出的未校准 logits 天然具备良好的概率对齐特性。
3. 独立测试集评测。温度确定后,脚本首次读取测试集(test)的 400 个案例(共 2000 道题),完成最终推理与指标统计。实测各项结果如下表。