


2026年,CPU成了AI世界里的「硬通货」。
全球服务器CPU集体涨价、交货期拉长,最夸张的时候订货要等半年。
原因很简单,AI不再只是「问一句答一句」的对话机器了。
Agent智能体开始自己规划任务、调用工具、运行代码、管理记忆,这些活儿全得靠CPU来扛。
CPU,这个曾经被GPU光芒掩盖的「老兵」,正在Agentic AI的浪潮中重返算力舞台的中央。
就在这个节骨眼上,鲲鹏在上海扔出了一颗重磅炸弹。
9月17日,第十一届华为全联接大会(HC 2026)在上海世博展览馆和世博中心开幕。
3场主题演讲、20场峰会、60多场论坛,展区面积超过22000平方米。规模拉满。
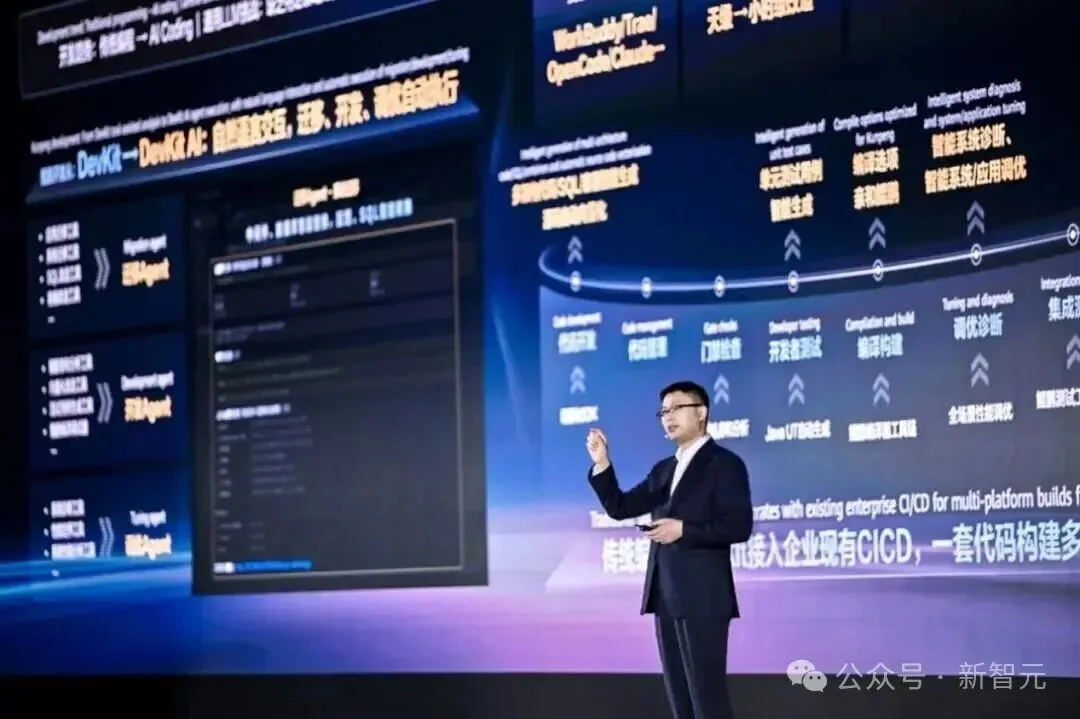
而在当天的鲲鹏计算产业峰会上,华为鲲鹏计算产品线总裁李义站在台上,带来了一个明确的信号:
面向Agentic AI时代,鲲鹏要做领先、开放、安全的智能体底座。
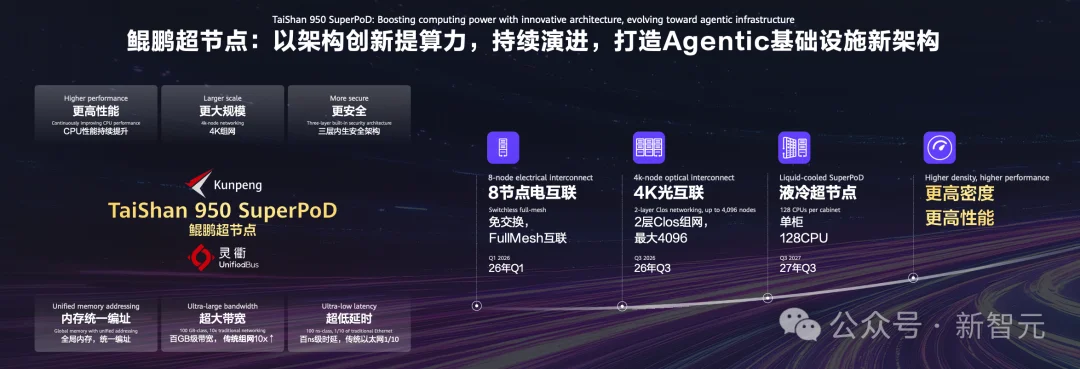
鲲鹏超节点全新升级,风冷、液冷双旗舰亮相,最大支持4096节点组网,构建百TB级统一内存池。
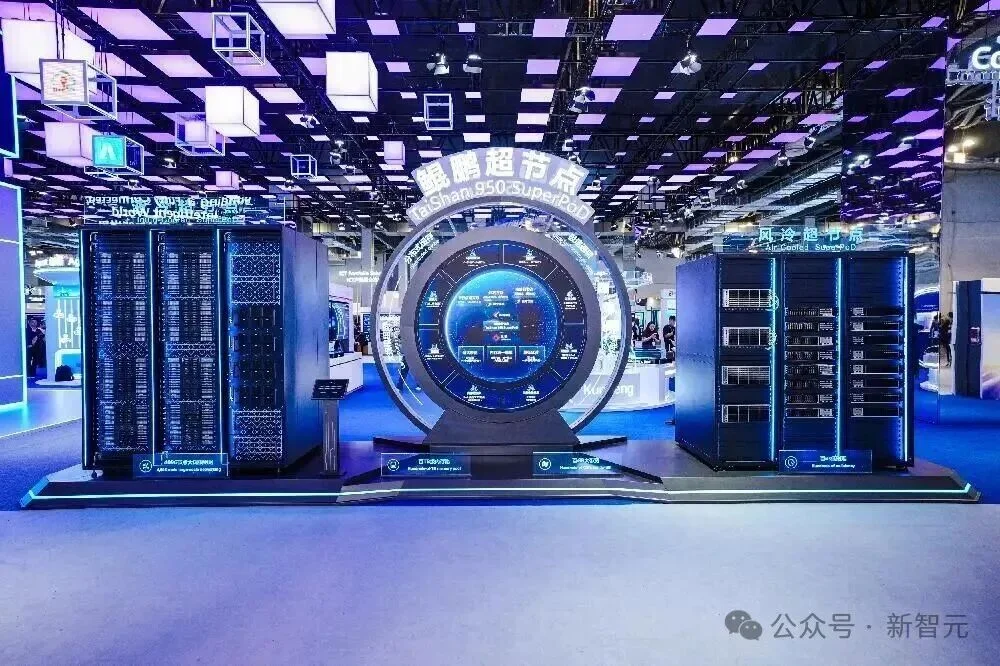
一句话概括这次升级的野心:以架构换算力,为世界构建新选择。
七年深耕,
鲲鹏从「新选择」长成了「主力军」
2019年鲲鹏计算产业战略发布的时候,不少人还在观望:
自研Arm架构处理器做服务器,能行吗?生态能建起来吗?谁会买?
七年过去了,数字给出了最直接的回答——
鲲鹏联合13家OEM伙伴推出了300多款整机,与7200多家ISV伙伴打造了28000多个行业解决方案,全球开发者规模超过416万。
openEuler和openGauss已经成为国内最具影响力的操作系统和数据库开源社区之一。
这些数字背后是一个清晰的逻辑:鲲鹏没有试图「颠覆」谁,而是通过硬件开放、软件开源的路线,把产业链上的伙伴一个个拉进来,共同做大蛋糕。
华鲲振宇就是一个缩影。
2020年成立之初就坚定选择鲲鹏路线,六年间推出五十多款鲲鹏算力产品,拿下鲲鹏金融应用的第一单,营收连续两年站稳百亿台阶。
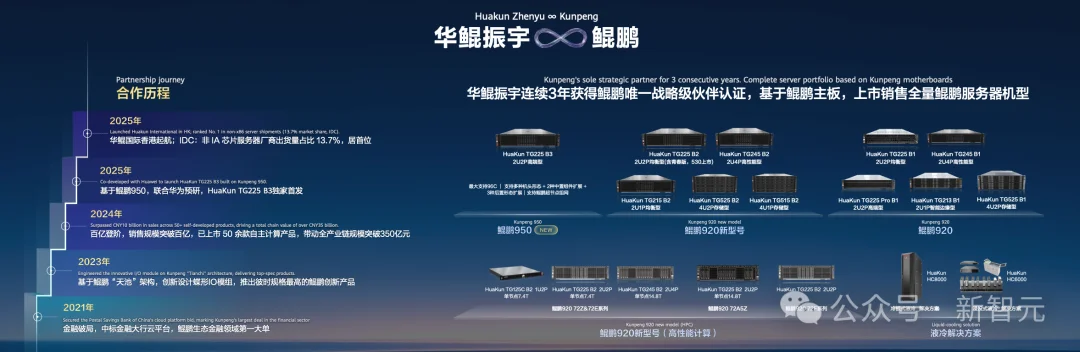
昆仑技术同样如此,基于鲲鹏打造了全系列服务器产品线,预计今年营收将突破百亿。
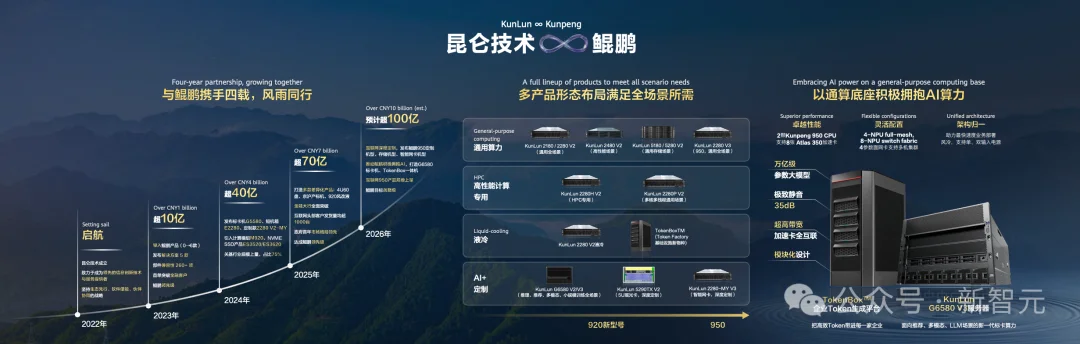
从一个需要被「说服」的技术路线,到成为行业主流的算力选择,鲲鹏走了七年。
而现在,一个更大的变量出现了。
CPU重返C位
Agentic AI重写算力格局
如果说过去几年AI的故事属于GPU,那么2026年开始,剧本正在被改写。
逻辑很简单:大模型不再只是「被问一个问题,回一段话」。
当AI从Chatbot进化为Agent,它需要自主规划任务、调度工具、执行代码、管理记忆、运行沙箱。
这些活儿,GPU干不了,得CPU来扛。
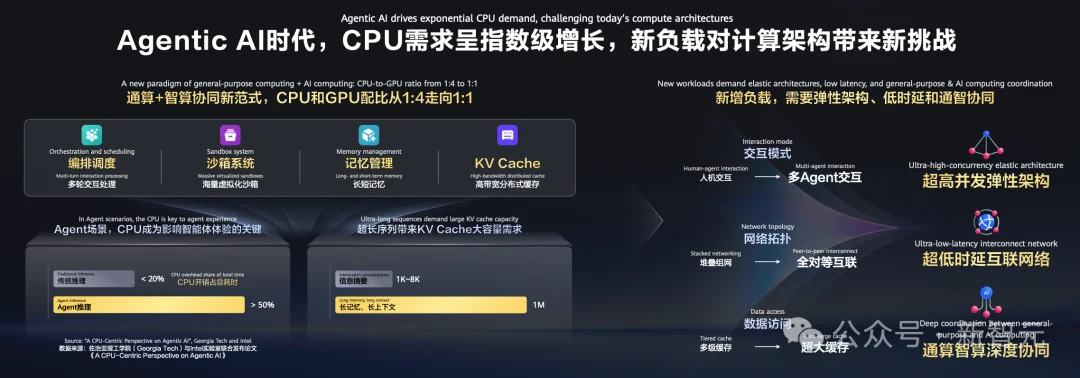
根据佐治亚理工学院与英特尔联合发表的论文《A CPU-Centric Perspective on Agentic AI》,传统AI推理场景中CPU的时间占比不到20%,而到了Agent推理场景,这个比例飙升到50%以上。
GPU和CPU的配比,也从过去的1:4历史性地走向了1:1。
这是一次算力架构的范式转移。
鲲鹏敏锐地抓住了这一点。
李义在演讲中指出,Agentic AI时代新增负载对算力架构带来三重挑战:人机交互走向多Agent交互,需要超高并发弹性架构;传统堆叠组网难以满足超低时延互联需求;大容量KV Cache缓存需要通算与智算深度协同。
换句话说,光有强大的GPU阵列还不够。
Agent时代的算力底座,必须是「通算+智算」协同的新架构。
这正是鲲鹏这次升级的核心逻辑。
硬件亮剑:鲲鹏超节点全面升级
鲲鹏这次在基础设施层面的升级,可以用两个关键词概括:处理器进化、超节点蜕变。
处理器方面,鲲鹏920新型号是目前业界唯一同时兼容DDR4和DDR5双内存规格的CPU。
这意味着用户可以用存量内存平滑过渡到新平台,省下一笔真金白银。
鲲鹏950则走高性能路线,高核宽比,场景化性能业界领先。
两款产品搭配,覆盖从性价比到高性能的全场景需求。
但真正让人眼前一亮的,是鲲鹏超节点的重磅升级。
过去的服务器是一台台独立的机器,靠以太网连在一起。
鲲鹏超节点的思路不同:超节点是一种在物理上由多个计算节点通过高效的灵衢互联协议紧密连接组成,具备跨物理节点的统一内存编址能力,逻辑上具备「一台计算机」特征的计算系统。
三大核心特性——内存统一编址、超大带宽(百GB级,是传统组网的10倍)、超低时延(百ns级,是传统以太网的1/10),定义了什么才是「真正的超节点」。
李义在演讲中特别强调了一点:以RoCE等协议互联、不支持「内存统一编址」能力的,不是真正意义上的超节点。
这句话虽然没有点名,但指向性很明确:鲲鹏在用技术规格划定赛道标准。
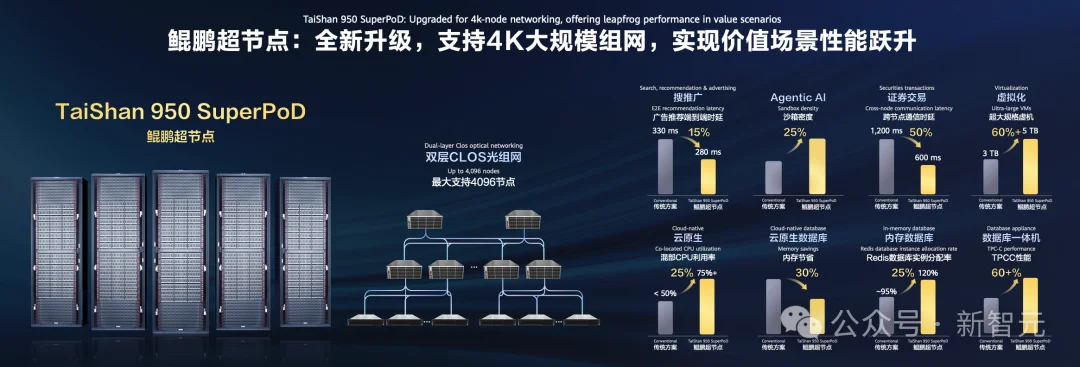
事实上,鲲鹏超节点的演进是一条清晰的「三级跳」路线——
- 年初先用电互联跑通8节点FullMesh免交换组网,验证了「内存统一编址」这个核心能力;
- 然后就是这次大会上亮相的4K光组网风冷旗舰,通过双层CLOS架构把规模一口气拉到4096节点,百TB级内存池正式落地。
- 而更值得期待的是下一跳:2027年Q3,全新液冷超节点将登场,单柜塞进128颗CPU,实现更高的部署密度和更高性能提升。
从电互联到光互联再到液冷,每一步都不是简单的「换个散热方式」,而是在密度、规模和能效上同时拧螺丝。
鲲鹏的节奏很清楚:先把架构跑通,再把规模拉大,最后把能效推到极致。
软件护航:四大基础软件构筑异构融合底座
硬件再强,没有软件也是白搭。这一点鲲鹏看得很清楚。
围绕操作系统、数据库、集群软件、编译器四大方向,鲲鹏构建了一套完整的异构融合池化体系,纵向实现芯、硬、软协同,横向打通通算、智算、网络、存储的硬件资源融合。
openEuler,作为超节点的异构融合操作系统,通过池化内存和高速通信实现KV Cache毫秒级访问。
在Agentic AI场景下,这意味着智能体的「记忆」可以被近乎实时地读取和写入,不再受限于传统存储的带宽瓶颈。
openGauss,业界首个开源超节点多写数据库。2节点多写可实现570万tpmC,性能相较传统方案提升60%。
对于需要高并发事务处理的金融、电商等场景来说,这是一个实打实的竞争力。
openFuyao,作为多样化算力集群管理软件,打通超节点与云原生生态。依托URMA高速通信,业务容器通信时延下降40%以上。
简单是就是,你的Kubernetes集群里的容器,跑在超节点上比跑在传统服务器上快了接近一半。
BiSheng编译器,做异构算力亲和优化。它能结合Agent负载的动态变化,实时进行全链路调优,运行效率提升20%。
这不是传统的「编译完就不管了」,而是一个持续在线、感知负载、自适应调整的智能编译系统。
四大基础软件协同发力,把超节点从一个硬件概念变成了一个真正可用的软件平台。
实战检验:当超节点遇上真实业务
架构讲得再漂亮,归根结底要看一个问题:扛不扛得住真实业务的压力?
先说一个大家都熟悉的场景。
你打开某购物App,刚搜了一双运动鞋,转头刷短视频就看到了相关广告。这背后就是生成式广告推荐系统在工作。
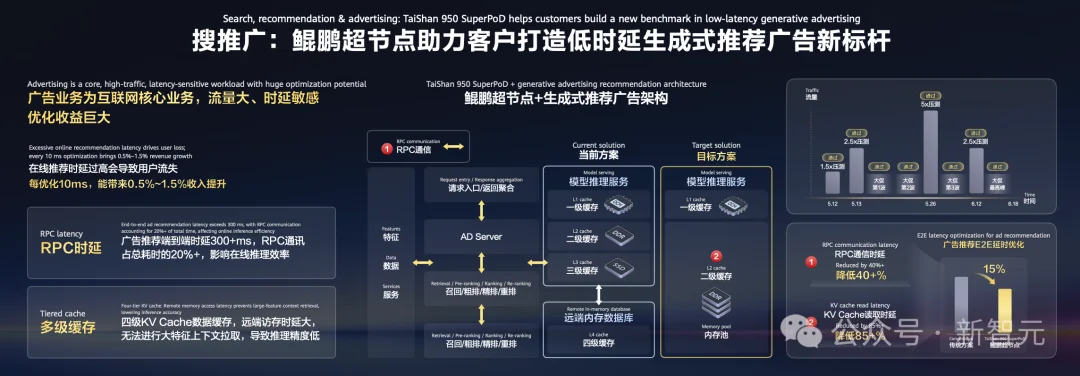
这套系统对时延极其敏感,每优化10毫秒就意味着0.5%—1.5%的收入增长,这是真金白银。
传统架构下,推荐系统的RPC通信占了端到端时延的大头,而四级缓存架构中远端的KV Cache访问又慢又不准。
鲲鹏超节点的解法是:灵衢互联把RPC通信提速,内存池化把上百TB的KV Cache全部拉到「身边」,让远端变近端。
效果十分显著:在线推荐端到端时延降了15%。这个方案已经在京东618大促中跑过了实战,是真正经历过流量洪峰冲刷的。
推荐系统解决的是「快」的问题,而大模型推理面对的挑战更复杂,不光要快,还要能「装得下」。
今年以来,大模型的上下文窗口从128K飞速拉长到百万Token级。
上下文越长,需要缓存的KV Cache就越多,本地存储很快就扛不住了。
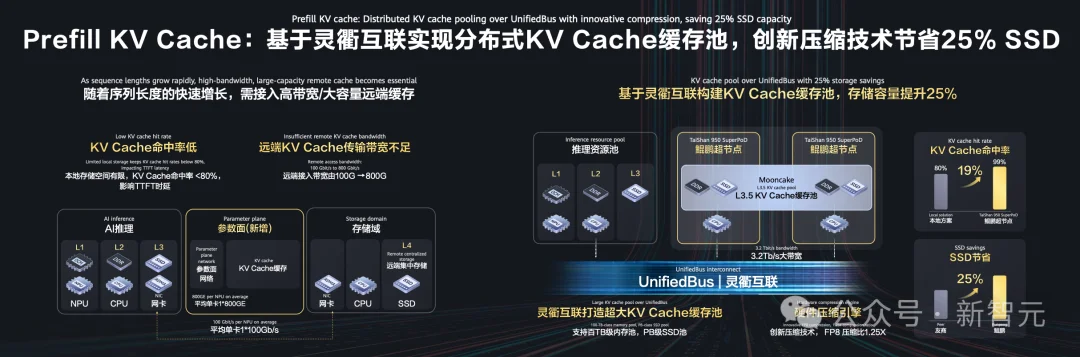
传统方案下命中率不到80%,意味着每五次查询就有一次要去远端重新算。用户要等着,成本还在烧着。
鲲鹏超节点用灵衢互联构建起超大缓存池,把命中率直接拉到99%,同时靠硬件压缩引擎省下25%的存储空间。
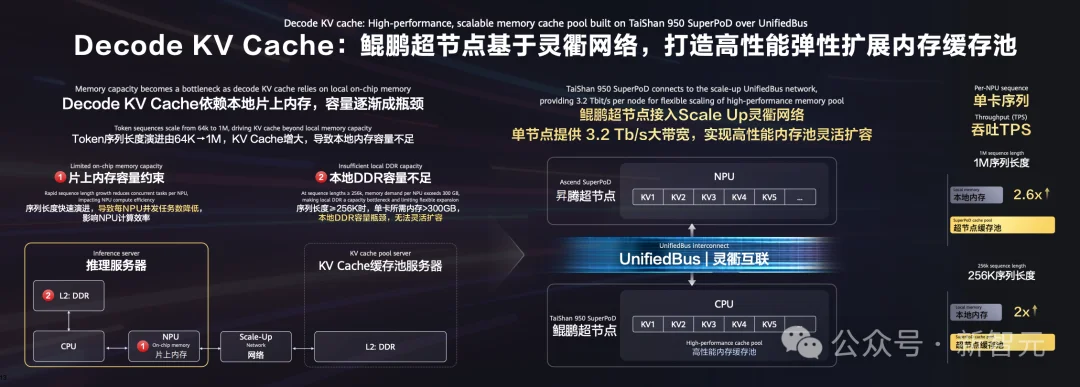
到了Decode阶段,问题更尖锐:当对话上下文拉到256K甚至百万Token级别,一张卡需要的内存就飙过了300GB,可单机的内存条根本装不下这么多。
超节点把上百TB的内存池接进来,相当于给每张卡都开了一条直通「云端仓库」高速公路,生成速度直接翻了2到3倍,而且上下文越长、提速越猛。
如果说推理场景考验的是「记忆力」,那Agent沙箱考验的就是「爆发力」——
一个AI Agent在工作时,需要一个安全隔离的沙箱环境来执行代码、调用工具。
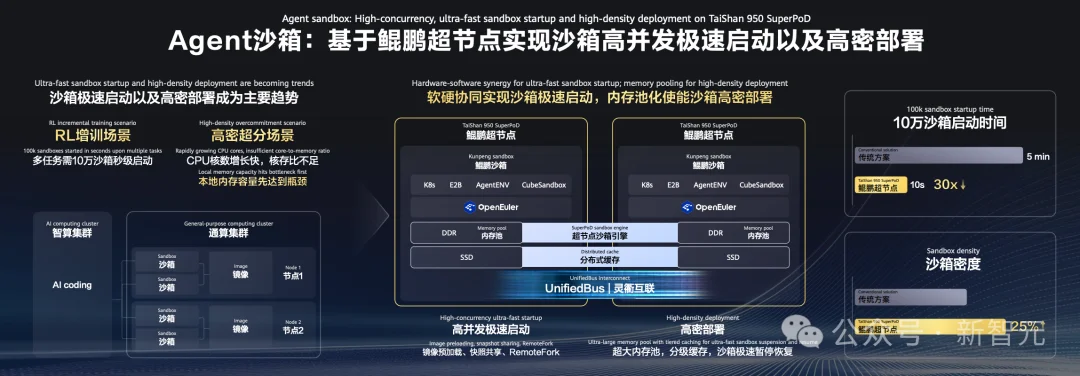
用强化学习训练Agent的时候,动辄要同时拉起10万个沙箱来做并行试错。
传统服务器方案启动这些沙箱要5分钟,对于需要快速迭代的训练流程来说,这个等待时间是不可接受的。
鲲鹏超节点用镜像预加载和RemoteFork技术把这个过程压到了10秒。
还有一个老问题:CPU的核数越堆越多,但单机内存的增长始终跟不上。就像工位越来越多、工区却没扩建,挤到最后总有人没地方坐。
超节点的百TB内存池等于开了一个巨大的共享工区,沙箱用的时候进来、暂停的时候腾出来,同样的资源能多跑25%的沙箱。
不过,当Agent开始大规模进入核心生产系统时,一个更根本的问题就冒出来了:
如果Agent「行为失控」怎么办?如果私密数据从Agent的记忆中泄露呢?