


AI 正从看懂画面,走向理解空间、预测变化、执行动作。
AI 已经越来越会生成一个“看起来真实”的世界,却依然很难真正理解并行动于这个世界。
物体在哪里、彼此是什么空间关系,遮挡之后还剩下什么;一个动作发生后,世界会怎样变化。这些问题的解法,共同指向空间智能。
而近两年具身智能与世界模型的爆火,进一步推动空间智能成为 AI 走向物理世界的核心能力基座。
回看 ECCV 2026,这趋势尤其明显。
大会程序主席 Anna Rohrbach 公布的数据显示,本届 ECCV 共收到 10473 篇投稿,最终接收 2834 篇。按研究主题划分,图像与视频合成以超过 1400 篇位居第一,视觉、语言与推理第二,3D
则从此前的主导方向退居第三。
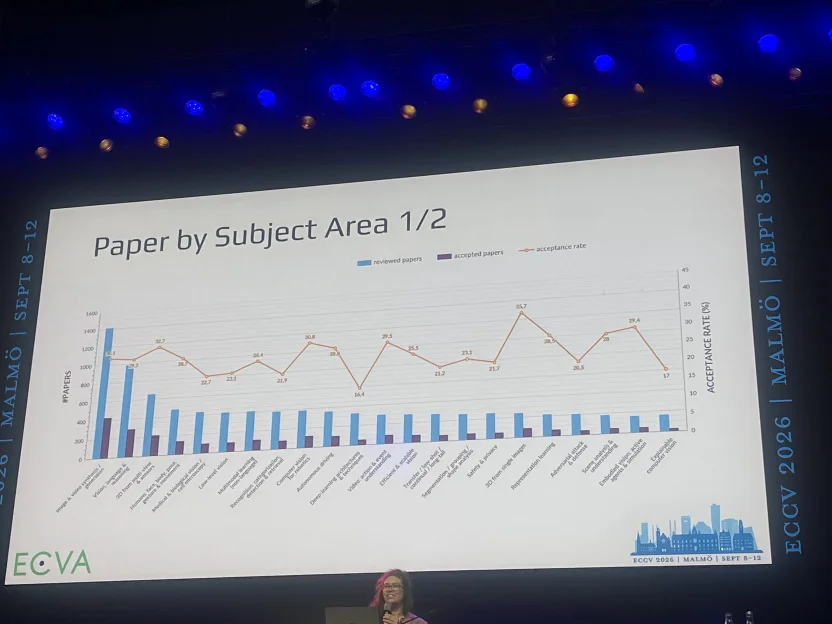
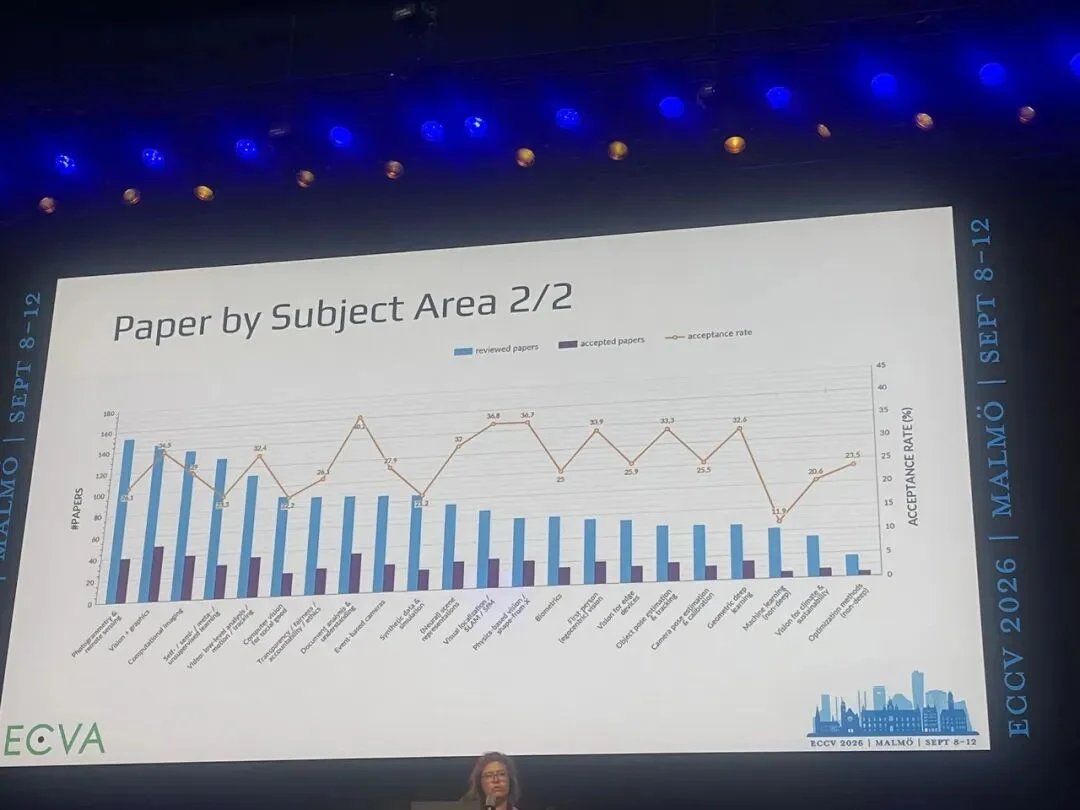
但 3D 主题排名的后退,不等于3D 退潮。相反,过去主要集中在 3D 视觉和图形学中的三维表示、几何与物理一致性、动态建模、可交互生成与空间推理等基础问题,正在向视频生成、机器人、具身智能、世界模型等方向扩散,成为 AI 走向物理世界时共同面对的问题集。
从大会 Workshop 也能看到这种变化。93 场 Workshop 中,约 10 场与 3D 直接相关,11 场涉及空间智能,9 场指向物理AI,还有 5 场以世界模型为主题。
尤其是在世界模型和物理 AI 相关 Workshop 中,不少演讲都在围绕三维空间理解、动态场景建模、预测以及进一步的执行能力展开探讨。
香港科技大学教授谭平围绕可扩展的 3D 场景重建与生成展开,从场景表示切入三维空间理解;
斯坦福大学助理教授吴佳俊从二维视觉进一步走向随时间变化的三维点云轨迹,用时空表示理解物体状态及空间关系;
中山大学教授梁小丹把重点放在未来预测上,强调世界模型要能够推演接下来真正可能发生的状态变化;
哈佛大学助理教授杜逸伦则从生成式 AI 和世界模型出发,让模型先“想象”不同动作可能带来的未来,再通过搜索这些未来结果完成规划。
如果说投稿和 Workshop 反映的是热度,奖项则更能说明风向。
今年的 Koenderink 时间检验奖中,有一项颁给了空间智能旗帜人物李飞飞及其团队。最佳论文重新讨论三维表面的表示方式;两篇最佳论文荣誉提名也分别落在物体三维重建和几何感知上。
这些信号放在一起看,3D 相关研究依然保持高热度。几何重建、场景表示和渲染等老问题继续深化,研究也在向动态场景、4D 表示和交互式环境延伸。三维视觉开始承担更多空间理解的任务,并进一步支撑状态预测和行动。空间智能正在成为串起这些问题的一条主线。
01
三维视觉:从静态几何、重建与渲染,
走向动态 4D 与交互场景
今年几项主要论文奖中,三维表示、重建和几何感知反复出现。
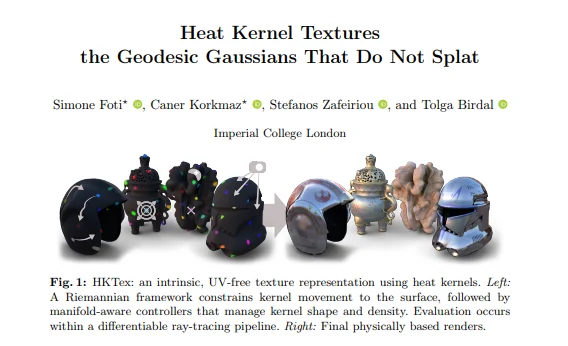
最佳论文《Heat Kernel Textures — the Geodesic Gaussians That Do Not Splat》由帝国理工学院的 Simone Foti、Caner Korkmaz、Stefanos Zafeiriou 和 Tolga Birdal 完成。它重新回答了一个很基础的问题:三维曲面的纹理到底该怎么表示。
论文链接:https://arxiv.org/pdf/2609.07557
传统网格纹理大多依靠 UV 映射,把三维曲面摊到二维平面上贴图。这套方法成熟好用,但一直摆脱不了几个老毛病:纹理接缝、曲面拉伸、UV 空间浪费、顶点重复、不同区域分辨率参差不齐。
Heat Kernel Textures 换了一条路。它从离散黎曼几何出发,用各向异性热核在曲面的测地空间中直接表达纹理,相当于避开了“先把三维表面摊平,再贴纹理”这条传统路径的缺陷。评审委员会认为,这是一项简洁而新颖的表面纹理表示方案。它把纹理表示从二维 UV 空间重新放回三维曲面本身,应用潜力也不局限于论文本身。
两篇最佳论文荣誉提名,也都落在三维重建与几何感知上。
Meta Reality Labs Research 的 Zhengqin Li 等团队提出的 《LSRM-High-Fidelity Object-Centric Reconstruction via Scaled Context Windows》,关注前馈式物体三维重建的保真度。它通过扩大 Transformer 的上下文窗口,并加入 3D 感知空间路由等设计,让模型利用更多跨视图信息,在保持前馈效率的同时恢复更精细的物体结构和外观。
论文链接:https://arxiv.org/pdf/2604.05182
另一篇提名的论文《Poppy:Polarization-based Plug-and-play Guidance for Enhancing Surface Normal Estimation》(arXiv 版本题名有所调整),作者主要来自Stony Brook University计算机视觉实验室。
它从光学信息入手,用偏振光编码的表面朝向信息,为 RGB 法线估计在复杂镜面反射等场景中的几何歧义补充物理线索,并以即插即用的方式接入现有 RGB-only 法线估计模型,无需重新训练原有主干网络。
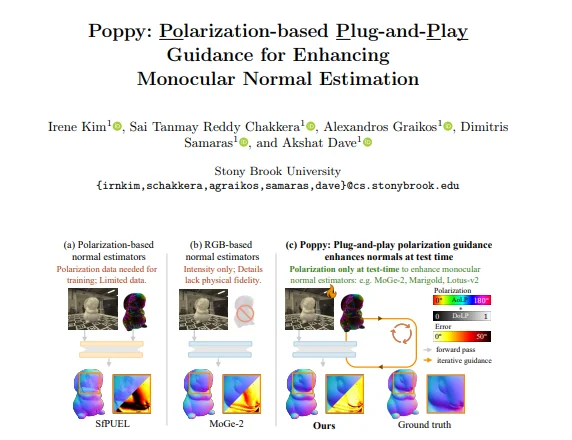
论文链接:https://arxiv.org/pdf/2603.27891
经典的 Koenderink 时间检验奖中,有一项给到了斯坦福李飞飞团队的《Perceptual Losses for Real-time Style Transfer and Super-Resolution》。
把它和今年集中出现的三维表示、几何理解放在一起看,计算机视觉关注的问题也在不断向外延伸:从图像看起来像不像,到三维结构怎么表示、真实世界里的空间关系怎么理解。
论文链接:https://arxiv.org/pdf/1603.08155
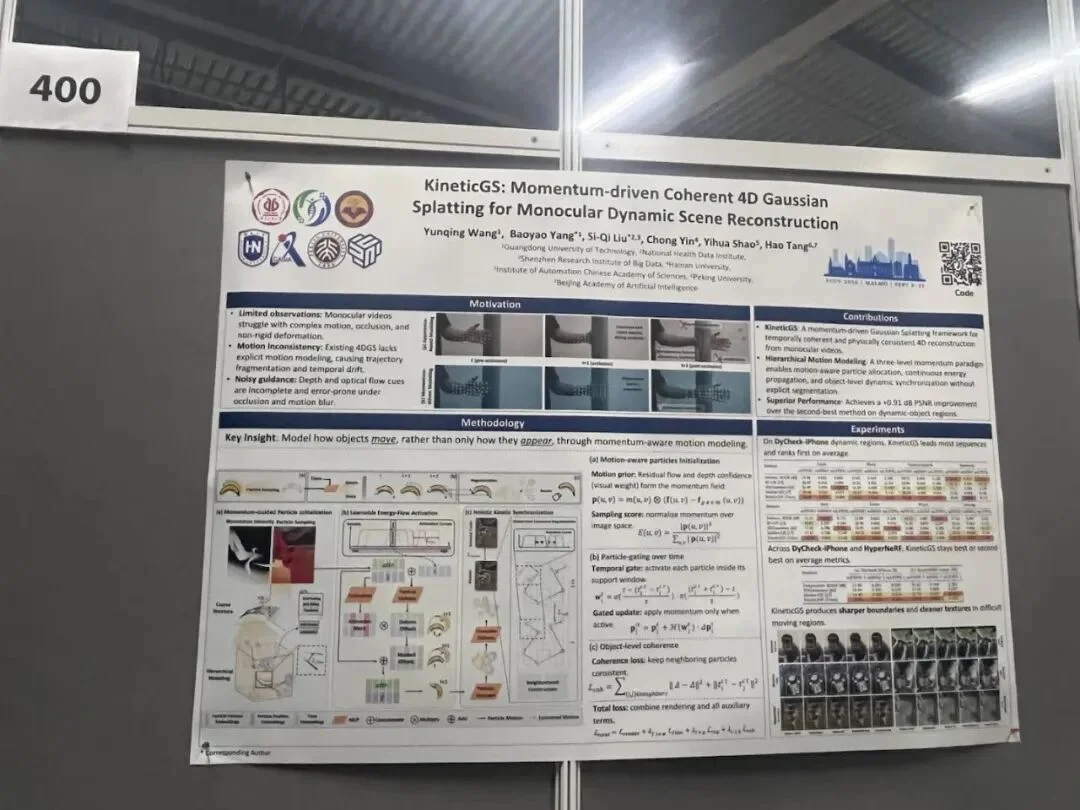
Poster 区的变化也很直观。首个 Poster Session 中,3D Reconstruction、Gaussian Splatting 与 Neural Rendering 占据了相当大的篇幅,现场大量工作围绕三维表示、重建和新视角生成展开。到了后续场次,相关问题又继续延伸到几何、运动、动态场景,以及 3D 场景理解、机器人和具身智能。
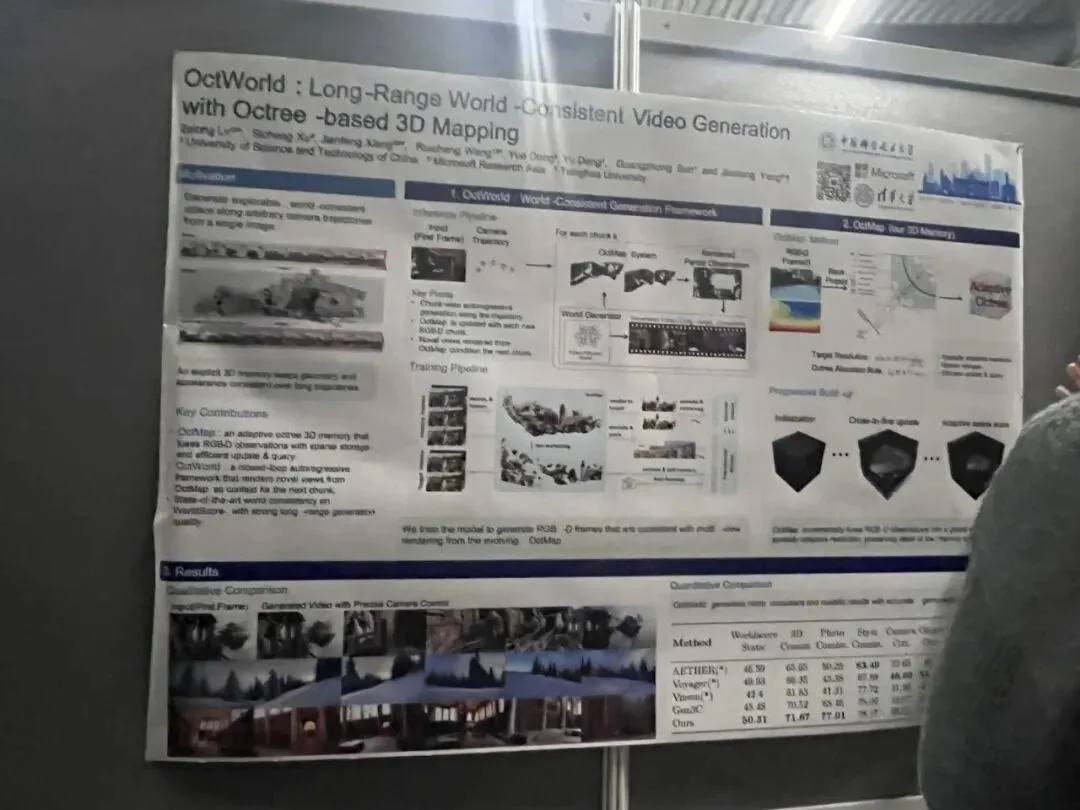
从这些论文可以看到,3DGS 已经不只用于追求更好的渲染效果,也开始被用于长序列建图、动态重建和更复杂的真实场景。
3D 视觉的基本问题仍然是几何、重建和场景表示,但研究对象已经开始动起来。人和物体会运动、遮挡和交互,模型也开始从静态三维表示,转向动态 4D 时空场景的建模。
02
时空记忆:
让模型持续理解同一个世界
理解一个会变化的世界,还要解决另一个问题:机器每换一个视角,都得记得刚刚看过什么。
机器人在房间里移动,相机视角不断变化,物体会被遮挡,也会离开画面之后再次出现。模型如果只能处理眼前这一帧,即使单帧看得再准,也很难形成对环境持续稳定的认识。
一个真正进入环境中的智能体,需要把不同时间、不同视角看到的内容连起来,在移动过程中持续更新对同一个环境的认识,并维持空间关系、物体位置和自身轨迹的一致性。
但现有不少视觉语言模型评测基准仍停留在静态图片或预录视频的“旁观者视角”,很难衡量智能体在持续移动中建立、更新和维持空间认知的能力。
针对这一缺口,群核科技联合浙江大学等团队提出了交互式空间智能评测基准 WalkerBench,让智能体只凭第一视角 RGB 视觉,在不同城市拓扑中完成主动探索和长程导航。
它剥离了 GPS、街名等先验信息,要求 Agent 依靠连续视觉观察理解周围空间关系并完成导航。测试中,随着探索步数增加,主流 VLM 很容易出现方向迷失:短程判断没有问题,但轨迹一长,就难以持续维持之前的路径信息和整体空间关系。
GitHub链接:https://github.com/lalayang123456-ctrl/WalkerBench
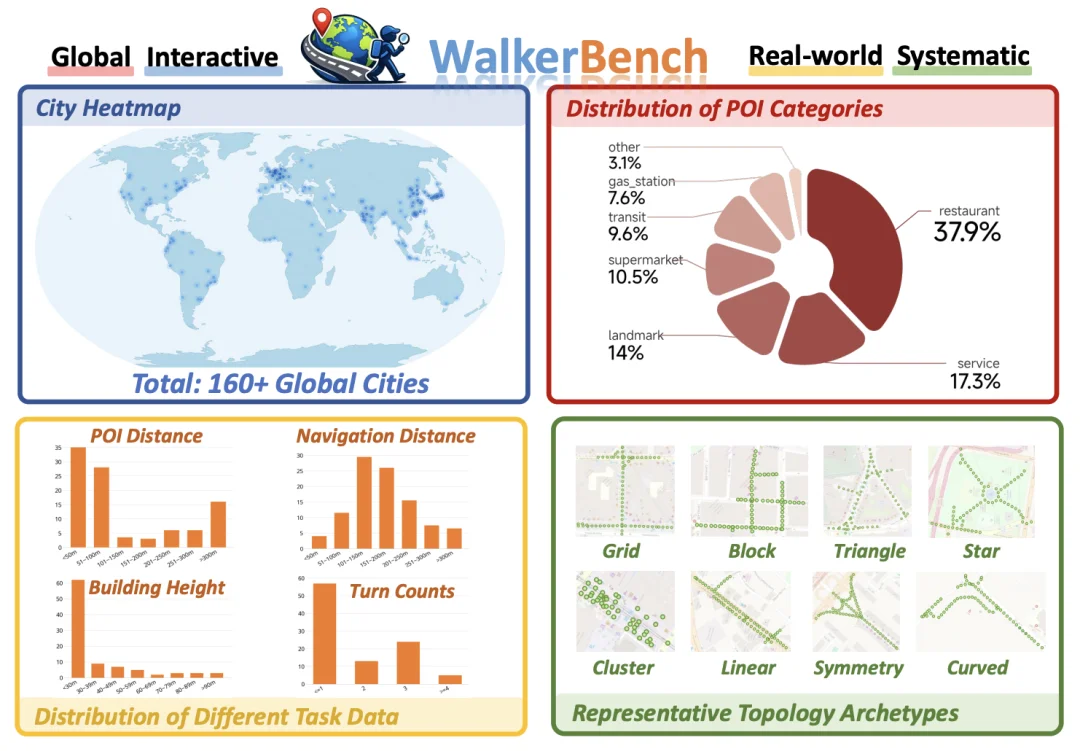
WalkerBench 概览
WalkerBench 不只把这个问题测了出来,团队也进一步提出了 Spatial-IDE。其中,ETM(状态外化与显式拓扑记忆)把智能体走过的节点、坐标、朝向、遍历历史以及语义注释等信息持续记录下来,形成一张动态更新的空间拓扑图;GDP(认知解耦与目标导向感知)则把全局路径规划和局部视觉判断拆开,避免越来越长的视觉上下文持续挤占模型的推理空间。
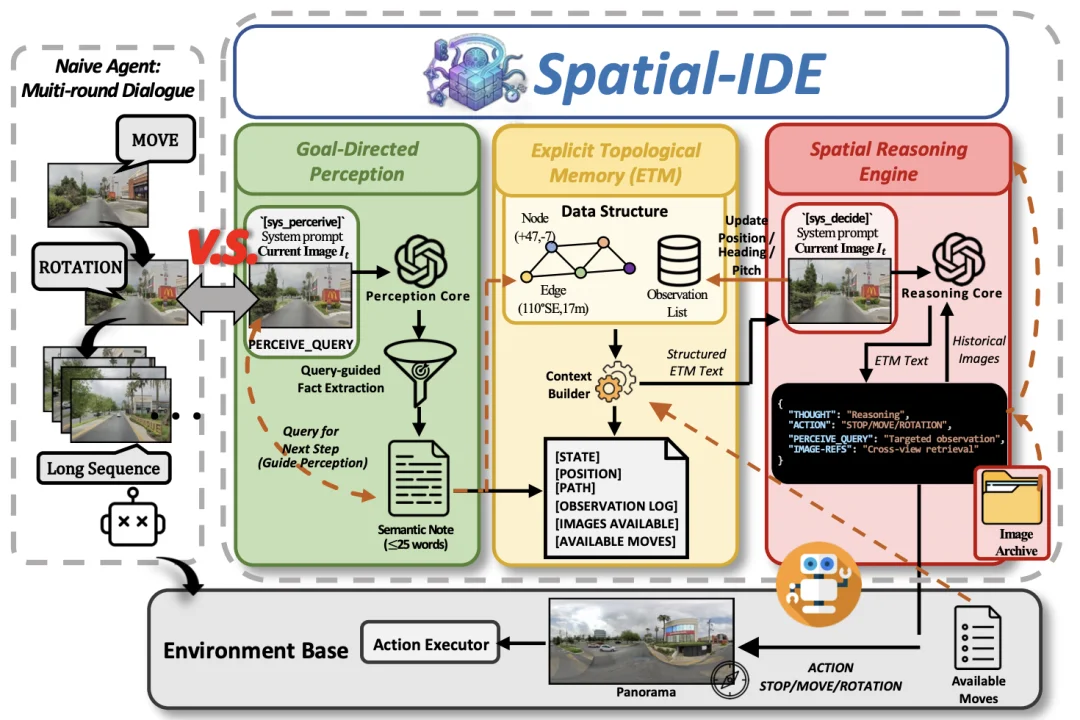
Spatial-IDE 框架
引入 Spatial-IDE 后,9 个主流 VLM Agent 的平均得分提升了 104.97%。团队还把这一框架部署到宇树 G1 人形机器人上,在真实开放街道中完成了连续多街区的千米级自主导航。
另一条路线,则尝试让这些空间信息直接沉淀到模型内部。
腾讯混元、清华大学和南洋理工联合团队提出的 Spatial-TTT,瞄准的就是长视频里的空间记忆。
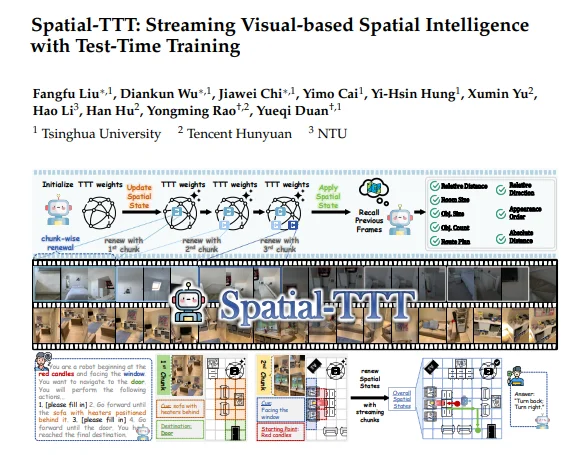
论文链接:https://arxiv.org/pdf/2603.12255
传统多模态模型处理连续视频,通常不断把新的视觉 Token 塞进上下文。视频越长,计算量越大,不同时间和视角中的空间信息也越来越难持续组织和保留下来。
Spatial-TTT 把一部分模型参数设计成可以在推理过程中持续更新的“快权重”,让已经看到的空间信息逐步沉淀下来。新的画面进来后,模型仍能保留之前的空间细节,以及不同视角之间的位置关系。
两条路线处理的是同一个问题:当智能体持续移动、视角不断变化时,怎样让它始终记得自己看过什么,并维持对同一个环境的连续认识。
能把过去的信息连续起来之后,下一步就是理解变化,并判断世界接下来会变成什么样。
03
状态预测:
从动态变化的表示,到未来状态的预测
现实世界不会停在被记住的那一刻。人会行动,物体会移动,机器人每执行一个动作,环境都可能进入新的状态。
场景一旦动起来,就会出现两个问题:一是怎样表示正在发生的变化,二是给定当前状态和一个动作,预测接下来会发生什么。第二个问题,正是世界模型越来越关心的部分。
在今年的 Keynote 演讲中,Yann LeCun 对这个问题讲得最直接。
图灵奖得主、前 Meta 首席 AI 科学家 Yann LeCun 在 Keynote 中,把重点直接放在了未来状态预测上。他反复强调,“模型根本就不该去预测像素”。相比生成未来画面的每一个细节,他更关心模型能否在抽象表征中预测未来状态,再根据不同动作可能带来的结果进行规划。机器人真正需要的,也不是一张目标图像,而是一个“目标状态”。
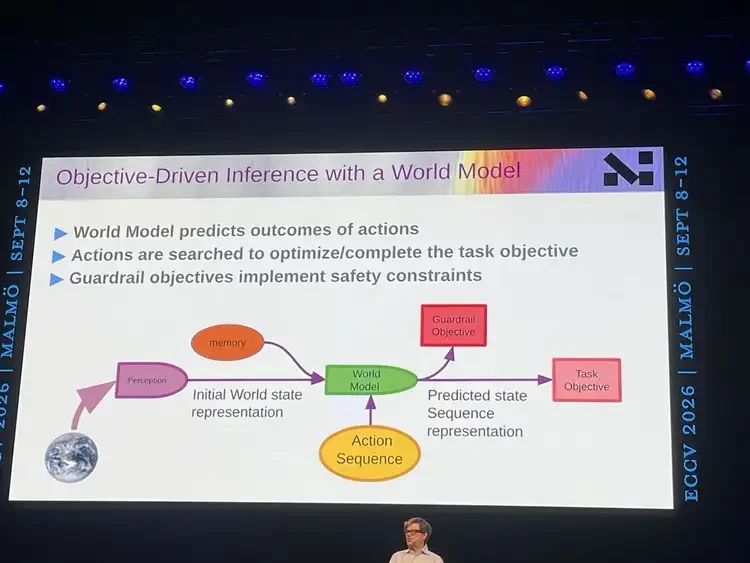
另一场 Keynote 中,Wayve 首席科学家、前微软 Mixed Reality & AI Labs 负责人 Jamie Shotton 则把讨论继续带向了真实世界中的感知和行动。他从早期视觉识别一路回顾到 Kinect的人体追踪、HoloLens的手部感知,再讲到今天的 Embodied AI 和 Wayve 的基础模型。他把自动驾驶作为具身智能的重要试验场:视觉系统真正进入物理世界后,面对的是持续变化的道路环境,也需要从识别和感知继续走向行动。
类似的议题,也反复出现在今年与 3D、世界模型和具身智能相关的 Workshop 中。
斯坦福大学助理教授吴佳俊长期研究世界模型与空间智能,在本届大会的相关分享横跨 Agentic Robotics、Multisensory Reasoning 和 World Model Evaluation;
香港科技大学教授、前阿里巴巴 XR 实验室负责人谭平长期研究三维几何与场景建模,这次也围绕可扩展 3D 场景重建与生成分享了最新工作。
慕尼黑工业大学教授 Angela Dai 也是