


过去几年,推理消耗的token爆炸式增长,token经济随之成型,推理专用芯片也持续升温:去年年底,英伟达以约200亿美元与AI芯片初创公司Groq达成技术授权协议,并吸纳其创始人Jonathan Ross等核心团队,被外界视为一次变相收购(acqui-hire);做晶圆级“大芯片”的Cerebras今年6月IPO,市值达到670亿美元;OpenAI联手博通,推出了首款自研推理芯片Jalapeño,从设计到流片仅用了9个月——加上我们之前聊过的谷歌TPU,推理芯片牌桌上的玩家越来越多。
这场推理芯片大战中,各家真正比拼的是什么?为什么走向了不同的技术路径?推理芯片未来又会向什么方向收敛?
本期硅谷101,我们请来两位AI芯片创业者,逐一拆解这些热门推理芯片在技术路径上的取舍与得失。其中嘉宾Mark是英伟达首席科学家Bill Dally的学生。Bill Dally是现代GPU并行架构最重要的奠基者之一。我们也借由Mark的视角,去了解这位芯片大师是如何思考问题和看待创新的。
以下是这次对话内容的精选:
泓君:今天跟我在一起的两位嘉宾,一位是负责推理芯片的硬件还有系统架构的Mark,还有一位是负责软件和编译器方向的子扬。大家要不要跟听众介绍一下,训练和推理对芯片的要求有什么不同?为什么可能需要两种不一样的芯片?
Mark:从成本角度看,这是商业模式决定的。训练本身没有直接回报,所以大家计算训练成本时,其实是在赌一个最强训练集群,做出最强模型,再靠未来推理把训练投入收回来。
但推理在商业上很容易算账:用户愿意为每100万个token付多少钱,我推理出这100万token要花多少成本。成本包括买GPU、消耗电等。所以推理追求的是性价比,而不是极致性能,会把成本更多考虑进来。
比较有意思的是计算密度,英文叫“arithmetic intensity”,它的缩写正好也是“AI”。训练时有海量数据,有足够并行度,可以把多余算力充分利用起来。但推理时,语言模型被认为是一个强逻辑过程,逻辑需要一定顺序完成。
所以语言模型token生产的过程,在推理里是严格意义上的线性的、或者说是严格意义上自回归的。我必须先知道当前token推出来的结果,再把它作为输入喂给模型,它才能告诉我下一个token是什么。
推理分两个阶段:prefill(预填充)阶段,有很多token可以并行处理;但decode(解码)真正产生token时,必须一个一个生成。而每生成一个token,都要把整个模型(比如1.6T参数的模型),从存储介质读到计算单元里。所以推理,尤其decode阶段,对算力和带宽的需求发生了本质变化。
泓君:我可不可以理解成,GPU在训练部分核心解决算力,在推理部分核心解决内存带宽?
徐子扬:更准确地说,训练和推理的prefill阶段,所有token都是已知的,可以用大量并行度,读取一次数据后同时做很多计算。GPU硬件本身,需要你同时做大量运算,才能把它的硬件资源用满。在这个比例下,带宽其实是不足的。
泓君:给听众一个更形象的例子吧。比如我给大模型一个问题,让它出一个采访提纲。用户把提示词输进去,它开始推理、写提纲,会用到多少GPU或推理芯片?用GPU和用专业推理芯片,在延迟、成本上有什么不同?
Mark:prefill阶段有充足并行度,只要把模型从GPU的HBM(高带宽存储器)里读到计算单元一次,就可以把你喂给它的东西同时处理完。这可以带来足够并行度,让GPU充分利用算力。
但到了decode这块,比如它要说“好的,下面是我为你准备的一份采访提纲”,这句话里每一个token、每一个词,都意味着你要把模型从存储介质里读上来一遍。读取模型次数上,大家可以清楚感受到:是一句话读一次,还是一个词读一次,读的量都是整个模型权重。
GPU不能接受把模型从HBM读到计算单元后,就只处理一个用户的token。所以它真正做的是batching(批量化处理)。它要收集1万个用户不同的推理任务,并行地把这1万个用户里的第一个词、第二个词、第三个词一起推理出来。所以从用户角度会感受到:为什么我这里推一个token这么慢?因为用GPU做这件事,你不光在等GPU推理你自己这一个token,还在等同一批里其他9999个用户的token。
GPU这种大算力密度,用HBM提供非常昂贵的带宽,导致用户体验上,不管Agent场景还是reasoning自己思考的场景,推理速度都有比较强的限制。
泓君:那如果用推理芯片呢?
Mark:推理芯片是一个非常泛的词,分太多种了。推理本身也足够复杂,分为prefill、decode;decode里因为模型不同,还分attention、FFN。
我们认为,未来理想的推理系统可能包含很多种不同芯片,能把实际decode token这个过程做得足够便宜、足够快。这可能是需要打破GPU传统架构,做更有针对性的新架构,以及使用不同于HBM的其他介质的意义所在。
泓君:从现在市面上这些说自己做推理芯片的公司来看,你觉得做得最好的是哪家?Groq怎么样?
Mark:Groq、Cerebras都在这条技术路线上。我觉得大家看到了正确的问题,它们确实已经把东西做出来,而且像Groq现在和英伟达配合的关系,确实是我们设想中比较理想的状态:GPU处理哪一部分任务,然后Groq处理哪一部分任务。
所以在大的方向上,尤其英伟达收购Groq之后,更好地做异构推理系统这个角度来讲,其实我现在是比较看好Groq的这条技术路线。
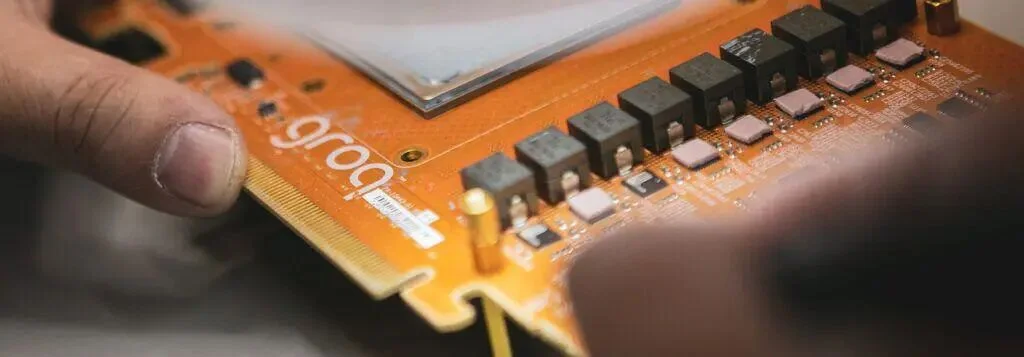
Groq LPU推理卡 图片来源:Groq
泓君:可以展开聊一下吗?
Mark:我觉得最关键两个点,第一,怎么提供高性价比带宽。包括我们最初想做现在这个项目,也是因为看中了有远比HBM要好两三个数量级、带宽性价比更高的介质。
这种介质的关键不在介质本身,而在于你要关注局部性的问题。你要提供比HBM更高一层的局部性。HBM是把存储和计算放到一个封装里,所以它的带宽能做到很高。但我们希望把局部性提升到下一层:把存储直接放到计算芯片里面。
带宽的核心是连线的密度及频率。当你把线从封装走线,变成计算芯片内部光刻出来的线,这两种线,在密度、成本、包括能耗上面,都有本质差别。
如果有些介质能让我把模型权重放到计算单元或计算芯片上,那就是质的提升。这是解决带宽问题最本质的方法。而SRAM(静态随机存取存储器)只是刚好目前阶段最成熟、最可靠、可以让你有机会把存储放到计算芯片里的一个方式。
泓君:现在Groq是这种方式吗?我知道你们要走这样的方式。
Mark:是,Groq也是这种方式。另一个关键点是“异构”。我觉得Groq比Cerebras稍好一点,就在于它和GPU可以更好地结合起来。因为推理不是钢板一块,里面有算力密集的部分,那部分GPU做得也很好。如果你未来的系统能把异构这个点做得比较极致,那么在芯片以外的系统层次,我觉得会有更大优势。
徐子扬:刚刚的讨论,都是围绕着云端的推理芯片。推理芯片是一个巨大市场,云端的、边侧的,大家各有侧重。大家都要获得相对低廉的带宽。但端侧有物理空间上、功耗上的限制,这就导致了在端侧上面,我们可能还会看到其他一些思路,比如3D DRAM(三维动态随机存取存储器)。其实很多思路都在提供更高、更便宜的带宽,包括所有HB开头的词,HBM、HBF……都是想把原先的介质做到更高的带宽。
泓君:我先花一点时间解释一下我们这期要频繁提到的三个词:SRAM、DRAM还有HBM。最简单的理解方式就是,它们都是存储数据的地方,但是区别就是说,离干活的地方有多远。
DRAM是你电脑里面的内存条,它能装很多,但是离得远,来回取数据要花时间。
HBM,它是把DRAM搬到了计算芯片的旁边,而且还开了很多条通道,所以它的容量大,速度也快,现在英伟达的高端GPU用的就是它。那它的代价是什么呢?就是贵,而且全球的产能非常紧张。
SRAM不一样,它可以直接做在计算芯片里面,所以它其实是最快的方案,快很多,但是它有一个致命的缺点,就是太占地方。存同样多的数据,SRAM需要的芯片面积是DRAM的几十倍、上百倍。
所以我们总结一下就是说,DRAM它的方向是便宜,但是慢;HBM快,但是贵,而且抢不到货;SRAM最快,但是它装不下。
徐子扬:在云端场景,对整个系统铺多大,没那么大限制,只要它能给我们提供足够吞吐。我们会从更本质的角度考虑:什么样的物理介质能提供最密的连线和最高带宽?我们找到的是SRAM。
Groq和Cerebras这两家公司,本质上它们的速度和可能的性价比都来自于SRAM,尽管它们没有着重强调这一点。其他一些美国AI推理芯片创业公司,包括d-Matrix、MatX,也在往SRAM方向走。并且谷歌TPU、亚马逊Trainium,如果我们去看现在所有发布的芯片,每一代SRAM都是变得越来越大的。
SRAM和现有的其他存储介质相比,从带宽角度,无论绝对数量,还是每块钱能买到的性价比,都非常高。所以我们能看到,大家都在往这个方向收敛。
泓君:可不可以一句话总结Cerebras?它相当于在一个巨大晶圆上做一整块的芯片设计。它的优点是什么,缺点是什么?和Groq相比,它的优劣势和trade-off是什么?
Mark:我觉得可以以一个更统一的视角,去看大家做的这些事情。以Cerebras和Groq为例,它们在Transformer出来之前,就预见到未来可能有一部分AI系统对带宽有非常大需求。大家都经历了同样的思考过程:怎么把带宽做得更便宜、更高,最后发现SRAM是比较好的介质。
但做这件事有trade-off。你要跳出local minimum(局部最优),就要损失一点东西。SRAM损失的是单芯片容量。DRAM是一个晶体管加一个电容存一个比特;SRAM需要六个晶体管,所以存储一个比特的代价更高,一个芯片上能做的容量会变得很低,可能比HBM要低两个数量级。
大家都发现了这一点,怎么提升容量呢?最简单直接的就是,你要把系统做得更大,做几百个、几千个芯片,单纯就为了把所有模型权重都放到六个晶体管的SRAM里。放是都能放下,只要系统够大。但问题在于,先放下了,如果它就在里面存着,并不能产生token。你得用另一种方式把它读出来,并且做有效的计算。
这时候大家会发现,当你系统足够大之后,很多计算或整个系统效率的瓶颈就卡在通信上。大家的思维实验其实都做到了这一步。这时候Cerebras和Groq开始分歧了,大家用了两条不同技术路线,来解决大集群通信调度问题。
Groq的思路是:实际调度如果放在运行时做,开销往往会很大,它希望把调度放在运行之前,也就是编译器这个时间点,把未来芯片系统里可能做的所有计算、通信都想明白了。哪个使用周期做什么计算,哪个周期开始通信,都排布好之后,实际运行时就没有调度问题了。这某种程度上缓解了集群变大之后调度成为瓶颈的问题。
Cerebras更简单粗暴:之所以集群通信有代价,是因为一个柜子里几百个芯片,大家总是有物理距离的。那如果把一个柜子的事情塞到一个大的wafer(晶圆)上,那物理距离、线的带宽,自然都会变得更好一些。
但在我们看来,他们在做各自技术决策的时间点,没有足够信息来支撑他们来判断未来具体需要面向哪样的workload来优化,因为那时Transformer还没出来。
Cerebras最后可能面临的大挑战,是如何控制整个wafer的良率以及成本;Groq则是在做出“依靠编译器做完全静态调度和编译”这个选项时,没有办法预先知道现在语言模型Transformer推理里有如此大的动态性,比如MoE(混合专家模型)的产生,这与它当时的技术选择并不那么匹配。
泓君:可以详细解释一下吗?
徐子扬:MoE这样一个网络有非常多的专家。每一个token在推理时,会去激活专家里的一小部分,这一小部分是在运行时决定的,随着不同的token在选择,比如在128个专家里选8个,这件事你没有办法在编译时预测。
现在的单颗SRAM是没有办法把整个网络都放进去的,一定会出现有些专家在一部分芯片上。这里就有调度问题:我要把这样的token送到哪一颗芯片上?这本身有一定的动态性。
如果想用一个静态的方式解决这个动态性,一种思路是,我非常保守,我把它都送过去,那有些芯片就在空转。另一种解决方式是换一种方法切模型。我们推演过,如果不用专家去切分这个模型,现在这个模型的大小很难用其他的几个维度把它切得很干净、很高效。所以这个动态性就变成了它的静态调度的很大问题。
泓君:我印象中MoE是在DeepSeek发布后变得非常主流,引起大家强烈关注的。但英伟达acqui-hireGroq是在2025年底,它应该也能看到这些问题。它当时为什么会做出“收购”的决策?大家有没有一些相关的消息跟推理?
徐子扬:用一个保守的思路去想,它会有一些芯片空转,但这只影响性价比,不影响我能做到很快这件事。现在市场对Groq和Cerebras的定位其实就是快,性价比没有被拿到台前那么多讨论。现在整个商业逻辑是这样的:如果我做推理比别人快几倍,比如我现在是100 token每秒,但是拿Cerebras能做到750甚至2000 token每秒,那我可以为此付很多溢价。
SRAM和HBM相比,性价比有两到三个数量级优势。所以我们在做整个系统时,其实可以浪费掉一个数量级。牺牲掉的就是它为了解决MoE去做技术上的一个trade-off。从带宽角度来说,性价比还是更高的。
Mark:从商业的角度来讲,别人如果愿意为更快买单,你不会主动告诉别人,你的成本其实是更便宜的。
泓君:所以Cerebras跟Groq,谁更贵?
Mark:我认为是Cerebras。
泓君:Groq创始人Jonathan Ross,也是谷歌TPU的核心设计者之一。他在设计这两套架构时,核心关注点有什么区别?
徐子扬:整个Groq的思路是围绕着编译器发生的。因为Jonathan Ross本身也是编译器团队的leader。他出来做这件事的思路,就是把确定性编译做好,然后围绕这个编译去设计硬件。所以就从静态编译和静态调度出发重新设计了硬件。
刚刚说的静态调度是一点,还有另外一点是determinism(确定性)。比如我们从存储介质里面把东西读出来,是100纳秒后出来,还是300纳秒后出来,会有一个抖动。这个抖动在DRAM中更明显。当它用了SRAM,再加上芯片设计,它其实是把确定性做到极致,也把静态时钟同步做到极致。这一切都围绕着:最后我能在编译器看到整个系统,并为它做这么样一个排布。
但是,他创业的时间点,有一些特性。2016年Groq成立,最开始想做很多图像、语音,但他们一直想做推理。在那个时代,模型和今天Transformer、MoE出来以后是不一样的。包括一些动态性,在那个时间点和今天,它的需求是不一样的。
泓君:我们刚讲到,Groq和Cerebras都有一些时代局限性在里面。它们创业的时间点,生成式AI和大模型还没出来,深度学习在整个业界是一个比较主流的方向,但是不是以Transformer为主,我们不知道。像Groq,当时也无法预测未来会和MoE有一点不匹配。
那Cerebras为什么成本比Groq还高?它从创业到现在,将近9到10年后,又站到了大家关注的焦点上。你们觉得在这中间它调整了什么?做对了什么?
Mark:我为什么刚刚第一反应是它的成本会比Groq高。首先,从技术路线讲,它需要以整个晶圆的规模去生产它的产品。这会遇到芯片生产过程中非常关键的一个参数——良率。
传统上,比如现在设计芯片,单芯片尺寸极限差不多800mm²,一个晶圆上可以切出40个类似芯片。良率会影响切出来的芯片有多少是好的。如果没有做任何partial good的设计,良率50%,可能就切出20个好的。
但如果单一产品尺寸就是整个wafer,Cerebras会做很多事情在于,我接受芯片上30%的单元都是坏的,仍然让产品能用。但这时候仍然和大概率40%、50%都是坏的这个良率是不匹配的。而且一旦整个晶圆达不到良率的需求,整个晶圆就作废了。这意味着,你要制造出一个成功的晶圆级产品,成本是非常非常高的。
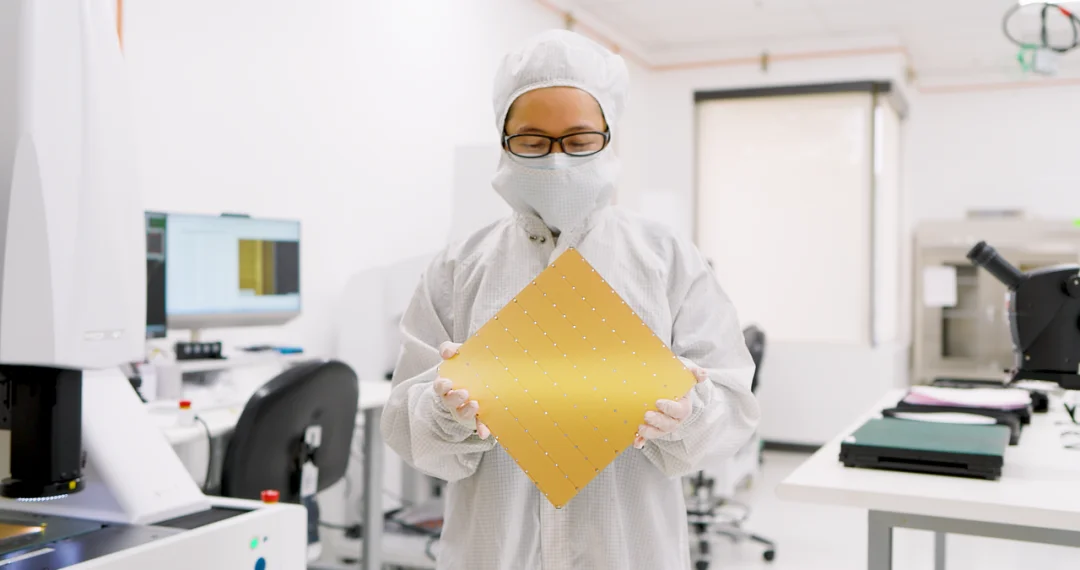
Cerebras WSE-3 晶圆级芯片 图片来源:Cerebras
徐子扬:除了良率,Cerebras还有一个问题,整个系统要为这个和其他芯片完全不一样的设计做改变。比如软件上,整个晶圆上可能有几十万个小core,坏了哪些部分能绕过去;如果坏在关键部分怎么办?这些事情之前都没有针对这样一个系统研究过,所以它首先要解决软件问题。还有你这个系统要怎么插到机柜里,也有一些额外事情,它都要自己解决,因为它可能是现在唯一一个比较有名的晶圆级生产商。
M