


从月饼产线到灯火夜市,看旷视OpusDet如何以文本、视觉与混合提示覆盖多样目标与场景。
传统目标检测通常围绕训练阶段预设的类别工作,而万物检测允许用户在使用模型时,通过文字或图像直接指定要检测的目标。输入“灯笼”,模型可以在画面中寻找灯笼;给出一枚月饼作为视觉样例,模型可以检出与它外观相近的目标;当单一提示不足时,文字与图像还可以组合使用。旷视算法团队近日开源的轻量级万物检测模型OpusDet,将文本、视觉与混合提示统一在同一套检测框架中,使同一个模型能够应对不同场景下类别、形态和状态各异的目标,并兼顾检测精度与推理效率。一种模型,三种提示
文字、图像,或二者共同提供线索
有些目标可以通过类别名称直接说明;有些目标的外观特征难以用语言准确概括,给出一个图像样例会更加直观;还有一些高度相似的目标,需要文本语义与视觉线索共同参与判断。OpusDet将三种提示方式收进同一套算法框架,用一个模型完成多种形式的提示检测。
文本提示 ·Text Prompt
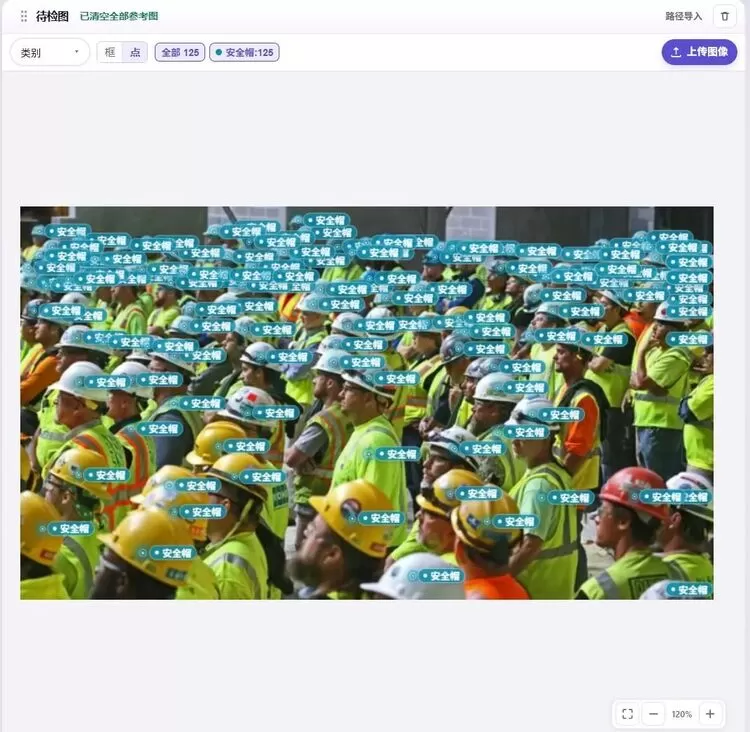
图示:写下“安全帽”,模型便可在密集人群中找到对应目标
视觉提示 · Visual Prompt
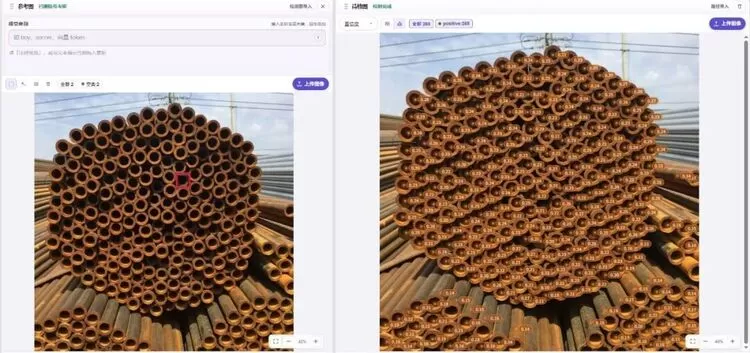
图示:框选一处钢管断面,模型据此检出并清点画面中的同类目标
混合提示 · Mixed Prompt
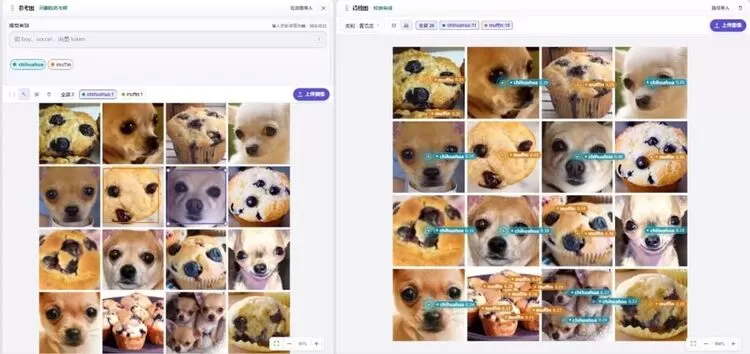
图示:当名称不足以排除相似外观,文字与视觉示例组合可以实现更准确的判断
从整线计数到口味区分
中秋前后的月饼产线,为多种提示能力提供了一个直观的应用场景:输入“月饼”这一文本类别,可以完成整线检测与计数;进一步给出蛋黄莲蓉与桂花奶心的实物样例,模型还可以依据外观完成口味区分。
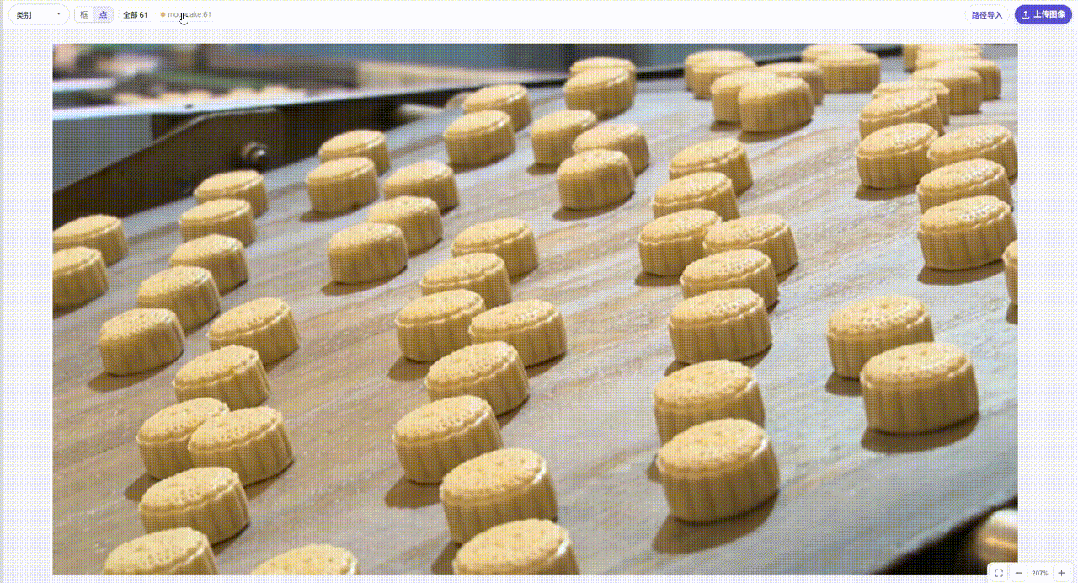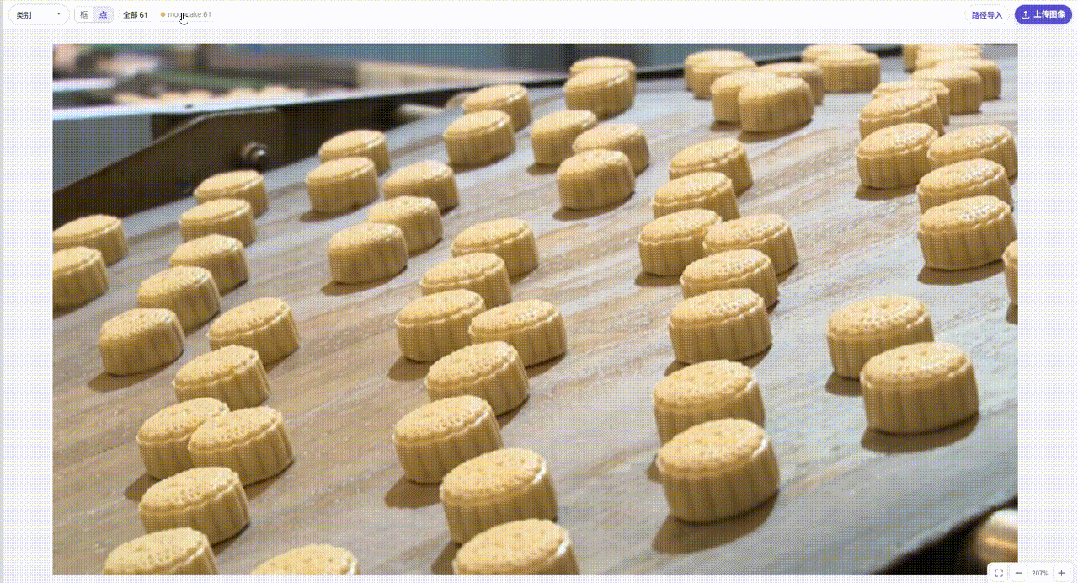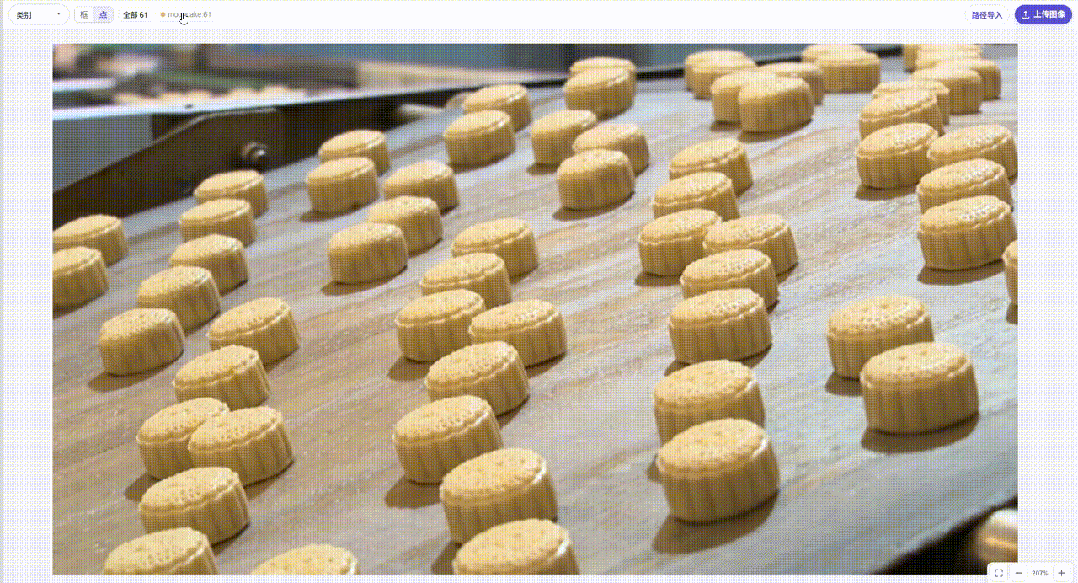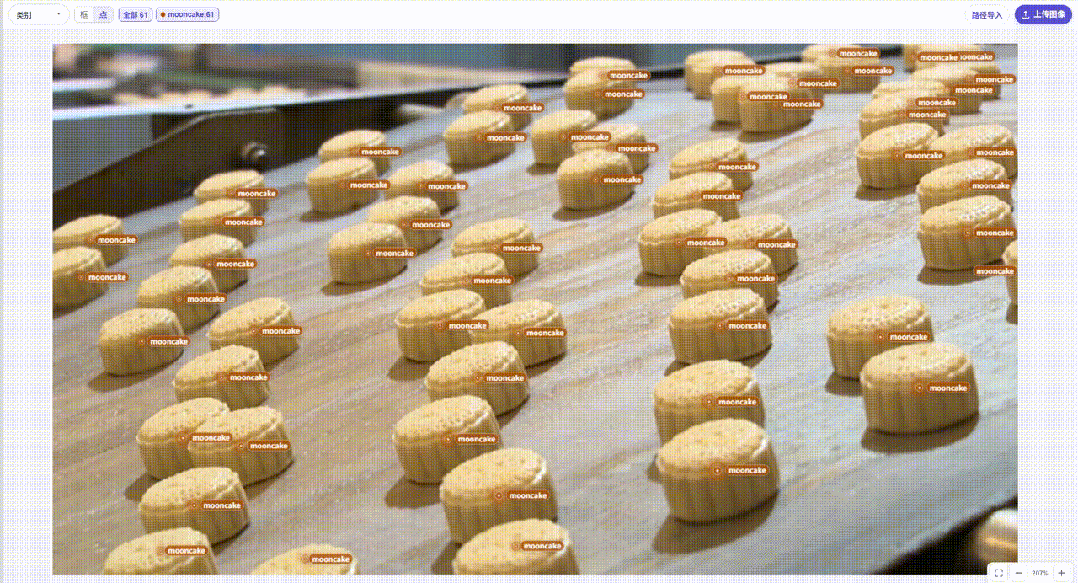
图示:以“月饼”为文本提示,检出传送带上的目标并同步计数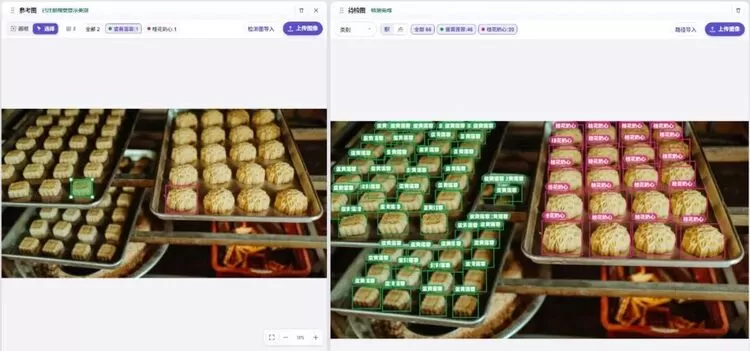
图示:各给出一枚蛋黄莲蓉与桂花奶心月饼作为示例,模型按外观完成分类计数
一种能力,多种场景在开放环境与工业现场中检验万物检测的场景适应性
月饼产线展示了OpusDet对目标类别、数量和外观差异的检测能力。将视野扩展到更多场景,模型还需要面对低照度、遮挡、密集排列以及细微状态差异等不同挑战。接下来,我们通过夜市与工业现场中的一系列案例,进一步展示OpusDet的万物检测能力。
灯火之间的多目标检测——文本提示
夜色让中秋的灯火更通明,也让检测变得更难:目标密集、尺度不一,遮挡与低照度同时存在。依次输入“灯笼”“行人”“招牌”等文字提示,模型便可在同一场景中切换关注对象。
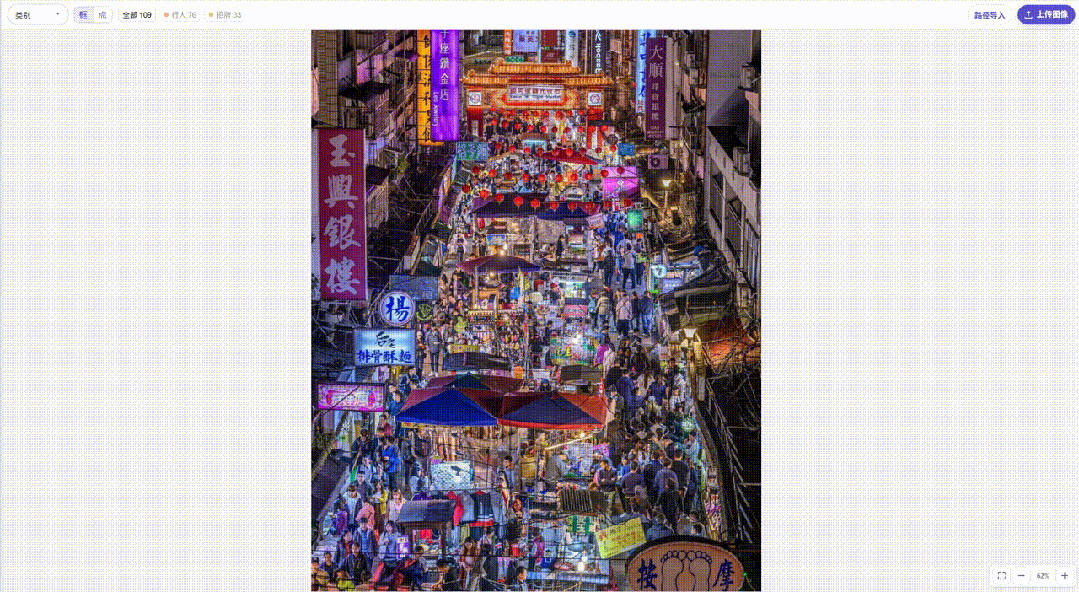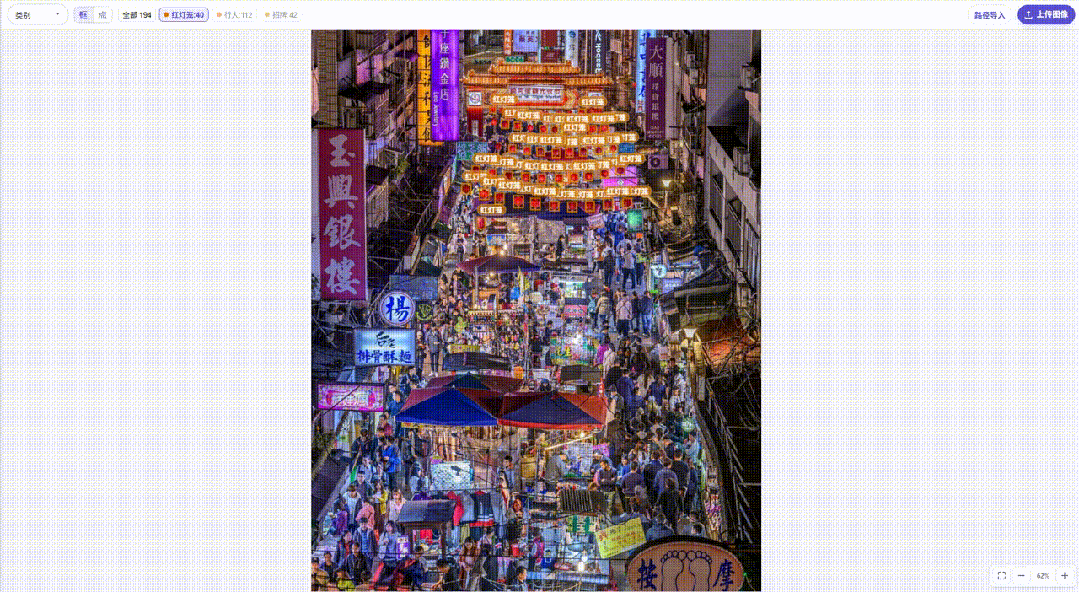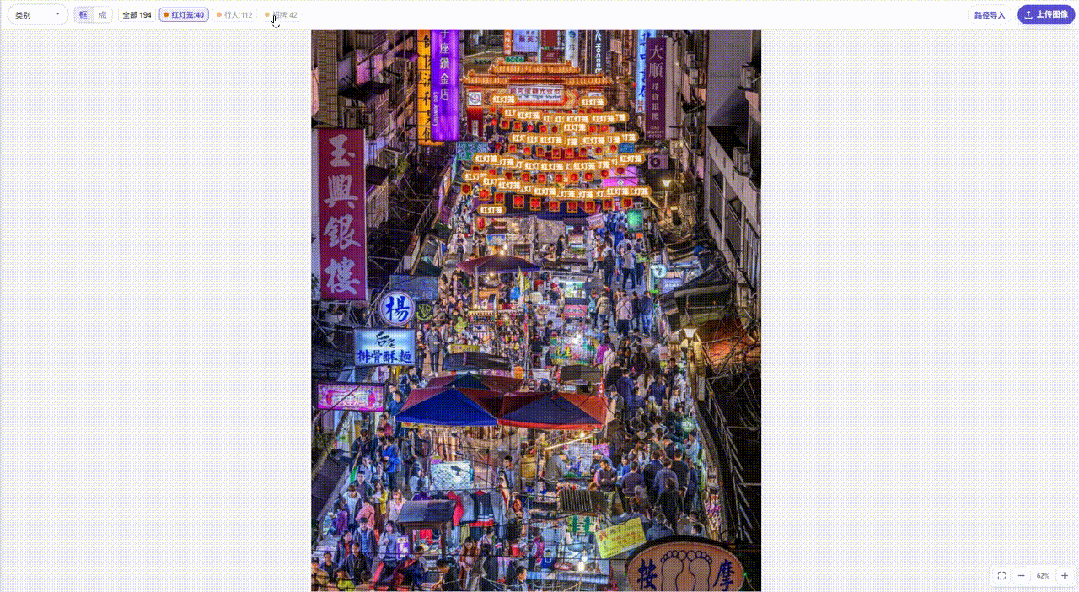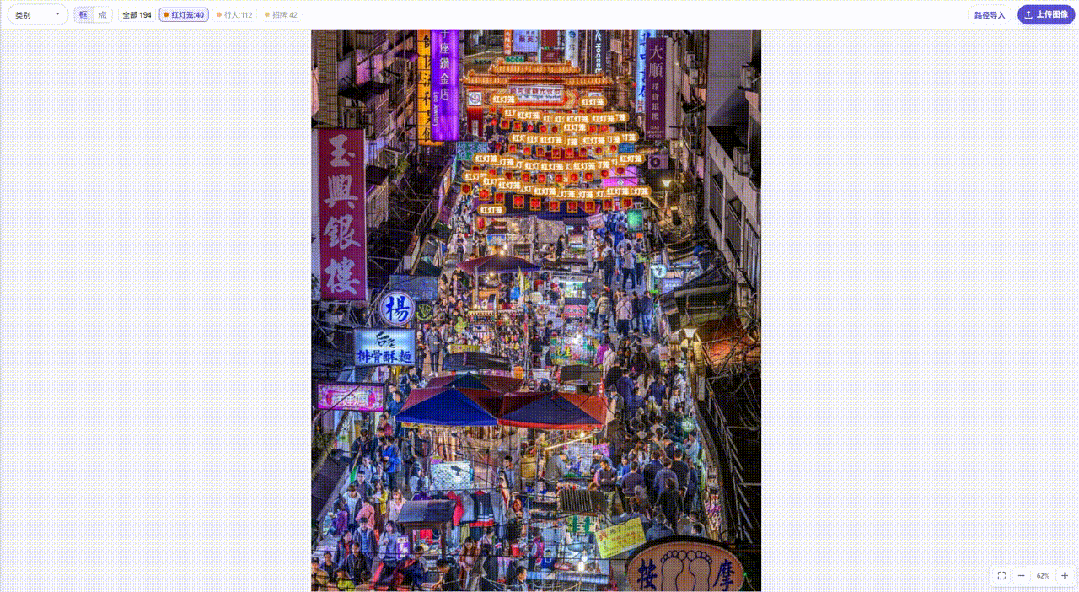
图示:同一段夜市画面,随文本提示切换检测对象并完成计数
夜市集中呈现了开放环境的复杂性;在工业现场,检测难点则表现为另一种形态:缺陷难以准确描述、零件高度密集,不同状态之间有时只相差一处细节。面对这些任务,视觉示例可以直接成为模型定位和区分目标的依据。
用示例定义缺陷——视觉提示
缺陷往往具体而细微,很难仅凭文字穷举。给出一处“缺孔”的图像示例作为参照,模型便可在整块PCB上寻找具有相同外观的异常。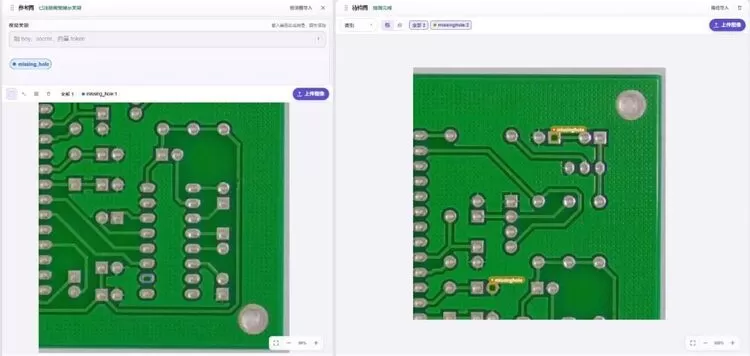
图示:左:注册“缺孔”视觉示例;右:整板自动定位同类缺陷
密集目标分类计数——视觉提示
面对托盘中密集排列的孔位与螺杆,类别名称提供的信息有限。分别框选一个视觉样本后,模型即可依照示例完成全图分类与清点。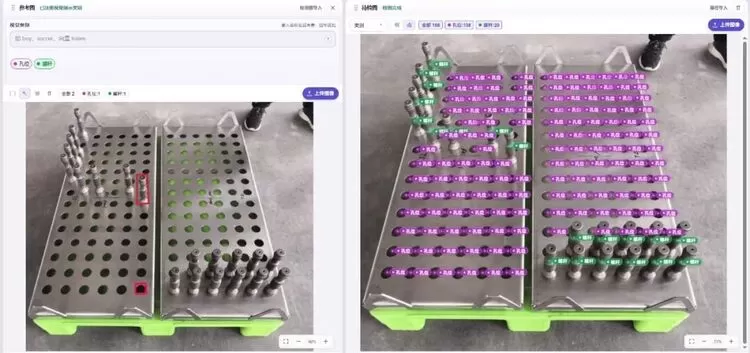
图示:以“孔位/螺杆”为视觉示例,完成密集目标的分类计数
识别药品状态差异——视觉提示
将“有药”与“空泡”分别作为视觉类别,模型逐格判断泡罩板的装填状态,为漏装质检提供直观结果。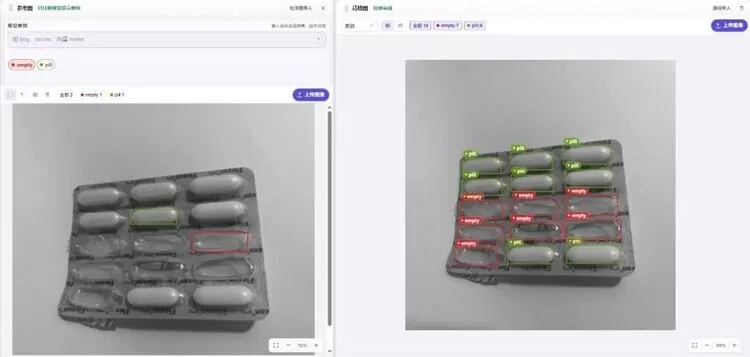
图示:泡罩板逐格判定有药/空泡,快速识别漏装
从提示覆盖到推理效率灵活性、泛化性与推理效率的综合验证
要系统评价一个万物检测模型的综合能力,需要同时观察三个方面:不同场景下能否灵活修改提示形式,在不同数据集上的表现是否稳定,以及推理速度能否满足实际使用。OpusDet采用强语义编码器、单阶段“文本—视觉”对齐训练(ICA),在统一处理多种提示的同时大幅减少计算开销。
OpusDet同时支持视觉、文本以及混合提示,并且在各数据集上均达到了领先的指标;与此同时,其推理速度也极具竞争力:
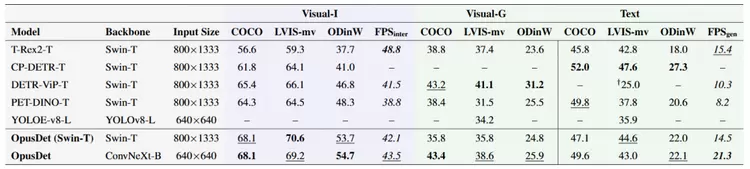
推理速度 · FPS
从推理速度上来看,OpusDet达到21.3FPS,相较T-Rex2-T的15.4 FPS和PET-DINO-T 的8.2FPS,分别提升约38%和160%。
结语从文本描述到视觉样例,再到两者共同提供线索,OpusDet用同一个模型覆盖了多种提示检测方式。在月饼产线、夜市场景和工业质检等案例中,OpusDet展现出对不同目标、尺度、光照和外观差异的适应性;在COCO、LVIS-mv与ODinW35等基准上的结果,则进一步验证了模型在提示覆盖、跨数据集泛化和推理效率方面的综合优势。OpusDet已开源,期待与研究者、工程师及合作伙伴一起,将灵活而轻量的万物检测能力带入更多场景。